یک تیکت پشتیبانی که به بخش اشتباه ارجاع داده شود، شکست در قضاوت است، نه شکست در دستور زبان. TypeSafe AI در ۲۶ سپتامبر ۲۰۲۶ مدل Jev را عرضه کرد تا با جایگزینی متون باز با تصمیمات محدود، این مشکل رایج را حل کند.
بسیاری از توسعهدهندگان در حال حاضر از مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — برای دستهبندی دادهها استفاده میکنند و از آنها خروجی JSON میخواهند. تصور کنید یک گردش کار پشتیبانی فرضی را در نظر بگیرید که در آن مشتری پیامی میفرستد: «از من دوبار هزینه گرفتید، ایمیل زدم و کسی جواب نداد». برنامه شما سه بخش دارد: مالی، پشتیبانی فنی و فروش. توسعهدهنده پیام را به مدل میفرستد، دستهها را توضیح میدهد، یک طرح JSON (Schema) را مشخص میکند و منتظر میماند تا مدل خروجی { "department": "billing" } را تولید کند.
اگرچه فرمت خروجی ساختاریافته است، اما فرآیند زیربنایی همچنان مولد (Generative) است. مدل نیازی به ابداع یا اختراع چیزی نداشت چون تمام پاسخهای ممکن از قبل در برنامه موجود بود. این موضوع یک سؤال مهندسی را ایجاد میکند: وقتی خروجی صرفاً یک انتخاب است، ما واقعاً به چه مقدار از ماشینافزار مولد نیاز داریم؟ در حال حاضر مدلها اساساً در حال حدس زدن توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی که مدل تکهتکه میخورد — برای تطبیق با یک طرح هستند که این کار از نظر محاسباتی گران است و مستعد خطاهای معنایی است.
مدل Jev به عنوان یک مدل «سیستم یک» عمل میکند. این مدل به جای تولید متن، ورودیهای نامنظم را مستقیماً به مجموعهای از گزینههای ثابت متصل میکند. با این تغییر، نقش هوش مصنوعی از یک نویسنده به یک طبقهبندیکننده تبدیل میشود که برای انتخابهایش تخمینهای احتمالی ارائه میدهد. همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی هزینههای استنتاج اشاره کردیم، فرصت اصلی در اینجا تشخیص این است که کدام بخشهای یک برنامه واقعاً به تولید متن نیاز دارند. این رویکرد در واقع تکامل یافتهی همان ایدهای است که در گزارشهای اولیه از مدل Jev برای کاهش هزینههای استنتاج به آن پرداخته بودیم. در حالی که ایجاد یک منوی کشویی (Dropdown) ساده است، اما درک معنای پیام دشوار است.
پیچیدگی قصد کاربر
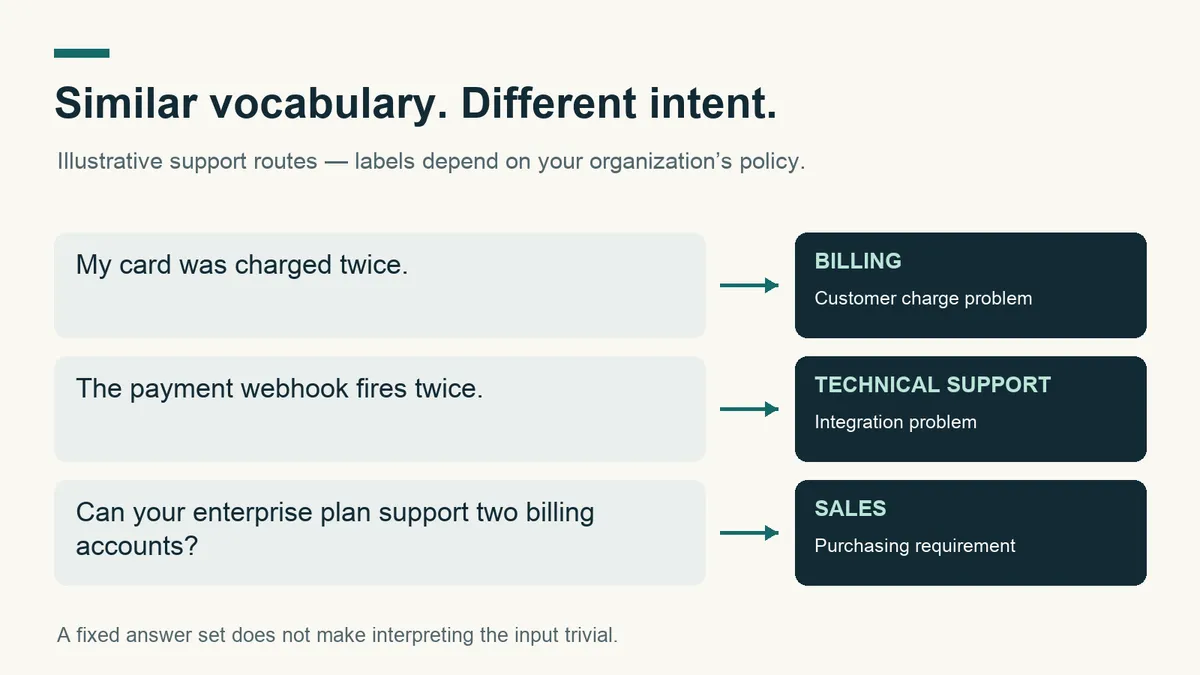
داشتن فهرستی از پاسخهای ثابت، کار را بدیهی یا ساده نمیکند. سه پیام زیر را در نظر بگیرید:
- «کارت من دوبار شارژ شد.»
- «وبهوک پرداخت دوبار اجرا میشود.»
- «آیا طرح سازمانی شما از دو حساب مالی پشتیبانی میکند؟»
هر سه پیام به «پرداخت» اشاره دارند. یک قانون ساده بر اساس کلمات کلیدی، هر سه را به بخش مالی میفرستد. اما یک مدل کاربردی باید «قصد» (Intent) کاربر را تفسیر کند تا یک مشکل مالی را از یک باگ یکپارچهسازی (Integration Bug) یا یک سؤال مربوط به خرید تشخیص دهد. در اینجا قضاوت آموختهشده مدل کمک میکند، اما این قضاوت نیازی نیست به شکل متن تولید شده ظاهر شود. برای وظایف محدود، برنامه از قبل واژگان خروجی را میشناسد؛ برنامه فقط به یک نگاشت (Mapping) قابل اعتماد از ورودیهای نامنظم به آن گزینهها و یک نشانگر مفید از عدم قطعیت نیاز دارد.
مکانیسم تصمیمات محدود
مدل Jev برای مدیریت نیازهای منطقی مختلف از سه نوع پرسش اصلی استفاده میکند:
- Choice (انتخاب): محتملترین گزینه را از یک لیست پیشفرض انتخاب میکند (مثلاً ارجاع تیکت به بخش مالی، پشتیبانی فنی یا فروش). این مدل توزیعهای احتمالی و یک آمار اطمینان (Confidence Statistic) را برمیگرداند.
- Score (امتیاز): ورودی را بر اساس یک معیار (Rubric) رتبهبندی شده ارزیابی میکند تا یک مقدار را تعیین کند. مانند Choice، این مدل نیز توزیعهای احتمالی و آمار اطمینان را برمیگرداند.
- Noul: تخمین میزند که آیا یک گزاره درست است یا خیر و عددی بین صفر و یک برمیگرداند.
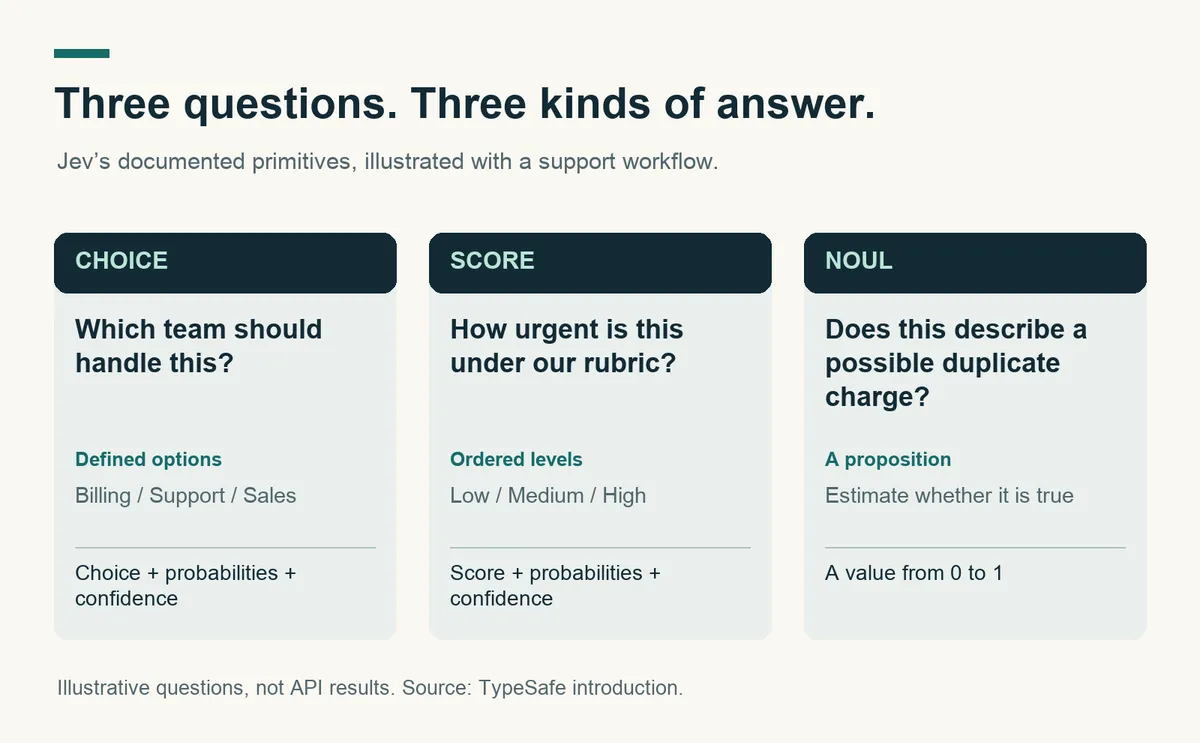
میتوان چندین پرسش را بهطور مستقل روی یک ورودی واحد اجرا کرد. برای گردش کار پشتیبانی، این پرسشها ممکن است شامل این موارد باشد: «کدام بخش باید پیام را مدیریت کند؟»، «طبق سیاست پشتیبانی ما، این پیام چقدر فوری است؟» و «آیا پیام توصیفکننده یک شارژ تکراری احتمالی است؟»
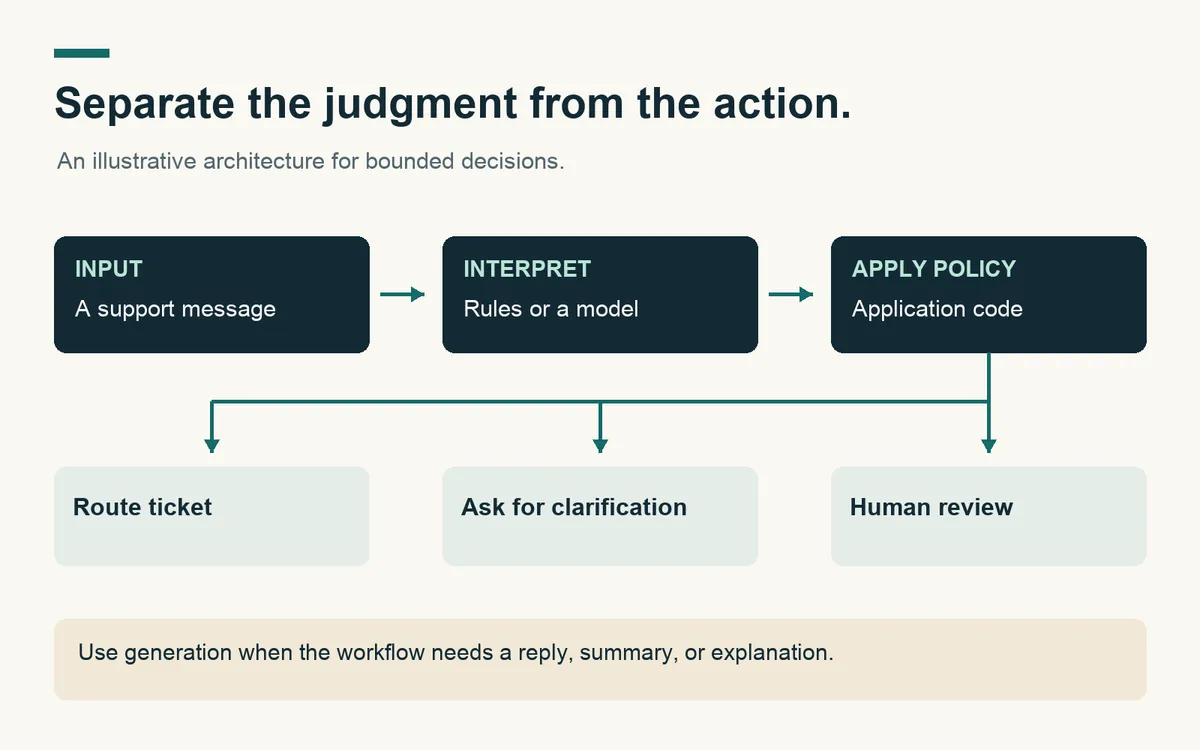
با جداسازی این قضاوتها، توسعهدهندگان میتوانند سیاستهای مسیریابی خود را در کدهای معمولی (Ordinary Code) نگه دارند. برای مثال، یک پیام میتواند توسط پرسش Choice به عنوان «مرتبط با مالی» و توسط پرسش Score به عنوان «فوریت بالا» علامتگذاری شود. سپس کد برنامه بر اساس این سیگنالهای مجزا، اقدام نهایی را تصمیم میگیرد. یک پیام میتواند مربوط به بخش مالی باشد بدون اینکه فوری باشد، و یک لحن عصبانی لزوماً به معنای قطعی بودن سرویس نیست. مدل پیام را تفسیر میکند، اما کد شما پیامدها را کنترل میکند.
آموزش برای کالیبراسیون
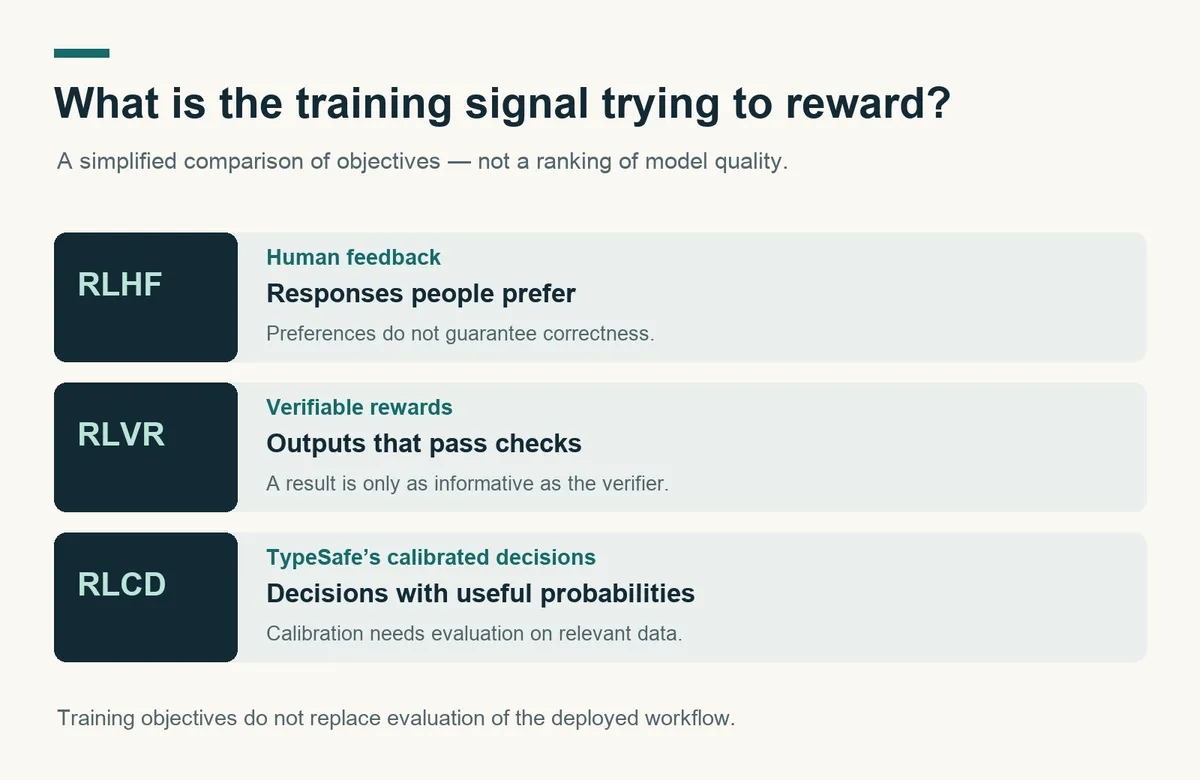
شرکت TypeSafe روش آموزشی جدیدی به نام RLCD (یادگیری تقویتی برای تصمیمات کالیبره شده) را معرفی کرده است. این روش با متدهای رایج دیگر متفاوت است:
- RLHF (یادگیری تقویتی از بازخورد انسانی): در رویکرد InstructGPT استفاده شده است. این روش از نمایشهای انسانی برای آموزش نظارتشده و رتبهبندی پاسخها برای آموزش یک مدل پاداش استفاده میکند. این متد پیروی از دستورات و ترجیحات کاربر را بهبود میبخشد اما صحت (Correctness) را تضمین نمیکند.
- RLVR (یادگیری تقویتی با پاداشهای قابل تأیید): از پاداشهایی استفاده میکند که میتوان آنها را بهطور برنامهنویسی شده بررسی کرد. برای مثال، یک پاسخ ریاضی با نتیجه شناختهشده مقایسه میشود یا کد تولید شده از طریق تستها ارزیابی میگردد. مدل DeepSeek-R1 نمونهای برجسته از این رویکرد در استدلال است.
- RLCD: بهطور خاص روی کالیبراسیون تمرکز دارد؛ به این معنا که هدف این است که پاسخهای محدود با احتمالاتی همراه باشند که بهطور معناداری عدم قطعیت را منعکس کنند.
درک احتمال و اطمینان
در RLCD، هدف بهینهسازی این است که تخمینهای احتمالی با نتایج مشاهدهشده مطابقت داشته باشند. اگر یک مدل مسیریابی بهطور مکرر احتمال ۸۰٪ را برای گزینه «مالی» اختصاص دهد، این دسته باید در حدود ۸۰٪ موارد در یک مجموعه بزرگ و مرتبط از پیشبینیهای مشابه، درست باشد. این یک اظهارنظر درباره «گروهی از پیشبینیها» است، نه یک تضمین برای یک تیکت واحد.
یک نکته ظریف و حیاتی در مورد آمار اطمینان Jev وجود دارد: این آمار از توزیع احتمالی آن استخراج میشود. نباید بهطور خودکار به عنوان «احتمال درست بودن پاسخ انتخاب شده» تفسیر شود. برای یک کسبوکار، سؤال عملیاتی این است: «چند تیکت را میتوانیم بهطور خودکار مسیریابی کنیم در حالی که خطاهای مسیریابی را زیر یک سطح قابل قبول نگه داریم؟» مدلی که ۷۰٪ تیکتها را بهطور قابل اعتماد مدیریت میکند و بقیه را به انسان ارجاع میدهد، بسیار ارزشمندتر از مدلی است که با اطمینان کامل، همه چیز را بهطور اشتباه مسیریابی میکند.
پارادوکس توهم
TypeSafe ادعا میکند که Jev نمیتواند دچار توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که اصلاً وجود ندارد، شبیه دوستی که خاطرهای را اشتباه تعریف میکند — شود. اما این ادعا مربوط به «اعتبار خروجی» (Output Validity) است، نه «دقت معنایی» (Semantic Accuracy). اگر تنها دستههای مجاز «مالی»، «پشتیبانی فنی» و «فروش» باشند، یک رابط تصمیمگیری محدود شده، مدل را از ابداع دسته چهارم باز میدارد. این موضوع مشکل اعتبار خروجی مرتبط با تطبیق طرح (Schema Matching) را حل میکند.
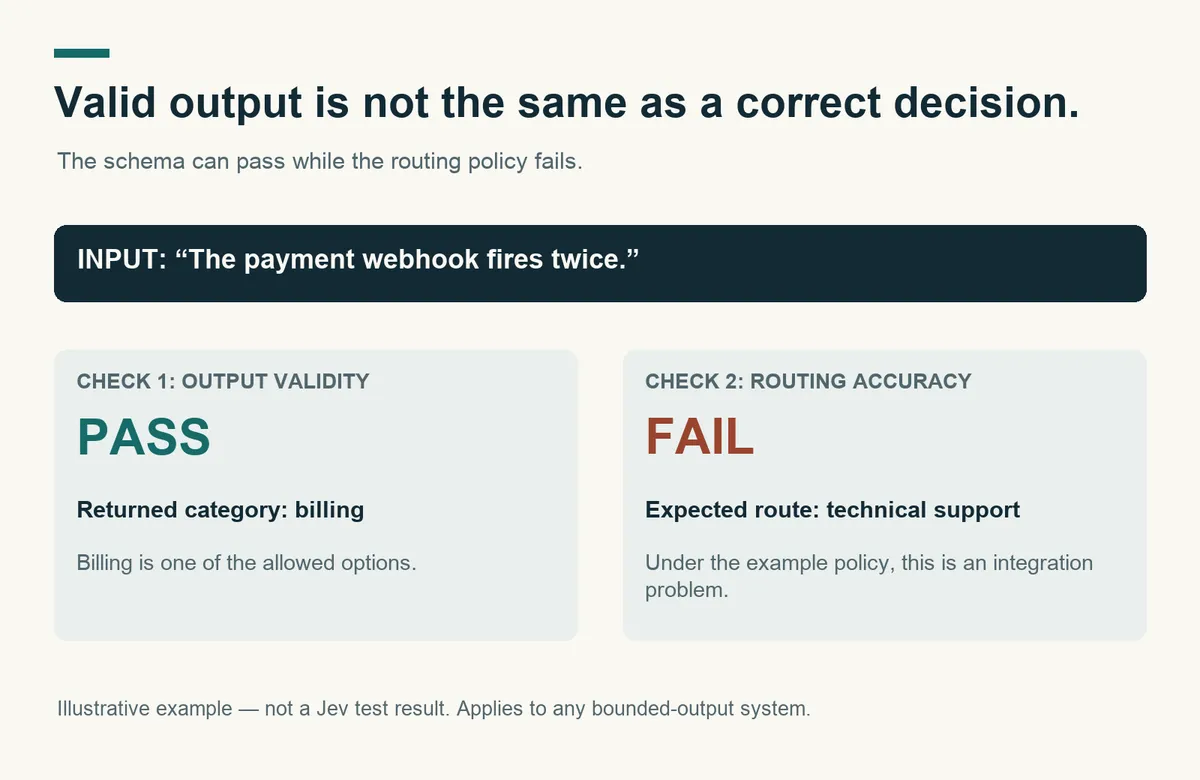
همانطور که نویسنده اشاره میکند، یک مدل میتواند دستهای کاملاً معتبر را برگرداند که همچنان یک تصمیم اشتباه باشد. «مالی» یک پاسخ معتبر برای هر درخواستی تحت آن طرح است، اما همچنان مقصد اشتباهی برای یک وبهوک خراب است. این بدان معناست که توسعهدهندگان همچنان به موارد زیر نیاز دارند:
- مسیری برای اطلاعات گمشده یا مبهم.
- ارزیابی در برابر نمونههای واقعی.
- یک راه جایگزین (Fallback) برای زمانی که مدل نامطمئن است.
- نظارت (Monitoring) پس از استقرار.
عملکرد و موازنه
بر اساس ارزیابیهای گزارششده توسط TypeSafe AI، مدل Jev بهرهوری عظیمی نسبت به مدلهای پیشرو (Frontier Models) دارد. این شرکت گزارش میدهد که Jev در گردشهای کاری منتخب، تقریباً ۱۹۴ برابر سریعتر و ۴۴۵ برابر ارزانتر است.
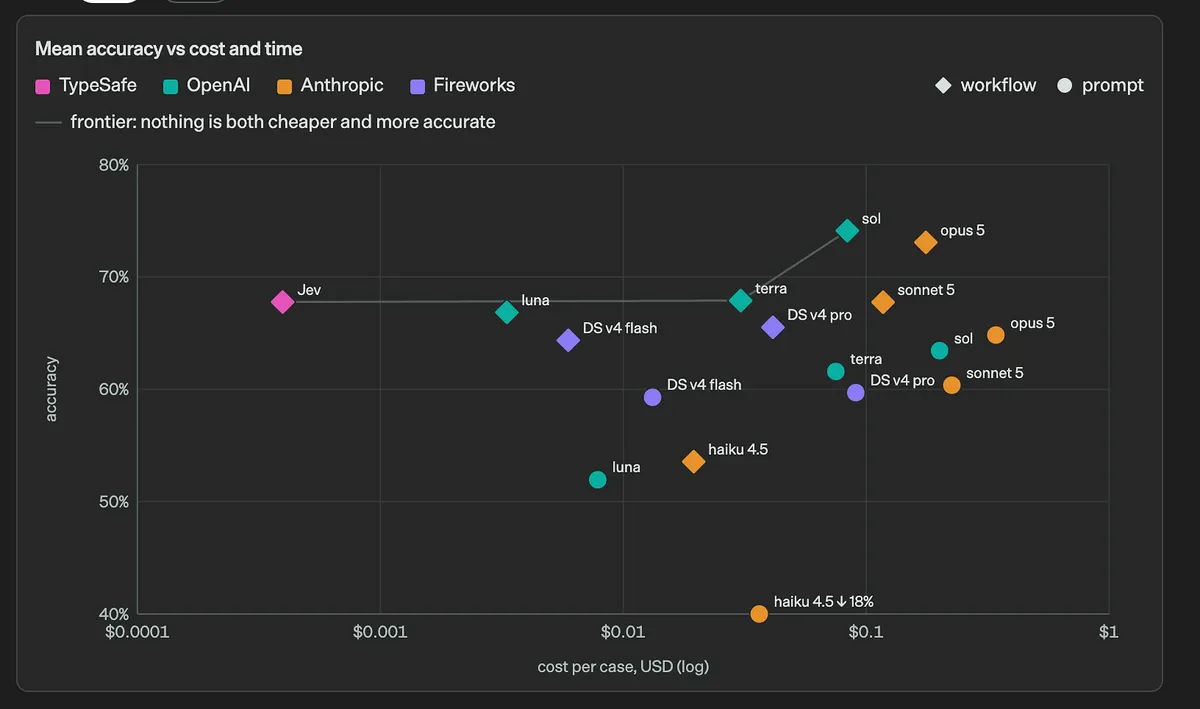
با این حال، این اعداد ملاحظاتی دارند. ارزیابیها از پاسخهای مرجعی استفاده کردهاند که از اجماع مدلهای پیشرو به دست آمده بود، نه از دادههای واقعی که بهطور مستقل برچسبگذاری شده باشند. در نمودار هزینههای ارائه شده، محور عمودی «میانگین صحت» و محور افقی «هزینه به ازای هر مورد» را در مقیاس لگاریتمی نشان میدهد. لوزیها نشاندهنده گردشهای کاری و دایرهها نشاندهنده پرامپتهای مستقل هستند. در حالی که Jev کمهزینهترین پیکربندی نمایش داده شده است، اما بالاترین صحت را ندارد. این موضوع دادهها را برای مقایسه موازنه (Trade-off) مفید میکند، نه برای اعلام یک برنده مطلق.
بستر و محدودیتها
مدیریت زمینه یا پنجره متنی (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد، شبیه میز کاری که جا برای چند ورق دارد — بخش حساسی برای تست است. مستندات TypeSafe نشان میدهد که مطالب نامرتبط در ورودی مدل Jev 1.13 میتواند صحت را کاهش دهد. بنابراین توصیه میشود ورودیها فقط به اطلاعات ضروری برای تصمیمگیری محدود شوند. داشتن یک پنجره متنی بزرگتر به تنهایی باعث ایجاد صحت بهتر نمیشود. برای تصمیمات حساس در حوزههای مالی یا بهداشت و درمان، شواهدی لازم است که نشان دهد مدل چگونه ورودیهای موجز را در مقابل ورودیهایی با جزئیات نامرتبط مدیریت میکند.
پیادهسازی معماری قابل اعتماد
برای عبور از پرامپتهای ساده، نویسنده یک برنامه ارزیابی مبتنی بر رگرسیون پیشنهاد میکند. این کار شامل مقایسه Jev در برابر مدلهای زبانی کوچک (Small LLMs) با خروجیهای ساختاریافته و قوانین قطعی (Deterministic Rules) با استفاده از یک مجموعه مرجع مشترک از موارد نماینده است.
این ارزیابی پیشنهادی شامل موارد زیر خواهد بود:
- یک مجموعه مرجع مشترک: استفاده از موارد نماینده با برچسبهایی که بهطور مستقل بررسی شدهاند و قوانین تصمیمگیری صریح، شامل گزینهای برای تعویق (Defer) در صورت نبود اطلاعات.
- پایگاههای مقایسهای: مقایسه Jev، یک LLM کوچک و یک LLM بزرگتر (که همگی از خروجیهای ساختاریافته استفاده میکنند) در کنار قوانین قطعی.
- خطاهای بر اساس پیامد: گزارش خطاهای سطح کلاس و موارد شکست. نرخ خطاها باید در همان کسری از مواردی که بهطور خودکار مدیریت شدهاند مقایسه شود تا اطمینان حاصل شود که یک مدل صرفاً به دلیل ارجاع دادن کارهای بیشتر به انسان، ایمنتر به نظر نمیرسد.
- بررسی کالیبراسیون مجزا: تست تخمینهای احتمالی در برابر نتایج مشاهدهشده و جدا نگه داشتن آمارهای اطمینان مخصوص هر مدل.
- تستهای زمینه و نسخه: تغییر شواهد مرتبط و جزئیات نامرتبط در حالی که تأخیر (Latency) و هزینه، از جمله تلاشهای مجدد (Retries)، ثبت میشوند.
یک معماری تولیدی مستحکم باید از یک رویکرد لایهای پیروی کند:
۱. قوانین قطعی: ابتدا موارد صریح و بدون ابهام را مدیریت کنند.
۲. مدل تصمیمگیر: پیامهای پیچیده باقیمانده را با ابزاری مثل Jev طبقهبندی کنند.
۳. سیاست برنامه: امتیازات عدم قطعیت را بررسی کرده و در صورت پایین بودن اطمینان، مورد را به بررسی انسانی ارجاع دهند.
۴. هوش مصنوعی زاینده: از LLMها فقط در انتهای زنجیره برای پیشنویس پاسخ واقعی، خلاصهسازی یک رشته گفتگو یا نوشتن یک توضیح استفاده کنند.
این ساختار تضمین میکند که مدل یک تصمیم را «پیشنهاد» میکند، اما کد برنامه «پیامدها» را کنترل میکند. قبل از انتخاب یک مدل، توسعهدهندگان باید خروجی را تعریف کنند: اگر پاسخ باید یکی از هشت برچسب، یک امتیاز، یا یک قضاوت بله/خیر باشد، آنها باید ابزارهای تصمیمگیری را قبل از مراجعه به یک مدل مولد ارزیابی کنند.
گام بعدی شما
- اگر از LLMها برای دستهبندی (Classification) استفاده میکنید، هزینه و تأخیر خود را با مدلهای تصمیمگیر مقایسه کنید.
- لایهای برای «ارجاع به انسان» بر اساس امتیاز اطمینان (Confidence Score) در کد خود تعریف کنید.
- ورودیهای مدل را فیلتر کنید تا نویزهای متنی باعث کاهش صحت تصمیمگیری نشوند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو