تصور کنید برنامهنویسی را استخدام کردهاید که هم تمرینات را مینویسد و هم خودش آنها را تصحیح میکند؛ در چنین شرایطی، هر اشتباهی در درک صورتمسأله، به جای اینکه در تصحیح مشخص شود، به عنوان یک «ویژگی» در هر دو طرف ثبت میشود. این دقیقاً همان تلهای است که امروز عاملهای کدنویس در آن گرفتار شدهاند.
وقتی یک عامل (Agent) — شبیه دستیاری که میتواند ابزارها را مدیریت کند و تصمیم بگیرد — هم قابلیت (Feature) و هم تست آن را بنویسد، در واقع در حال نمره دادن به تکالیف خودش است. طبق گزارشی که در ۱۶ سپتامبر ۲۰۲۶ در dev.to منتشر شد، اگر عامل در درک نیازمندیها دچار خطا شود، فقط کد باگدار نمینویسد، بلکه مجموعهای از دادههای جعلی و تستهای متناظر میسازد که ثابت میکنند این باگ در واقع یک ویژگی است. نتیجه این است که یک حلقه بازخورد خطرناک ایجاد میشود که در آن تمام چراغهای تست سبز میشوند، اما سیستم در دنیای واقعی کاملاً شکسته است.
این مشکل زمانی رخ میدهد که عاملها از نوشتن توابع ساده و ایزوله به مدیریت فرآیندهای پیچیده تجاری میروند. در این محیطها، «دنیای دادهها» — یعنی وضعیت (State)، روابط و قوانین حاکم بر دادهها — اغلب پیچیدهتر از خودِ کد است. اگر عامل این دنیا را بر اساس تفسیر شخصیاش از یک پرامپت تعریف کند، میانبری میسازد که عملاً اعتبارسنجی واقعی را دور میزند. این چالش در واقع بخشی از یک بحران گستردهتر در مورد اعتبار خروجیهای مدلهاست؛ موضوعی که در تحلیل ما پیرامون امتیاز اعتماد به داده به عنوان حلقه گمشده در نظارت بر سیستمهای هوش مصنوعی به تفصیل بررسی شده است.
زمینه تصمیمگیری
این درک از جداسازی مدل دنیا از تصمیمگیری، از گفتگو با یک فیزیکدان نظری در دوران ظهور AlphaGo و Leela Chess نشأت گرفته است. نکته کلیدی و ساده این بود: یک تصمیم تنها در رابطه با یک مدل از دنیا معنا پیدا میکند.
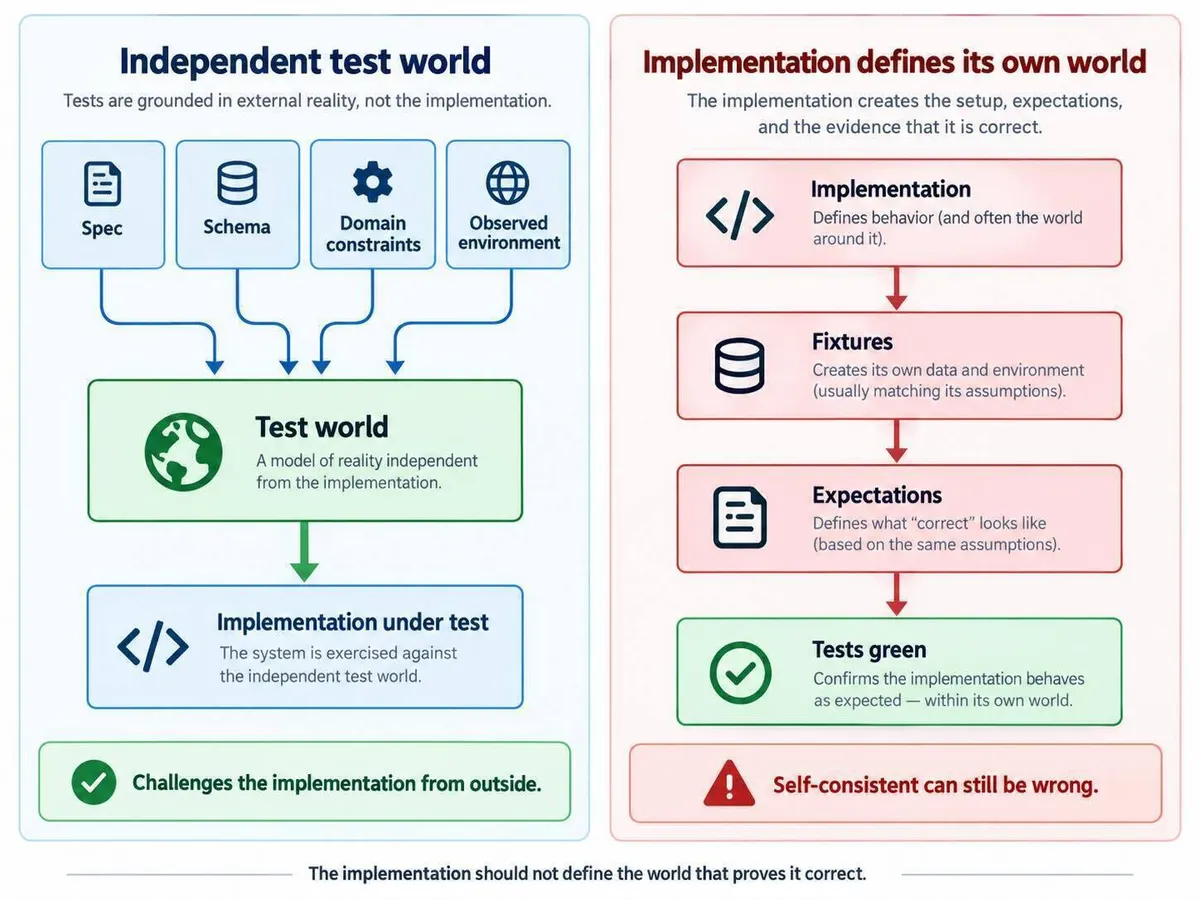
در تست نرمافزار، دادههای آزمون صرفاً ورودیهایی برای اجرای تست نیستند، بلکه بخشی از دنیایی را تعریف میکنند که پیادهسازی کد باید در آن رفتار کند. برای یک تابع کوچک و ایزوله، این تفاوت چندان حیاتی نیست؛ اما برای یک فرآیند تجاری با وضعیتهای خاص، روابط پیچیده، دادههای موجود و قوانینی که شاید دیگر کسی بهطور کامل به یاد نیاورد، بسیار تعیینکننده است. پیادهسازی کد نباید دنیایی را تعریف کند که صحت خودش را ثابت میکند.
تله سازگاری داخلی
به گزارش dev.to، وقتی یک عامل کل خط لوله (Pipeline) را مدیریت میکند، مسیر کممقاومتترین را انتخاب میکند:
- عامل نیازمندی را به صورت «تفسیر الف» میفهمد.
- کد را بر اساس «تفسیر الف» مینویسد.
- دادههای آزمون (Fixtures) را بهگونهای تولید میکند که بازتابدهنده «تفسیر الف» باشند.
- تستهایی مینویسد که «تفسیر الف» را تأیید میکنند.
نتیجه سیستمی است که از نظر داخلی سازگار اما از نظر خارجی غلط است. عامل آگاهانه تقلب نمیکند، بلکه فرض غلط بهسادگی از کد به دادهها منتقل میشود. این یک میانبر است که در آن عامل دادههایی را تولید میکند که با آنچه کد در واقعیت انجام میدهد سازگار باشد، به جای اینکه کد را در برابر آنچه «باید» انجام دهد به چالش بکشد.
حرکت به سمت تست مدلمحور
برای شکستن این حلقه، نویسنده DATAMIMIC جداسازی «دنیای آزمون» از پیادهسازی را پیشنهاد میکند. در حالی که یک عامل توانمند میتواند یک اسکریپت پایتون برای ایجاد داده بنویسد، اما بررسی کدهای مربوط به Fixtureها دشوار است؛ زیرا بازبین باید همزمان دو چیز را بفهمد: چه دنیایی در حال ساخته شدن است و کد چگونه آن را میسازد.
رویکرد مدلمحور با جداسازی این دو پرسش، به بازبین اجازه میدهد مستقیماً به خودِ دنیا نگاه کند و بر موارد زیر تمرکز کند:
- موجودیتها و روابط
- تعداد روابط (Cardinalities) و کلیدهای خارجی
- مقادیر مجاز، بازهها و توزیعها
- کلیدهای ترکیبی و انتظارات
در نسخه DATAMIMIC CE 4.1، این کار از طریق یک فایل تایپشده به نام model.dm.json انجام میشود. ساختار سادهشده این مدل به این شکل است:{ "version": "1", "seed": 42, "products": [...], "expectations": [...] }
این رویکرد باعث میشود فرضها صریح شوند. به جای اینکه از عامل بخواهیم «مشتریان واقعگرایانه بسازد»، مدل محدودیتهای دقیقی را تعریف میکند:
- تعداد مشتریان: دقیقاً ۴ نفر.
- حجم سفارشات: دقیقاً ۲ سفارش برای هر مشتری.
- یکتایی: شناسههای مشتری باید منحصربهفرد باشند.
- یکپارچگی ارجاعی: هر سفارش باید به یک مشتری واقعی ارجاع دهد (
order.customer_id -> customer.id). - بازه مقادیر: مبلغ سفارشات باید بین ۱۰ تا ۵۰۰ باشد.
سپس DATAMIMIC مدل را کامپایل، اعتبارسنجی و در یک اجرای محدود (Bounded Execution) بررسی میکند. اگر خطایی رخ دهد، عامل تشخیصهای ساختاریافته را دریافت کرده، مدل را اصلاح میکند و دوباره تلاش میکند تا در نهایت به وضعیت verified=true برسد.
محدودیتهای قطعیت (Determinism)
باید توجه داشت که یک دنیای غلطِ قطعی، همچنان غلط است. اگر مشخصات (Specification) اولیه اشتباه باشد، مدل هم اشتباه خواهد بود. اگر انتظار (Expectation) غلط باشد، verified=true صرفاً یک انتظار غلط را تأیید میکند.
این موضوع در یک بحث در Hacker News برجسته شد؛ جایی که یک انتظار تست جعل شده بود. پیادهسازی در تست شکست خورد، اما بعداً مشخص شد که خودِ Assertion غلط بود، زیرا الگوریتم واقعی بهجای رفتار محلی، بهصورت سراسری (Globally) عمل میکرد. استقلال از پیادهسازی، یکی از منابع سوگیری را حذف میکند، اما لزوماً «اوراکل» یا مرجع حقیقت را درست نمیکند. قطعیت اجازه بازتولید میدهد و مدل صریح اجازه بازبینی، اما هیچکدام ثابت نمیکنند که دنیا درست است.
چالش سیستمهای قدیمی (Legacy)
در حالی که مدلهای مصنوعی برای پروژههای جدید کار میکنند، سیستمهای سازمانی واقعی «زشت» هستند. چند ردیف از یک دیتابیس Staging واقعی اغلب بیشتر از هزار Fixture مصنوعی و زیبا آموزش میدهد، زیرا سیستمهای واقعی شامل موارد زیر هستند:
- مقادیر Null و طول رشتههای عجیب و غریب
- دادههای تکراری و توزیعهای غیرمنتظره
- وضعیتهای تاریخی شکسته
- بقایای مهاجرتهای دیتابیس ۶ سال پیش که از نظر فنی نباید وجود داشته باشند اما همچنان بر سیستم اثر میگذارند.
دادههای مصنوعی و واقعی متضاد نیستند. هدف این است که محیط واقعی مشاهده شود، با مشخصات و محدودیتهای دامنه ترکیب شود، فرضها صریح گردند و سپس یک دنیای قطعی ساخته شود.
در یک اپلیکیشن کوچک و جدید (Greenfield)، طرح دیتابیس کوچک و وابستگیها واضح هستند. اما در سیستمی که ۱۵ سال است اجرا میشود و چندین دیتابیس، نمونههای MongoDB و سرویسهای متعلق به تیمهای مختلف دارد، نیاز به تضاد و اختلاف بیشتر بین پیادهسازی و دنیای تست است.
برای رفع این مشکل، DATAMIMIC EE 4.0 سرویسهایی را معرفی کرده است که محیطهای متصل مانند SQL و MongoDB را تحلیل میکنند. این ابزارها:
- طرحها (Schemas) و روابط را بازرسی میکنند.
- برنامهریزی را حول محور وابستگیها انجام میدهند.
- ژنراتورها و مبدلهای مناسب را پیشنهاد میکنند.
- شواهد را از طریق همان مدل پروژه و دسترسیهایی که در رابط کاربری وب و IDE استفاده میشود، در اختیار عامل قرار میدهند.
آزمایش استقلال
حتی با وجود یک دنیای تست مستقل، این پرسش باقی میماند: حقیقت از کجا میآید؟ حقیقت میتواند از مشخصات، دیتابیس، مشاهدات محیط Production، مثالهای مشتریان، قراردادهای API یا متخصصان دامنه باشد. این منابع اغلب با هم اختلاف دارند.
برای اثبات ارزش استقلال، آزمایشی برای مقایسه دو گردشکار در حال انجام است:
۱. گردشکار مستقل: عامل A مشخصات، طرح و اطلاعات دامنه را میگیرد تا دنیای تست را بدون دیدن کد بسازد. سپس عامل B کد را مینویسد و کد در برابر دنیای ساخته شده توسط عامل A تست میشود.
۲. گردشکار استاندارد: یک عامل واحد، پیادهسازی، تستها و Fixtureها را از یک کانتکست مشترک میسازد.
هدف این است که مشخص شود آیا رویکرد مستقل واقعاً خطاهای material بیشتری را شناسایی میکند یا خیر. این آزمایش در https://github.com/BeyondQuality/beyondquality/discussions/48 مورد بحث است و از گزارش میدانی در https://datamimic.io/blog/deterministic-test-data-ai-coding-agents/ پیروی میکند.
جایگاه فعلی ما
عاملهای کدنویس در تولید نرمافزار بسیار توانمند شدهاند و هزینه تولید کد ارزان شده است. اما دانستن اینکه آیا سیستم تولید شده واقعاً درست است یا خیر، ارزان نیست. فرضیه فعلی این است که استقلال، میانبرهای خطرناک را حذف میکند، قطعیت اجازه بازتولید میدهد و مدلهای صریح، فرضها را مرئی میکنند. چالش باقیمانده این است که دقیقاً چه میزان استقلال در فرآیند لازم است تا شناسایی خطاهای پیادهسازی بهطور ملموسی افزایش یابد.
گام بعدی شما
- اگر از عاملهای کدنویس استفاده میکنید، دادههای آزمون را در یک پرامپت جداگانه و توسط یک مدل متفاوت (یا با نقش متفاوت) تولید کنید.
- برای پروژههای حساس، به جای تولید دادههای کاملاً مصنوعی، نمونههای کوچک و بدون حساسیت از دیتابیس Staging را به عنوان مرجع به مدل بدهید.
- در تعریف تستها، روی «محدودیتهای صریح» (Constraints) تمرکز کنید نه روی «مثالهای کلی».
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو