تصور کنید میخواهید در یک شهر شلوغ، کوتاهترین مسیر را برای هزاران راننده پیدا کنید، اما مجبور باشید برای هر راننده، تمام مسیر را از ابتدا دوباره نقشهکشی کنید. این دقیقاً همان کابوسی است که اگر الگوریتمهای آموزش هوش مصنوعی بهجای حرکت معکوس، رو به جلو حرکت میکردند، با آن مواجه میشدیم.
گرگوری گاندرسن (Gregory Gundersen) در تحلیل فنی مورخ ۲۱ سپتامبر ۲۰۲۶، استدلال میکند که «یک الگوریتم گرادیان با انتشار رو به جلو، از نظر محاسباتی بهینه نیست». اگرچه قانون زنجیرهای (Chain Rule) اجازه میدهد مشتقات را با هر ترتیبی محاسبه کنیم، اما در یک شبکه عصبی (Neural Network) — که شبیه نقشه مترویی است که سیگنالها را از ورودی به جواب میرساند — مسئله اصلی، جهت حرکت نیست، بلکه بهرهوری است.
بسیاری از توسعهدهندگان درک میکنند که آموزش یک شبکه شامل تنظیم وزنها برای به حداقل رساندن خطا است. با این حال، این شهود رایج که ما «خطاها را به عقب میفرستیم»، دلیل ریاضیاتیِ ضرورتِ مسیر معکوس را میپوشاند. در یک تابع مرکب استاندارد، شما از نظر فنی میتوانید مشتقات را در حالی که رو به جلو حرکت میکنید محاسبه کنید، اما انجام این کار در یک گراف پیچیده، یک مشکل تکرار عظیم (Redundancy) ایجاد میکند.
زمینه ریاضیاتی
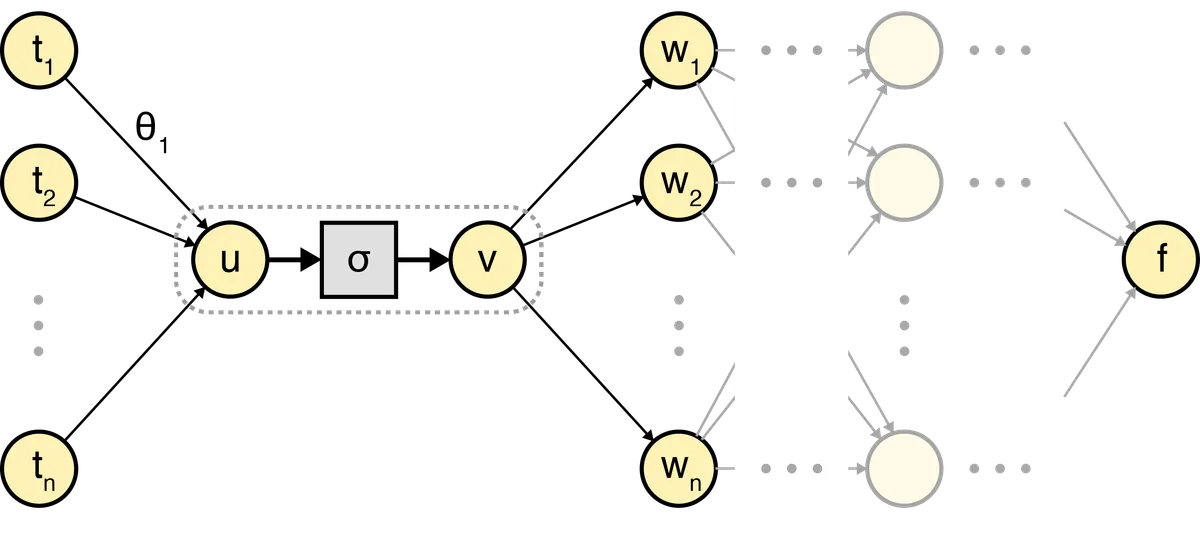
برای درک این گلوگاه، یک وزن $\theta_1$ و یک گره $v$ را در نظر بگیرید. هدف ما یافتن مشتق جزئی خروجی نهایی $f$ نسبت به آن وزن است: $\partial f / \partial \theta_1$.
در این ساختار، گره $v$ مقدار خروجی را پس از عبور مجموع وزندار ورودیها از یک تابع فعالساز $\sigma$ نشان میدهد. این فرآیند دقیقاً در دو مرحله تعریف میشود:
- مجموع وزندار: $u = \theta_1 t_1 + \theta_2 t_2 + \dots + \theta_n t_n$
- فعالسازی: $v = \sigma(u)$
بر اساس قانون زنجیرهای، محاسبه $\partial f / \partial \theta_1$ را میتوان به اجزای محلی تقسیم کرد: $\frac{\partial f}{\partial \theta_1} = \frac{\partial f}{\partial v} \frac{\partial v}{\partial u} \frac{\partial u}{\partial \theta_1}$.
محاسبات محلی و قانون زنجیرهای
بسیاری از این محاسبات را میتوان بهصورت محلی در هر گره انجام داد. ما میتوانیم $\partial v / \partial u$ را بر اساس تعریف $\sigma$ بهصورت تحلیلی محاسبه کنیم و میدانیم که $\partial u / \partial \theta_1 = t_1$ است. بنابراین، اگر مقدار $\partial f / \partial v$ را بدانیم، میتوانیم گرادیان نهایی را برای آن وزن محاسبه کنیم.
چالش اصلی زمانی ایجاد میشود که گرههای پاییندستی به مقدار $v$ وابسته باشند. طبق قانون زنجیرهای متغیرهای چندگانه، برای تابعی مانند $g(w_1, w_2, \dots, w_m)$ که در آن هر $w_i$ تابعی از $v$ است، مشتق برابر است با $\frac{\partial g}{\partial v} = \sum_{j} \frac{\partial g}{\partial w_j} \frac{\partial w_j}{\partial v}$. در نتیجه، $\partial f / \partial v$ در واقع مجموع مشتقات تمام گرههای پاییندستی است که به $v$ وابستهاند.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی معماریهای ترنسفورمر اشاره کردیم، مدیریت جریان داده در گرافهای جهتدار، کلید مقیاسپذیری مدلهاست.
شکست رویکرد رو به جلو
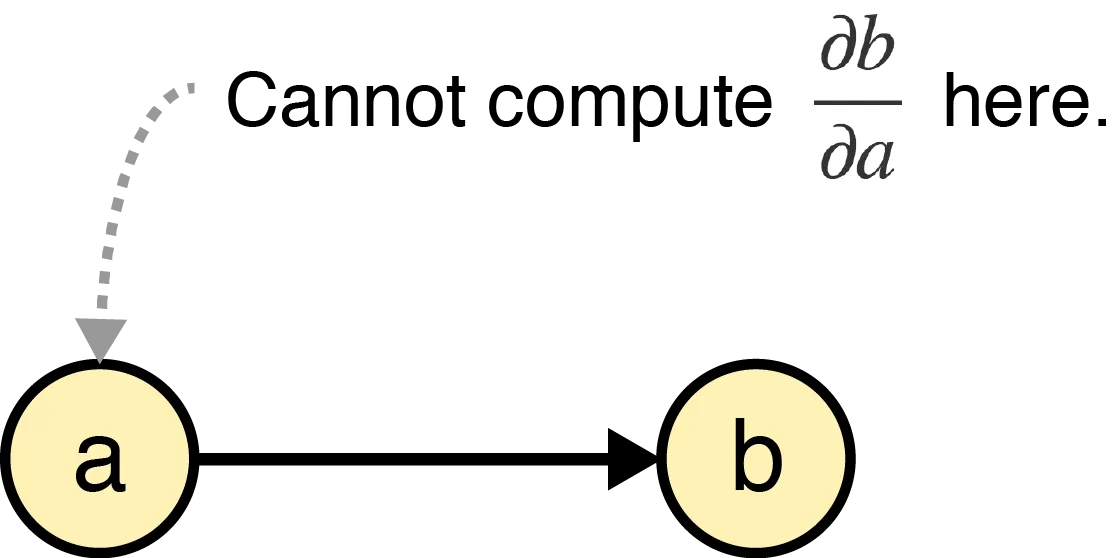
اگر الگوریتمی سعی کند اطلاعات گرادیان را رو به جلو منتقل کند، مجبور است پیامهای یکسانی را بارها و بارها ارسال کند. در یک گراف محاسباتی جهتدار، محاسبه $\partial b / \partial a$ در هر نقطهای پیش از رسیدن به گره $b$ غیرممکن است. اگر گراف نشاندهنده $f(a) = b$ باشد، شما نمیتوانید $f'(a)$ را بدون دسترسی به $b$ محاسبه کنید.
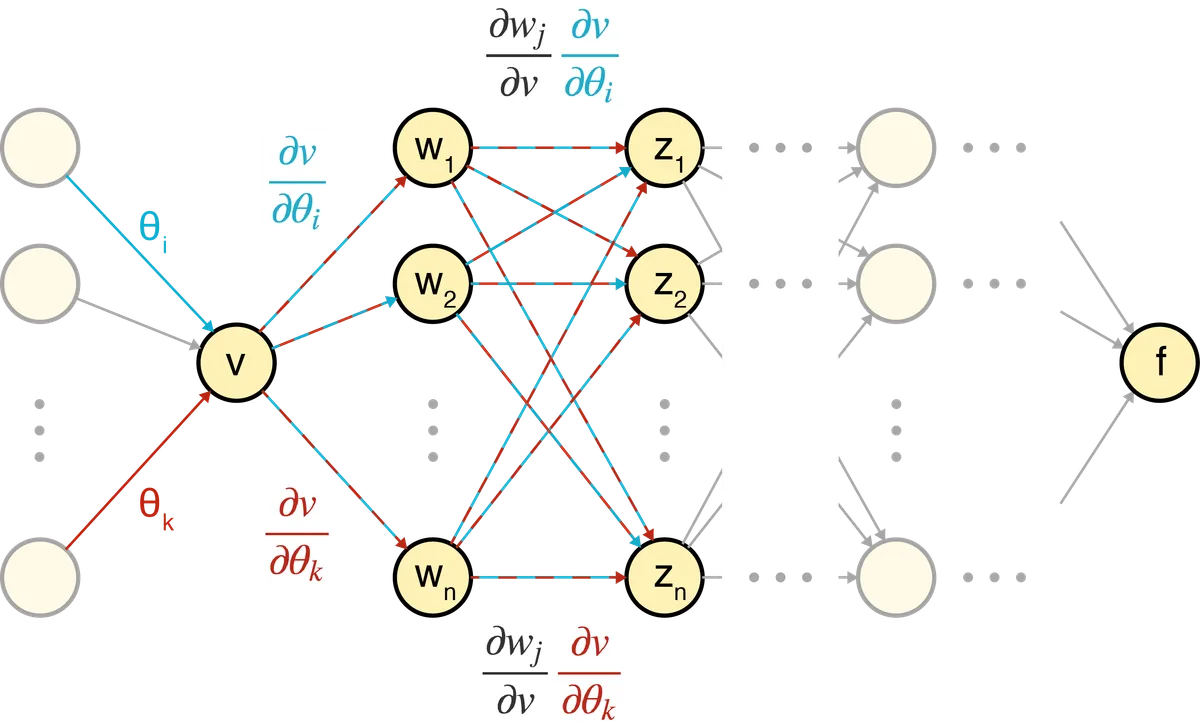
در یک سیستم با انتشار رو به جلو، الگوریتم مجبور است عبارت را تجزیه کرده و اجزای لازم را به هر گره پاییندستی $w_j$ بفرستد:
- عبارت $\partial v / \partial \theta_i$ به جلو فرستاده میشود.
- عبارت $\sum_{j} \frac{\partial f}{\partial w_j} \frac{\partial w_j}{\partial v}$ باید روی $w_j$ محاسبه شود.
برای هر دو وزن در یک لایه، مانند $\theta_i$ و $\theta_k$، عبارات پاییندستی — یعنی بخشهایی از قانون زنجیرهای که به بقیه شبکه وابستهاند — کاملاً یکسان هستند. فرمولهای $\partial f / \partial \theta_i$ و $\partial f / \partial \theta_k$ هر دو از یک مجموع پیچیده از مشتقات پاییندستی استفاده میکنند و تنها در عبارت محلی نهایی ($\partial v / \partial \theta_i$ در مقابل $\partial v / \partial \theta_k$) تفاوت دارند.
این تکرار، هزینه محاسباتی را از حالت خطی به درجهدوم (Quadratic) تبدیل میکند. با افزایش تعداد گرهها، حجم کارهای تکراری بهشدت رشد میکند و این فرآیند برای معماریهای مدرن یادگیری عمیق غیرقابلتحمل و ناپایدار میشود.
راهکار پسانتشار
پسانتشار (Backpropagation) با معکوس کردن جریان، این مشکل را حل میکند. با شروع از خروجی و حرکت به سمت ورودیها، هر گره فقط نیاز دارد مشتق محلی خود را محاسبه کرده و آن را به همسایگان بالادستی بفرستد.
این رویکرد تضمین میکند که عبارات پاییندستی دقیقاً یکبار محاسبه شده و سپس توسط تمام گرههای بالادستی بازاستفاده شوند. برای هر گره $v$ با وزنهای پاییندستی $w_j$، گره صرفاً پیامهای در حال انتشار معکوس را جمع میکند تا مشتق مورد نظر را به دست آورد: $\frac{\partial f}{\partial v} = \sum_{j} \frac{\partial f}{\partial w_j} \frac{\partial w_j}{\partial v}$.
نتیجه، فرآیندی است که در زمان خطی نسبت به تعداد گرههای شبکه اجرا میشود. همین بهرهوری است که آموزش مدلهای عظیم با میلیونها پارامتر را ممکن میسازد.
برای یک متخصص، این بدان معناست که ماهیت «معکوس» این الگوریتم، یک انتخاب طراحی دلخواه نیست، بلکه راهکاری مهندسیشده برای حل مسئله «تخصیص اعتبار» (Credit Assignment) است. هر گره به همسایگان بالادستی خود میگوید که دقیقاً چقدر در خطای نهایی نقش داشتهاند، بدون اینکه لازم باشد کل مسیر را برای هر پارامتر دوباره محاسبه کند.
این تغییر دیدگاه، پسانتشار را از یک فرآیند مرموز «ارسال خطا» به یک بهینهسازی عملگرایانه از قانون زنجیرهای تبدیل میکند و نشان میدهد چرا ساختار گراف جهتدار بدون دور (DAG) در شبکههای عصبی برای قابلیت آموزش آنها حیاتی است.
گام بعدی شما
- بررسی پیادهسازیهای اتوماتیک دیفرانسیال (Automatic Differentiation) در PyTorch برای درک نحوه مدیریت گرافهای محاسباتی.
- مطالعه تفاوت بین حالتهای Forward-mode و Reverse-mode در محاسبات مشتقات برای پروژههای کوچک.
- تحلیل اثر محوشدن گرادیان (Vanishing Gradient) که نتیجه مستقیم همین زنجیره ضربها در مسیر معکوس است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و بهینهسازیهای سختافزاری برای استنتاج مراجعه کنید.



گفتگو