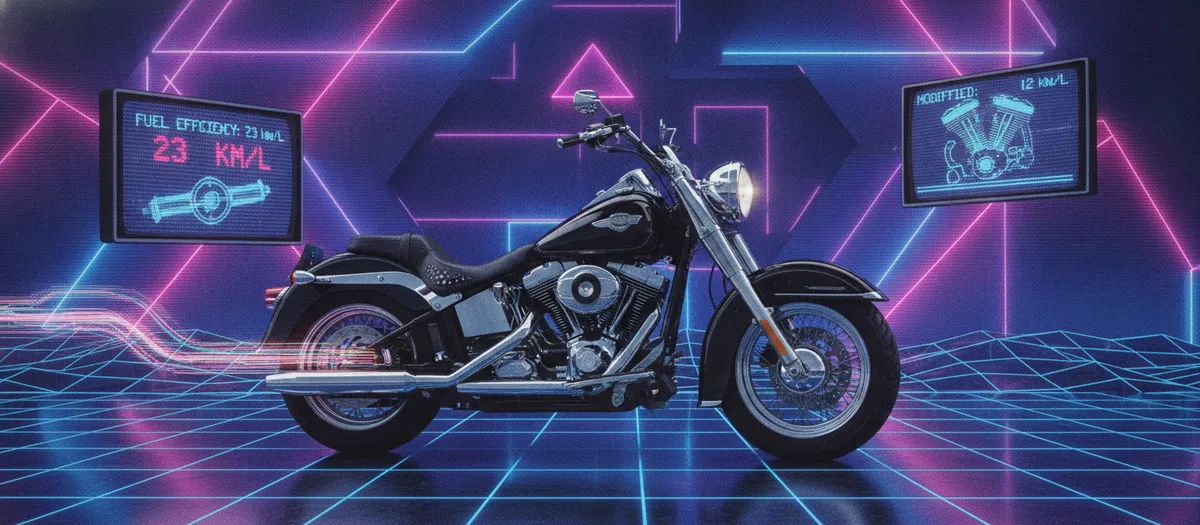
تصور کنید برای خرید یک بسته نان از بقالی محله، موتور یک موتورسیکلت مسابقهای با حجم ۱۶۰۰ سیسی را روشن کنید؛ قدرت زیاد است، اما مصرف سوخت شما به شدت بالا میرود. وقتی جوانتر بودم، از یک مکانیک خواستم موتور هارلی-دیویدسون هریتیج ۲۰۱۰ خود را به Stage 3 ارتقا دهد: موتور، ماژول ECM و چندین تغییر دیگر. این کار برای نمایش نبود، بلکه قدرت واقعی بود. در عمل، مصرف سوخت من از ۲۳ کیلومتر در لیتر به ۱۲ کیلومتر در لیتر کاهش یافت. من همیشه به آن قدرت نیاز نداشتم—نه زیاد موتورسواری میکردم و نه مسابقه میدادم—اما هزینه مصرف Stage 3 را در هر کیلومتر پرداخت میکردم، حتی وقتی مسیر هیچ نیازی به آن نیرو نداشت.
در یک عامل هوش مصنوعی (AI Agent)، ریاضیات دقیقاً به همین شکل است. باقی گذاشتن تلاش استدلالی (Reasoning Effort) در حداکثر برای یک تسک پیشپاافتاده—مانند تغییر نام یک متغیر، لیست کردن فایلها یا فرمت کردن Importها—در واقع پرداخت هزینه Stage 3 برای سفری به بقالی محله است. مدل میتواند از پس آن برآید، اما صورتحساب با هر بار ایجاد (Spawn) عامل، صادر میشود.
این ناکارآمدی از یک اشتباه رایج در ارکستراسیون عاملها میآید: یکی دانستنِ «انتخاب مدل» و «عمق استدلال». در حالی که مسیریابی مدل (Model Routing) تعیین میکند چه کسی کار را انجام دهد (سطح یا Tier مدل)، تلاش استدلالی تعیین میکند آن نمونه چقدر عمیق فکر کند. این دو تصمیم کاملاً مستقل (Orthogonal) از هم هستند. شما ممکن است در سطح مدل درستی باشید اما همچنان بیش از حد هزینه کنید، چون سیستم برای یک پرامپت مکانیکی، تلاش استدلالی را بالا نگه داشته است. یا برعکس، ممکن است در یک سطح ارزان با تلاش استدلالی بالا باشید و زمان را صرف «فکر کردن» کنید، در حالی که یک دستور ساده grep و تست کفایت میکرد.
با تکیه بر مفهوم مسیریابی مدل، این رویکرد یک پیچ کنترلی دوم را معرفی میکند. مسیریابی بدون مدیریت تلاش، مانند این است که Stage 3 را روشن نگه دارید در حالی که تسک فقط نیاز دارد به بلوک بعدی برسد. هدف این است که بپرسیم: «برای این تسک، کمترین تلاش استدلالی که همچنان ایمنی و کیفیت کافی را ارائه دهد، چیست؟»
مکانیسمهای تلاش استدلالی
تلاش استدلالی به معنای استفاده از یک «مدل هوشمندتر» نیست. بلکه بودجهای از توکنهای تفکر داخلی است که ارائهدهنده یا سیستم ارکستراسیون در فراخوانی API در اختیار شما میگذارد. اگرچه نامها متفاوت است، اما تصمیم مهندسی یکسان باقی میماند.
ارائهدهندگان مختلف این قابلیت را از طریق پارامترهای متنوعی ارائه میکنند:
- OpenAI: در Responses API برای سری o (مانند GPT-5.6 Sol / Luna در حالت downshift) از پارامتر
reasoning.effortاستفاده میکند. در Codex، این قلاب (hook) میتواندreasoning_effortرا به ایجاد زیر-عامل تزریق کند. این امر منجر به تولید توکنهای استدلالی بیشتر پیش از پاسخ میشود که تأخیر (Latency) و هزینه را افزایش میدهد اما تسکهای چندمرحلهای و عاملمحور را بهبود میبخشد. - xAI: برای مدلهای Grok (نسخههای ۴.۶ و ۴.۷) سطوح
reasoning_effort(شامل low، medium، high و در صورت پشتیبانی xhigh) را ارائه میدهد. پیشفرض روی high است و استدلال را نمیتوان به طور کامل خاموش کرد. تلاش بیشتر منجر به توکنهای استدلالی بیشتر در صورتحساب و عمق تحلیل بیشتر میشود. - Anthropic: این قابلیت را از طریق
budget_tokensبرای تفکر گسترده (حالت دستی) یاoutput_config.effortبرای تفکر تطبیقی در مدلهای Claude (Opus/Sonnet) پیاده کرده است. تفکر تطبیقی ممکن است برای ورودیهای آسان، توکنهای تفکر را حذف کند تا در هزینهها صرفهجویی شود. - Google: در مدلهای Gemini ۲.۵+ و ۳.x (مانند ۳.۸ Flash) از
thinkingLevelیا پیکربندیهای خاص تفکر استفاده میکند. مدل تصمیم میگیرد در آن سطح چقدر فکر کند و عمق بیشتر به معنای توکنها و زمان بیشتر است. - Cursor: به عنوان یک رابط کاربری چند-ارائهدهنده، تلاش استدلالی اغلب در SKU مدل (نسخههای دارای برچسب "thinking" یا "High") گنجانده شده است. در لیست قیمت Cursor، نسخههای "Fast" از یک سطح مدل اغلب برای سرعت بیشتر، ۲ برابر قیمت دارند.
طبقهبندی تسکها بر اساس تلاش
برای جلوگیری از اتلاف بودجه، تسکها باید پیش از ایجاد عامل، بر اساس پیچیدگی ذاتیشان طبقهبندی شوند. من از سه سیگنال اصلی برای تعیین اینکه آیا تلاش استدلالی باید پایین بماند یا افزایش یابد، استفاده میکنم:
۱. تأییدپذیری (Verification): اگر یک معیار عینی وجود دارد (مانند تست، diff یا linter)، تلاش استدلالی پایین میماند. اگر تسک به قضاوت ذهنی نیاز دارد یا تستهای کمی دارد، تلاش افزایش مییابد.
۲. ابهام (Ambiguity): پرامپتهای بسته (مانند «X را در Y تغییر نام بده») به تلاش کم نیاز دارند. اما وجود چندین فرضیه معتبر، نیازمند تلاش استدلالی بالاتر است.
۳. ریسک (Risk): شکستهای ارزان که به راحتی قابل بازگشت هستند، در سطح تلاش پایین میمانند. تسکهای مربوط به احراز هویت (Auth)، مسائل مالی، همروندی (Concurrency) یا مهاجرت دادهها (Migrations) نیازمند تلاش بالا هستند.
با استفاده از همان منطق طبقهبندی پیچیدگی در harness-downshift (شامل TRIVIAL، SIMPLE، MEDIUM، COMPLEX)، تسکها به پنج کلاس اصلی تقسیم میشوند:
- مکانیکی (Mechanical): تغییر نام، اصلاح غلط املایی، فرمت کردن، نوشتن پیامهای commit، لیست کردن فایلها.
- سطح مدل: کوچک / ارزان.
- تلاش: کم.
- دلیل: خروجی قابل تأیید است؛ تفکر طولانی فقط توکنها را افزایش میدهد.
- جراحی (Surgical): رفع باگ در یک تابع، افزودن یک فیلد جدید، دنبال کردن یک الگوی موجود.
- سطح مدل: کوچک $
ightarrow$ متوسط. - تلاش: کم تا متوسط.
- دلیل: تلاش تنها زمانی افزایش مییابد که مدل ارزان در استدلال شکست بخورد، نه در اجرا.
- سطح مدل: کوچک $
- یکپارچه (Integrated): ویژگیهایی که چندین فایل را درگیر میکنند، بازسازی (Refactor) ماژولها.
- سطح مدل: متوسط / متوازن.
- تلاش: متوسط.
- دلیل: نیازمند برنامهریزی متوسط در حالی که تستها در چرخه باقی میمانند.
- اکتشافی (Exploratory): «این مورد کجا میشکند؟»، ردیابی در یک کدبیس حجیم.
- سطح مدل: متوسط.
- تلاش: متوسط تا بالا.
- دلیل: نیازمند جستجوی گسترده است؛ با این حال، باید مراقب بود تا در هر عامل فرزند، تلاش بالا نباشد.
- حیاتی (Critical): احراز هویت، پرداختها، مهاجرت دادهها، Race Conditionها، بررسیهای امنیتی.
- سطح مدل: پیشرو (Frontier).
- تلاش: بالا.
- دلیل: هزینه خطا بسیار بیشتر از هزینه تفکر است.
بنچمارکها و کالیبراسیون صادقانه
من از بنچمارکهای عمومی برای ایجاد لیستهای کوتاه مدل استفاده میکنم، اما آنها به ندرت ستونی مجزا برای reasoning_effort دارند. برای ارزیابی ظرفیت و هزینه به موارد زیر تکیه میکنم:
- SWE-bench: برای سنجش ظرفیت در مسائل دنیای واقعی.
- LiveBench: برای تفکیک کدنویسی در مقابل کدنویسی عاملمحور و تحلیل هزینه به ازای هر تسک موفق.
- Artificial Analysis: برای تحلیل توازن بین کیفیت $ imes$ قیمت $ imes$ تأخیر.
- LMArena (Coding & Agent): برای بررسی ترجیحات انسانی و هزینه هر تسک در عاملها.
در حالی که اعداد لیدربوردها عمومی هستند، کاهش مصرف هارلی از ۲۳ به ۱۲ کیلومتر در لیتر، تجربه شخصی من است. من «پیچ دوم» (تلاش) را با استفاده از مستندات ارائهدهنده و تلهمتریِ ایجاد عامل (Spawn Telemetry) کالیبره میکنم.
ماتریس دو محوره: سطح مدل در مقابل تلاش
این را به عنوان یک ماتریس ذهنی برای اجتناب از خطای کلاسیک مسیریابی در نظر بگیرید: پایین آوردن سطح مدل اما باقی گذاشتن تلاش در حداکثر به این دلیل که «همین حالا هم در حال صرفهجویی هستیم». این دقیقاً همان پایین آوردن سطح مدل در حالی است که Stage 3 برای سفر به بقالی روشن است.
| تلاش کم (Low Effort) | تلاش بالا (High Effort) | |
|---|---|---|
| سطح ارزان (Cheap Tier) | grep، فرمت کردن (به ندرت) | (نادر: معمولاً سطح مدل اشتباه است) |
| سطح متوسط (Mid Tier) | ویژگیهای محلی (Local Feature) | دیباگ چند-فایلی |
| سطح پیشرو (Frontier Tier) | بررسیهای سطحی | حوادث، Race Condition، امنیت |
در ابزارهایی مانند Claude Code و Cursor، تغییر سطح در حال حاضر روی مدل در تسک متمرکز است. تلاش استدلالی مجزا است و در جایی ظاهر میشود که API آن را ارائه دهد (مانند Codex یا تنظیمات Grok). «مسیریابی فرزند» را با «کالیبره کردن نحوه تفکر آن» اشتباه نگیرید.
تلهی گسترش (The Fan-Out Trap)
هزینهها زمانی غیرخطی میشوند که عاملها، زیر-عاملهایی ایجاد کنند. در بسیاری از سیستمها، فرزندان به طور پیشفرض تنظیمات والد را به ارث میبرند. درختی از هشت فرزند «اکتشافی» با تلاش بالا، همان اشتباهی است که هشت فرزند Opus برای لیست کردن فایلهای .go ایجاد کنند.
ارکستراسیون مؤثر نیازمند یک سیاست (Policy) پیش از اجرا است:
- والد (جلسه اصلی): مدل و تلاش برای هماهنگی (Coordinate) انتخاب میشوند.
- فرزندان: سطح و تلاش به ازای هر پرامپتِ ایجاد (Spawn Prompt) تخصیص مییابند، نه بر اساس پیشفرض جلسه.
در harness-downshift، نقطه کنترل، ایجاد تسک (در Claude Code و Cursor) یا spawn_agent (در Codex) است. در اینجا، ما تسک را طبقهبندی میکنیم، سطح مدل را نگاشت میکنیم و reasoning_effort را پیش از وجود پردازش فرزند تنظیم میکنیم. برای Grok، این موضوع از طریق پینهای هر نقش در پیکربندی مدیریت میشود.
برای تسکهای پرریسک (احراز هویت، مهاجرت، Race)، نسخهی ۲ مسیریاب قابلیتها (Capability Router v2) یک کف ایمنی را اعمال میکند: سطح پیشرو (Frontier) بدون توجه به امتیاز. به طور متقارن، تسکهای حیاتی هرگز برای صرفهجویی در هزینه، تلاش کم دریافت نمیکنند و تسکهای پیشپاافتاده هرگز تلاش بالا دریافت نمیکنند، حتی اگر والد در «حالت جدی» باشد.
عملیاتی کردن تلاش به عنوان سیاست
برای تیمهای مهندسی، تلاش استدلالی باید به جای یک انتخاب دستی در منوی کشویی، به عنوان یک پیکربندی YAML در نظر گرفته شود:
subagent_defaults:
  explore_files:
    tier: small
    reasoning_effort: low
  implement_feature:
    tier: mid
    reasoning_effort: medium
  security_review:
    tier: frontier
    reasoning_effort: high
این تغییر، گفتگو را از «جائو کدام مدل را در منوی کشویی رها کرده است؟» به «این تفویض اختیار، به چه ظرفیت و عمقی نیاز دارد؟» منتقل میکند.
برای بستن کامل این چرخه، تلهمتری باید چیزی بیشتر از توکنهای هر مدل را ردیابی کند. ما باید سطح انتخاب شده، reasoning_effort، پیچیدگی طبقهبندی شده و نتیجه (تست/بررسی انسانی) را به ازای هر ایجاد عامل ببینیم. دو ایجاد در یک سطح مدل با تلاشهای متفاوت میتوانند در هزینه نهایی تفاوت فاحشی داشته باشند.
تحلیل: تغییر در اقتصاد عاملها
مسیریابی مدل بدون مدیریت تلاش، تنها نیمی از سیاست است. مکمل آن، تصمیمگیری درباره میزان تفکر در آن نمونه خاص است. من در حال تکامل harness-downshift هستم تا اطمینان حاصل کنم که در هنگام ایجاد زیر-عامل، هم سطح مدل و هم تلاش با طبقهبندی تسک همسو باشند. این کار از یک طبقهبندیکننده قطعی (Deterministic) بدون استفاده از LLM در حلقه مسیریاب استفاده میکند و در صورت بروز خطا، به حالت باز (fail-open) میرود.
این چارچوب، فرض بنیادی هوش مصنوعی عاملمحور را از «هوش بیشتر بهتر است» به «دقت در تلاش، همان بهرهوری است» تغییر میدهد. برای کیف پول توسعهدهنده، این تفاوت بین افزایش خطی هزینه و افزایش نمایی هزینه با عمیقتر شدن درختهای عامل است.
با جداسازی سطح مدل از تلاش، توسعهدهندگان میتوانند برای «هزینه به ازای هر تسک موفق» بهینهسازی کنند، نه فقط هزینه به ازای هر توکن. برنده واقعی، عامل در سطح تولید (Production-grade) است که اکنون میتواند بدون ورشکست کردن پروژه از طریق «بیش-تفکری» (Over-thinking) در کارهای پیشپاافتاده، مقیاسپذیر شود. برای پیادهسازی این موضوع، ایجاد زیر-عاملهای خود را ممیزی کنید. شناسایی کنید کدام تسکهای مکانیکی هنوز تلاش «بالا» را از جلسه سطح پیشرو شما به ارث میبرند و قانونی برای کاهش فوری (Downshift) آنها بنویسید.
گام بعدی شما
- فراخوانیهای API خود را بررسی کنید و ببینید آیا برای تسکهای مکانیکی (مثل فرمت کردن کد)، پارامتر
reasoning_effortروی High است یا خیر. - یک ماتریس ساده برای تسکهای پرتکرار تیمتان بسازید و سطح مدل و تلاش را برای هر کدام تعریف کنید.
- در سیستمهای چندعاملی، تنظیمات پیشفرض فرزندان را از والد جدا کنید تا از ارثبری هزینههای غیرضروری جلوگیری شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو