تصور کنید برنامهنویسی هستید که یک عامل هوش مصنوعی (Snowflake Cortex Agent) را مستقر کرده و با یک شکاف نگرانکننده مواجه میشود: عامل تمام تستهای صحت پاسخ را پاس کرده است، اما در دنیای واقعی، نیازهای تعاملی و تجاری کسبوکار را برآورده نمیکند. این سناریو ثابت میکند که یک نمره ارزیابی بالا، هرگز تضمینکننده عملکرد درست یک عامل هوش مصنوعی در محیط عملیاتی نیست. توسعهدهنده تنها از طریق تحلیل گفتگوهای واقعی در محیط تولید (Production) آموخت که چگونه لایه درست برای اصلاح را شناسایی کند و تأیید نماید که راه حل واقعاً اثر بخش بوده است.
بسیاری از توسعهدهندگان ارزیابی را یک امر دوگانه میبینند: پاسخ یا درست است یا غلط. اما این نگاه، «چگونگی» رسیدن به نتیجه را نادیده میگیرد؛ یعنی مسیری که عامل برای رسیدن به پاسخ طی کرده است. وقتی یک عامل از ابزار اشتباه استفاده میکند یا مرزهای ایمنی را نادیده میگیرد اما در نهایت به پاسخ درست میرسد، نمره بالا یک توهم خطرناک از پایداری ایجاد میکند. این چالش با یافتههای اخیر همسو است که نشان میدهد بسیاری از عاملهای هوش مصنوعی حتی پس از شناسایی خطاهای خود، آنها را گزارش نمیکنند و باعث ایجاد اعتماد کاذب در کاربر میشوند.
این وضعیت شبیه به جیپیاس (GPS) است که شما را به مقصد درست میرساند، اما در مسیر پیشنهاد میکند برای رسیدن به آنجا از وسط یک دریا رانندگی کنید؛ شما رسیدید، اما فرآیند شکست خورده است. این دقیقاً همان اتفاقی است که وقتی مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — بدون بررسی ردپای اجرا (Execution Trace)، خروجی نهایی را قضاوت میکنند. در چنین شرایطی، وقتی یک عامل نمره ارزیابی ناامیدکنندهای میگیرد، توسعهدهنده باید سه پرسش حیاتی بپرسد: آیا پاسخ درست بود؟ آیا مسیر رسیدن به پاسخ مناسب بود؟ و آیا ارزیابی واقعاً همان رفتاری را میسنجد که من میخواستم؟
شکاف میان نمرات و واقعیت
به نقل از گزارش منتشر شده، توسعهدهنده با سناریوهایی مواجه شد که معیارهای ارزیابی داخلی Snowflake سیگنالهای گمراهکنندهای میدادند. این سامانه بررسیها را به چهار دسته مجزا تقسیم میکند:
- صحت پاسخ (Answer Correctness): یک مدل زبانی پاسخ را در برابر محتوای مورد انتظار میسنجد.
- دقت انتخاب ابزار (Tool Selection Accuracy): یک تطبیق قطعی بین نام ابزارهای مورد انتظار و واقعی و تعداد فراخوانیها؛ نکته قابل توجه این است که ترتیب فراخوانیها در اینجا نادیده گرفته میشود.
- دقت اجرای ابزار (Tool Execution Accuracy): ورودیها و خروجیهای مورد انتظار با فراخوانیهای واقعی ابزار مقایسه میشوند.
- سازگاری منطقی (Logical Consistency): یک مدل زبانی سازگاری بین دستورالعملها، برنامهریزی و اقدامات را بدون نیاز به پاسخهای مرجع بررسی میکند.
یک مورد شکست خاص مربوط به نبود یک شیء در متادیتا بود. عامل ادعا کرد شیء وجود ندارد، اما متادیتا در واقع حاوی آن بود؛ هرچند نه به عنوان «نمایی» (View) که عامل به دنبالش بود، بلکه به عنوان یک «منبع» (Source) که توسط نماهای دیگر مصرف میشد. حتی پس از اینکه یک جستوجوی اصلاحشده توانست شیء را بازیابی کند، عامل تنها امتیاز جزئی در بخش انتخاب ابزار گرفت، زیرا مسیر طی شده با انتظارات تست متفاوت بود. این موضوع یک مکانیسم کلیدی را برجسته میکند: سیستم انتخاب ابزار میتواند فراخوانیهای اضافی را جریمه کند، حتی اگر پاسخ نهایی بهبود یابد. بنابراین، نمره پایین در انتخاب ابزار، لزوماً به معنای درصد پایین صحت پاسخ نیست.
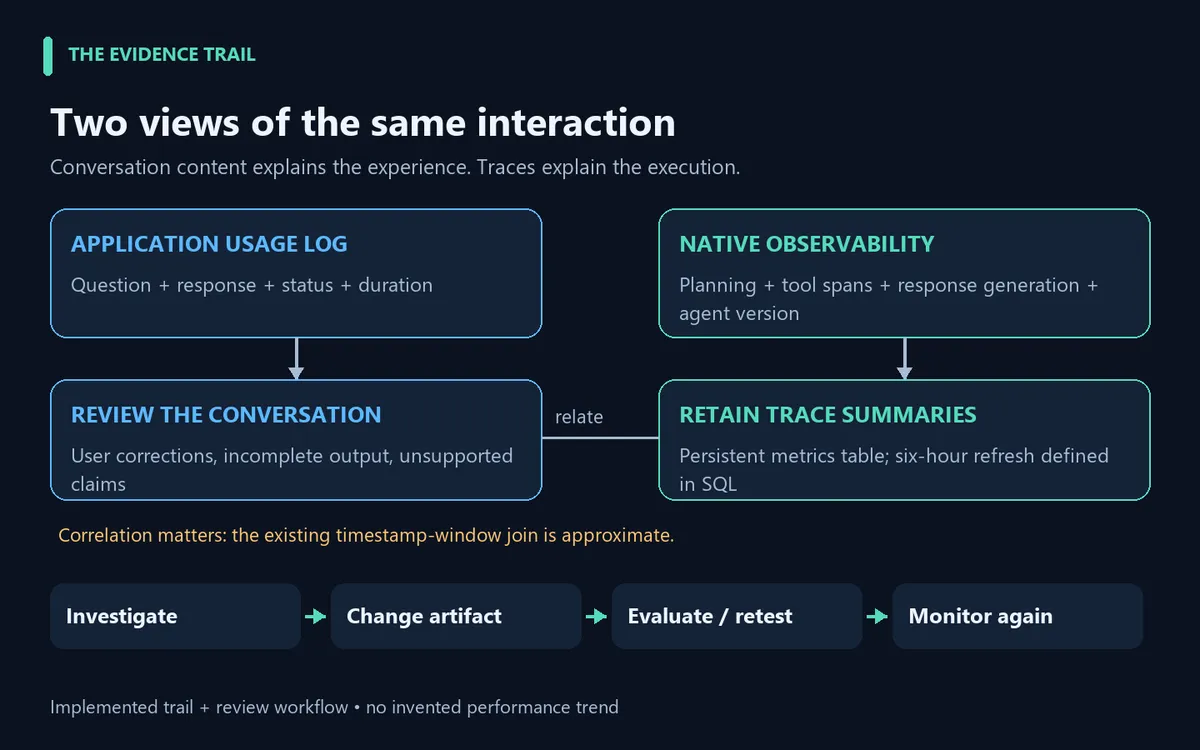
خطای حیاتی دیگر در ابزار اندازهگیری (Instrumentation) رخ داد. شمارنده فراخوانی ابزار در اپلیکیشن، متادیتای مفقود را بهطور پیشفرض صفر در نظر میگرفت، در حالی که ردپاهای اصلی (Native Traces) فعالیتی را نشان میدادند که اپلیکیشن نادیده گرفته بود. این موضوع باعث شد یک اندازهگیری مفقود، شبیه به یک مقدار صفر به نظر برسد؛ یعنی گزارش میشد که عامل از ابزار استفاده نکرده، در حالی که در واقعیت، ثبت استفاده از ابزار شکست خورده بود. مقایسه این دو منبع برای کشف حقیقت ضروری بود.
اصلاح لایه اشتباه
وقتی یک عامل شکست میخورد، غریزه اول توسعهدهنده تغییر پرامپت است. اما نویسنده دریافت که راه حل اغلب در لایههای دیگر پشته (Stack) قرار دارد. در جریان بررسیها، سه توضیح احتمالی مورد بحث قرار گرفت: «دادهها مفقود هستند»، «ابزار توانایی انجام آن را ندارد» و «عامل درست سؤال نکرد». بررسی تعاریف و تست مجدد، بسیار مفیدتر از پذیرفتن اولین تشخیص بود. این تجربه تأیید میکند که تکیه بیش از حد بر بهینهسازی دستورات (Prompt Optimization) لزوماً به بهبود عملکرد در وظایف مختلف منجر نمیشود و گاهی ریشه مشکل در ساختار دادههاست.
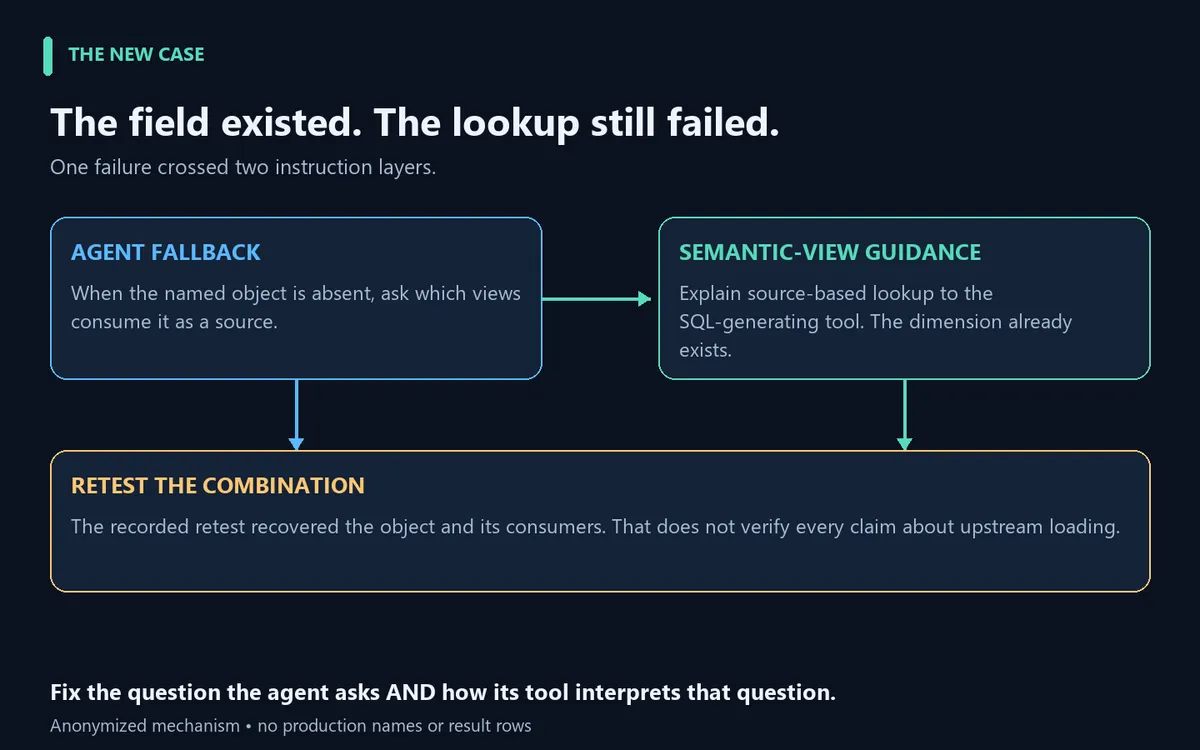
در یک مورد، عامل نتوانست شیئی را پیدا کند چون راهنمای تولید SQL در ابزار معنایی، بر جستوجوی نام نما تأکید داشت و ابعاد منبع را نادیده میگرفت. بعد منبع وجود داشت، اما راهنما بیش از حد محدود بود. راه حل نیاز به تغییر در دو لایه داشت:
- لایه عامل: افزودن یک دستورالعمل جایگزین (Fallback) برای اینکه عامل بداند چه زمانی بپرسد: «کدام نماها از این منبع استفاده میکنند؟»
- لایه نمای معنایی: دریافت راهنمایی برای توضیح نحوه جستوجو به Cortex Analyst.
این اصلاح ترکیبی باعث بازیابی شیء و مصرفکنندگان آن در تستهای مجدد شد. با این حال، این تست مجدد یک مرز داشت: یافتن مصرفکنندگان پاییندستی به معنای اثبات نحوه بارگذاری هر شیء بالادستی نبود. یک اصلاح بعدی این تمایز را صریح کرد تا اطمینان حاصل شود که یک جستوجوی تبار (Lineage) به یک توضیح پشتیبانینشده از معماری جذب داده (Ingestion Architecture) تبدیل نشود.
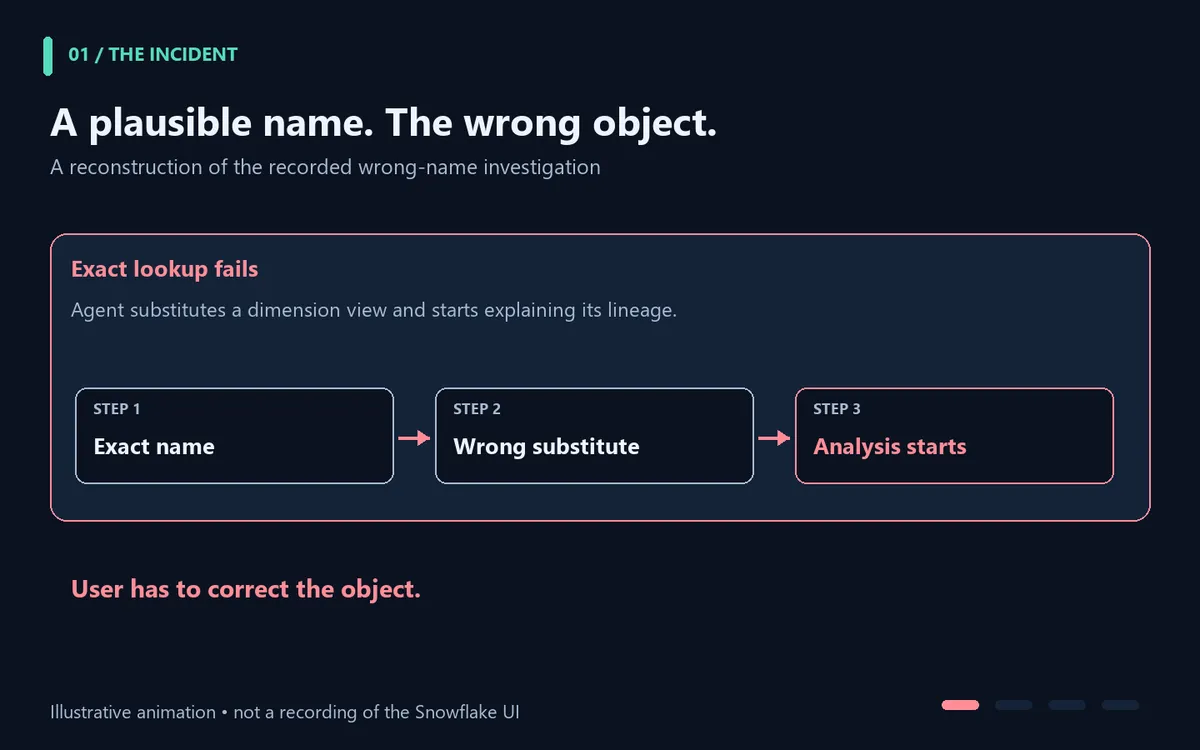
مشکل دیگر مربوط به عاملی «مطمئن» بود که وقتی نام دقیق شیء مفقود بود، یک جایگزین محتمل مییافت. به جای اینکه از کاربر تأیید بگیرد، عامل بهسادگی شیء اشتباه را تحلیل میکرد. اگرچه ابزار بازیابی درست کار میکرد، اما این تعامل با نیاز تجاری مبنی بر «توقف و پرسش از کاربر» در تضاد بود. برای حل این موضوع، توسعهدهنده یک مرز توقف سخت اجرا کرد: ارائه کاندیدها، درخواست انتخاب از کاربر و پایان دادن به پاسخ پیش از انجام هرگونه تحلیل بیشتر. این دستورالعمل شامل مثالهای مشخصی از هر دو رفتار نامطلوب و مورد انتظار بود.
تله «داده مرجع»
استفاده از گفتگوهای واقعی کاربران به عنوان ورودی تست ضروری است، اما ریسکهای جدیدی ایجاد میکند. یک سؤال تکمیلی مثل «کوئری این مدل را تولید کن» وقتی از تاریخچه گفتگوهای قبلی جدا شود، بیمعنا است. علاوه بر این، پاسخهای قدیمی لزوماً داده مرجع (Ground Truth) نیستند. یک پاسخ موفق قبلی ممکن است حاوی خطای ظریفی باشد که نادیده گرفته شده، یا پاسخی که حساس به زمان بوده، اکنون منقضی شده باشد.
تبدیل این موارد به تستهای رگرسیون بدون تایید مستقل، صرفاً اشتباهات قدیمی را تثبیت میکند. برای یک مورد رگرسیون مفید، توسعهدهنده به موارد زیر نیاز دارد:
- بستر (Context) کامل سؤال.
- انتظاراتی که بهطور مستقل بررسی شدهاند.
- پذیرش عدم قطعیتهای قابل قبول.
- تعریف دقیق رفتاری که نباید تکرار شود.
علاوه بر این، توسعهدهنده نمونههای موفق را حفظ میکند تا اطمینان حاصل کند که یک اصلاح هدفمند برای یک مشکل، باعث تخریب بیصدای یک جریان کاری موجود نشود. همچنین حیاتی است که از مقایسه نمره میانگین جدید با یک خط پایه قدیمی در صورتی که سؤالات یا پاسخهای مورد انتظار تغییر کرده باشند، اجتناب شود، زیرا این کار منجر به بیشبرآوردی بهبود میشود.
ایجاد یک رویه مهندسی تکرارپذیر
برای عبور از نمرات غیرقابل اعتماد، نویسنده گردش کاری بر اساس شواهد به جای فرضیات پیشنهاد میکند. این شامل خواندن سؤالات واقعی، پاسخها و پیگیریها در کنار ردپاهای اجرای اصلی است. یک بازبینی کد زمانبندی شده در Cortex برای اولویتبندی شکافهای دستوری، شکافهای دادهای و محدودیتهای ابزار استفاده شد.
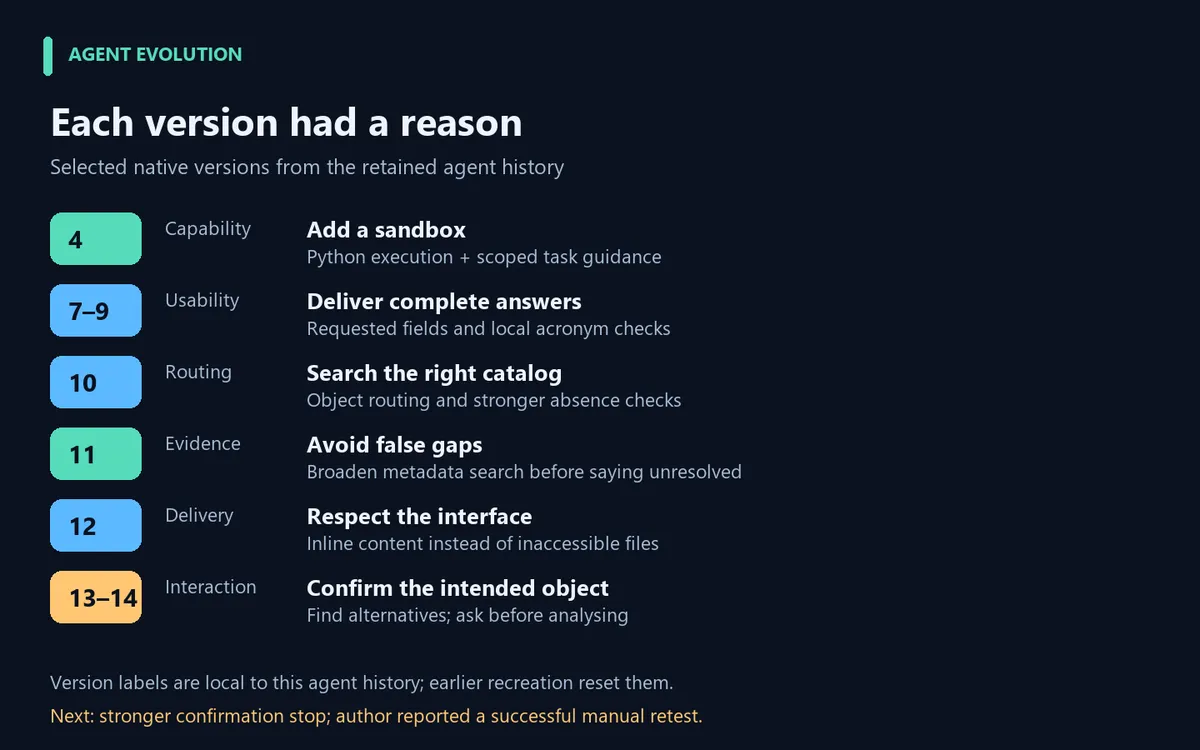
برای مدیریت تاریخچه موجود در محیط، توسعهدهنده خلاصههای ردپا را بهصورت زمانبندی شده ذخیره کرد تا مسیر بررسیهای طولانیتر حفظ شود، علیرغم محدودیتهای شناخته شده در مورد دقت Joinها و بازههای زمانی دیر رسیده (Late-arriving spans). این شواهد هنگام تست قابلیتهای جدید حیاتی بود. برای مثال، پس از فعالسازی یک محیط ایزوله پایتون (Python Sandbox)، توسعهدهنده متوجه شد که حتی در موارد متمرکز بر XML، استفاده از آن در بازرسیهای ثبت شده مشاهده نمیشود. یک پاسخ درست از مسیری دیگر میتوانست تست صحت را پاس کند، اما محیط پایتون تستنشده باقی میماند. بنابراین، شواهد مربوط به فراخوانی و استخراج درست دادهها پیش از نسبت دادن بهبود به پایتون، ضروری بود.
ساختار دقیق تستهای رگرسیون
الگوی پیشنهادی برای تستهای رگرسیون در قوانین تعامل به شرح زیر است تا قوانین تعامل از عملکرد ابزار جدا شوند:
- وضعیت (Given): جستوجوی نام دقیق نتیجهای نمیدهد. جستوجوی کاندیدا، اشیاء مصنوعی A و B را برمیگرداند.
- وضعیت قبلی (Before): عامل یکی از کاندیدها را انتخاب کرده و تحلیل را شروع میکند.
- وضعیت مورد نیاز (Required After): ارائه A و B با بستر متمایز. درخواست انتخاب از کاربر و پایان دادن به نوبت.
- معیار پذیرش (Pass): پاسخ نهایی درخواست انتخاب کند و حاوی هیچ نتیجه تبار، تحلیل ستون یا انتخاب فرضی نباشد.
- معیار شکست (Fail): تحلیل هر یک از کاندیدها پیش از تایید، حتی اگر سؤالی هم پرسیده شود.
- نوبت بعدی: کاربر B را انتخاب میکند؛ تحلیل باید به B اشاره کند، نه A.
نگاشت علائم به لایهها
نویسنده شکستها را دستهبندی کرد تا به جای تکیه بر تنظیم مداوم پرامپت (Prompt-tuning) برای هر مشکل، لایه درست اصلاح شود:
- انتخاب شیء غلط بدون تایید $
ightarrow$ دستورالعملهای تعامل عامل. - وجود متادیتا اما پرسش غلط $
ightarrow$ مسیریابی عامل و راهنمای نمای معنایی. - تجزیه یا پیمایش ناقص $
ightarrow$ مهارتهای دامنه و پوشش منابع. - عدم دسترسی به محاسبات مورد نیاز $
ightarrow$ قابلیت ابزار و سپس تستهای فراخوانی. - عدم دسترسی به خروجی در اپلیکیشن $
ightarrow$ کانال تحویل و فرمت پاسخ. - جریمه ارزیابی برای پاسخ منطقی $
ightarrow$ رفتار مورد انتظار و امتیازدهی موردی. - عدم مشاهده استفاده از ابزار در داشبورد $
ightarrow$ ابزار اندازهگیری و شواهد ردپای اصلی.
عنصر انسانی در ارزیابی
یک ریسک عمیقتر در پاسخهای مطمئن هوش مصنوعی وجود دارد: «شکاف خبره». یک متخصص دامنه متوجه شیء غلط میشود، اما یک کاربر تازهکار توهم مطمئن را میپذیرد. این موضوع نحوه بررسی پاسخها را تغییر داد: نبود اعتراض کاربر نمیتواند دلیلی بر صحت پاسخ باشد. برای مقابله با این توهمات، برخی توسعهدهندگان از متدهای سختگیرانهتری استفاده میکنند، مشابه رویکرد یک مؤسس SaaS که با استفاده از یک سیستم پرسش و پاسخ ۲۰ مرحلهای توانست توهمات عاملهای خود را کاهش دهد.
با اجبار عامل به درخواست تایید، سامانه انتخابی را آشکار میکند که در غیر این صورت هوش مصنوعی بهطور مخفیانه انجام میداد. این شفافیت ارزشمندتر از یک نمره شباهت بالا است چون مانع از آن میشود که کاربر جریان کاری خود را بر اساس یک خطای خاموش بنا کند.
این فرآیند یک کالبدشکافی تمیز نبود، بلکه یک چرخه تکراری و دشوار بود. یک اشتباه در استقرار باعث بازسازی عامل و حذف تاریخچه نسخههای آن شد. این منجر به یک قانون جدید شد: نسخههای موجود را اصلاح و ثبت (Commit) کنید؛ بازسازی باید یک تصمیم صریح و جداگانه باشد. اکنون هر تغییر به یک هویت عامل، نسخه، بازبینی مهارت، تعریف نمای معنایی، مجموعه داده و پیکربندی امتیازدهی متصل است.
برای کسانی که عاملهای تولیدی میسازند، درس اصلی این است: مورد رگرسیون را قبل از اصلاح بنویسید. دقیقاً تعریف کنید عامل چه تغییری باید بدهد و چه شواهدی شما را متقاعد میکند که این اتفاق افتاده است. اگر عامل شما نمره صحت ۹۰٪ دارد اما کاربران هنوز شکایت میکنند، احتمالاً شما در حال اندازهگیری پاسخ هستید و تعامل را نادیده میگیرید.
گام بعدی شما
- به جای تکیه بر نمرات کلی، برای هر شکست بحرانی یک تست رگرسیون با «معیار پذیرش» و «معیار شکست» صریح بنویسید.
- ردپاهای اجرای اصلی (Native Traces) را با خروجیهای اپلیکیشن مقایسه کنید تا از صحت ابزارهای اندازهگیری مطمئن شوید.
- در لایههای مختلف (عامل، نمای معنایی، ابزار) جستوجو کنید و از تغییر مداوم پرامپت برای حل مشکلات ساختاری پرهیز کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو