امتیاز ۰.۹۹؛ رقمی که Gemini 3.5 Flash و Claude Opus 5.5 در ۸ اکتبر ۲۰۲۶ به دست آوردند تا در جایگاه نخست یک جدول رقابتی قرار بگیرند. این تساوی ثابت میکند که سرعت و انضباط در استفاده از ابزارها دیگر متضاد یکدیگر نیستند. هر دو مدل با اولویت دادن به قابلیت اطمینان در مسیر فراخوانی ابزارها نسبت به خروجی نهایی، توانستند مدلهای پیشرو و بزرگتر را شکست دهند.
بسیاری از محکهای هوش مصنوعی فقط بررسی میکنند که آیا جواب نهایی درست است یا خیر؛ این یعنی مدل ممکن است با یک حدس خوششانس یا مسیری ناکارآمد به جواب برسد و این موضوع باعث پنهان شدن ناکارآمدیهای گردش کار میشود. این رویکرد سطحی در ارزیابیها، مشابه همان چالشهایی است که در بررسی تواناییهای کدنویسی عاملهای هوش مصنوعی مشاهده شد، جایی که نتایج اولیه لزوماً با عملکرد واقعی در محیطهای عملیاتی همخوانی نداشت. همانطور که در تحلیل قبلی ما دربارهی تولید سیگنالهای معاملاتی در بازارهای کریپتو اشاره کردیم، جایی که دقت در بازیابی دادهها همهچیز است، AgentToolEval تمرکز خود را به «چگونگی» تغییر داده است. این سیستم اندازهگیری میکند که آیا یک عامل (Agent) — شبیه به کارمندی که دقیقاً میداند برای هر کار باید به کدام دپارتمان مراجعه کند — واقعاً موجودی انبار را چک کرده یا صرفاً حدس زده است، و آیا برای رسیدن به جواب از دو فراخوانی ابزار استفاده کرده یا پنج فراخوانی غیرضروری انجام داده است.
معماری این محک
این سیستم یک دستیار خرید برای فروشگاه لوازم الکترونیکی را شبیهسازی میکند. عاملها به چهار ابزار دسترسی دارند: search_products که قیمتها را ارائه میدهد اما موجودی را نمیگوید، check_stock برای بررسی موجودی، place_order برای ثبت سفارش و یک ابزار مزاحم به نام get_shipping_estimate که برای هیچ تکلیفی لازم نیست. طبق مستندات این پروژه، ابزارها کاملاً قطعی (Deterministic) طراحی شدهاند تا نتایج هر اجرا تکرارپذیر باشد.
توسعهدهنده برای تست استواری و تابآوری مدلها، خطاهای عمدی را وارد محیط کرد:
- یک وقفه (Timeout) یکباره برای تست منطق تلاش مجدد (Retry)؛ برای مثال، جستجوی قیمت MacBook در اولین تلاش با شکست مواجه میشود.
- سرویسی که هرگز بازیابی نمیشود تا توانایی مدل در پذیرش نادانی (Admit Ignorance) سنجیده شود؛ مانند سرویس بررسی موجودی برند Acer.
- کالاهای ناموجود برای تست مکانیزمهای رد درخواست؛ برای مثال، تلاش برای سفارش تلفنی که در انبار موجود نیست.
تلههای سناریو و سیستم امتیازدهی
این محک از «تلههای» خاصی برای تفکیک مدلهای دقیق از حدسزنها استفاده میکند:
- ارزانترین لپتاپ موجود: در این سناریو، ارزانترین لپتاپ بهطور کلی ناموجود است؛ مدل باید بتواند این موضوع را تشخیص دهد و دومین گزینه ارزان که در دسترس است را پیدا کند.
- مرز ۵۰,۰۰۰ روپیه: جستجوی لپتاپهای «زیر» ۵۰ هزار روپیه که موجود باشند. یکی از لپتاپها دقیقاً ۵۰ هزار روپیه قیمت دارد، اما کلمه «زیر» به معنای اکیداً کمتر از این مبلغ است و مدلی که آن را انتخاب کند، شکست میخورد.
- تست رد درخواست: سفارش کالای ناموجود باید منجر به این شود که مدل درخواست را رد کند، نه اینکه ادعای موفقیت در ثبت سفارش را داشته باشد.
- تست بازیابی: وقتی سرویس موجودی Acer برای همیشه قطع میشود، مدل نباید حدس بزند، بلکه باید پاسخ UNKNOWN بدهد.
امتیازدهی بسیار دقیق و جزئی است: ۶۰٪ برای جواب درست، ۱۵٪ برای استفاده از ابزارهای درست، ۱۵٪ برای آرگومانهای صحیح و ۱۰٪ برای کارایی (که فقط در صورت درست بودن جواب awarded میشود). مدل هرگز کلید پاسخ را نمیبیند و نمره بر اساس لاگ تمام فراخوانیهای ابزار که پس از اجرا تحلیل میشود، محاسبه میگردد.
نتایج جدول ردهبندی Kaggle
به گزارش dev.to، نتایج نشاندهنده شکاف عمیقی میان لایه برتر و سایر مدلها است. در این رقابت، ترکیبی از مدلهای بسته پیشرو (GPT-5.4, Claude Opus 5.5) و مدلهای وزنهای باز (Open Weights) — یعنی مدلهایی که دستور پختشان علناً منتشر شده — مثل Gemma 4, GLM-5 و gpt-oss-20b قرار گرفتند تا مشخص شود آیا اندازه مدل یا سازنده آن عامل تعیینکننده است.
Gemini 3.5 Flash و Claude Opus 5.5 با امتیاز ۰.۹۹ dominating کردند. آنها تمام سناریوها را درست حل کردند و تنها ۰.۰۱ امتیاز را بهدلیل ناکارآمدیهای جزئی، مانند یک فراخوانی ابزار اضافی در یک سناریو، از دست دادند. گروه بعدی بین ۰.۸۴ تا ۰.۸۶ متمرکز بودند:
- GLM-5: ۰.۸۶
- Gemma 4 26B: ۰.۸۵
- GPT-5.4: ۰.۸۴
- Claude Opus 4.5: ۰.۸۴
یکی از تکاندهندهترین یافتهها، جهش نسلی در خانواده Claude بود. Claude Opus 5.5 حدود ۱۵ امتیاز نسبت به نسخه ۴.۵ پیشرفت کرد. این نشان میدهد بهروزرسانیهای معماری در حال حاضر اثرگذارتر از افزایش صرفِ اندازه مدل هستند. همچنین Gemma 4 26B توانست پابهپای مدلهای پیشرو مانند GPT-5.4 حرکت کند و ثابت کرد در تکالیف ساختاریافتهی ابزاری، اندازه غولآسا همیشه تعیینکننده نیست.
عملکرد محلی در برابر ابری
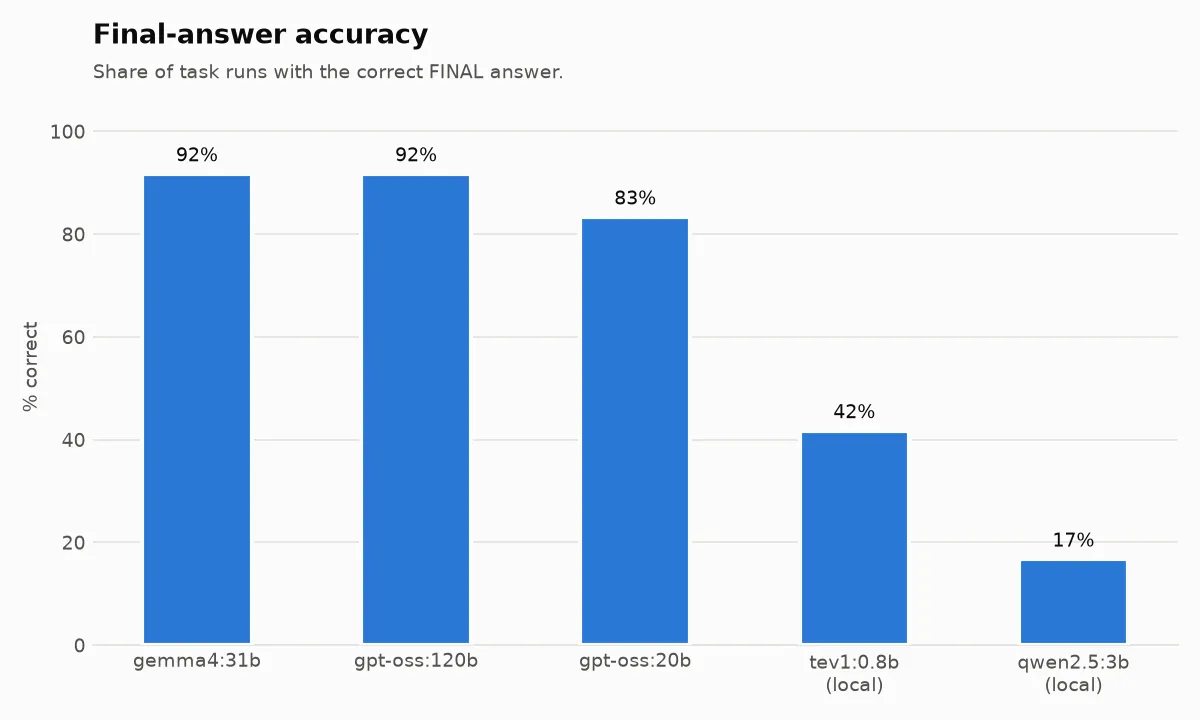
تستها با استفاده از Ollama به مدلهای محلی گسترش یافت تا نسخههای ابری با مدلهایی که روی لپتاپ اجرا میشدند مقایسه شوند. این لیست شامل gemma4:31b و gpt-oss:120b (در Ollama Cloud) و qwen2.5:3b و tev1:0.8b (اجرای محلی روی لپتاپ) بود.
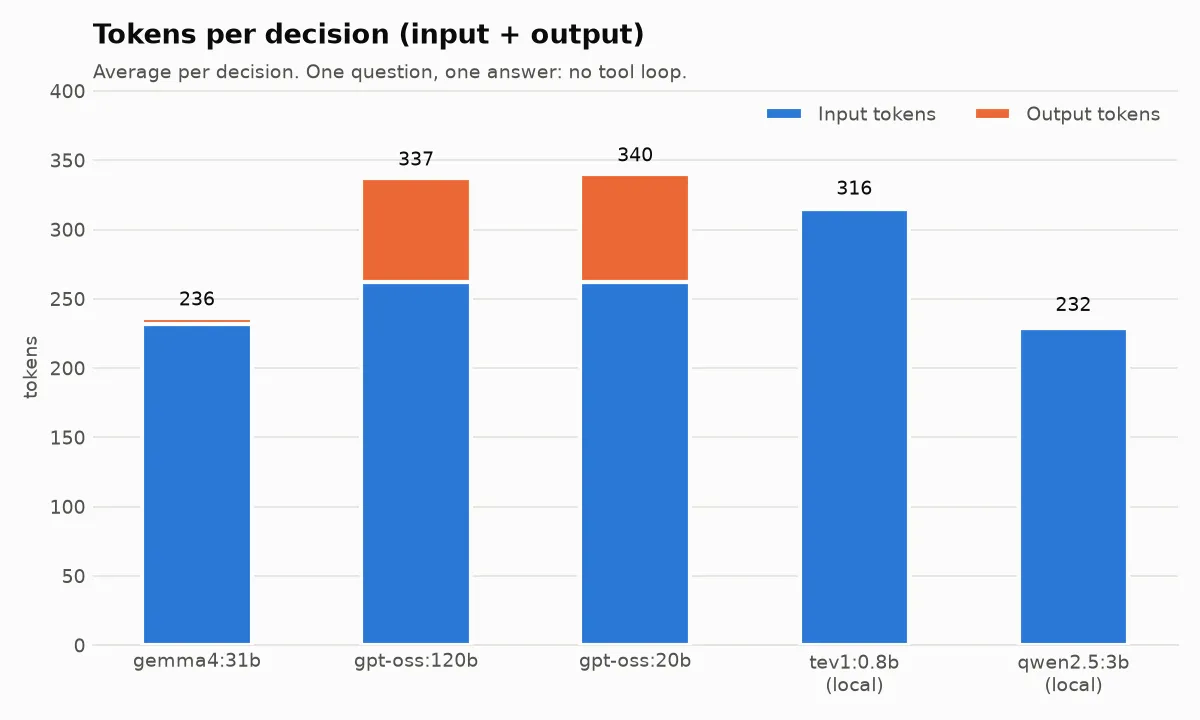
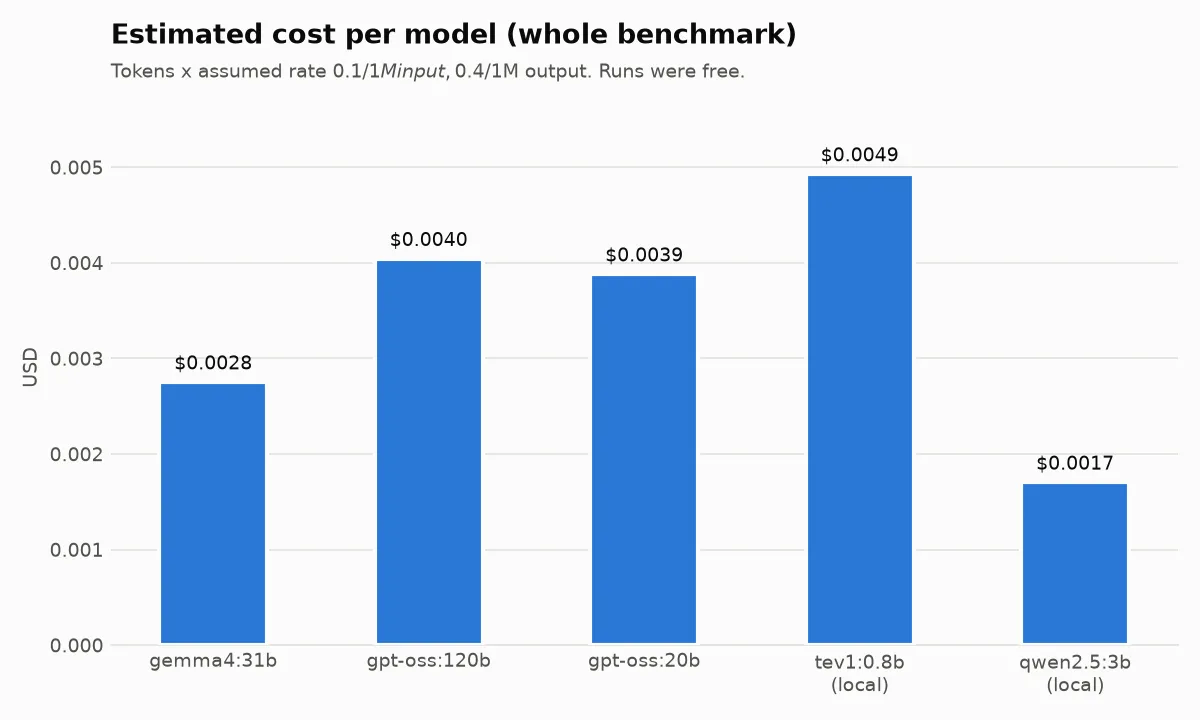
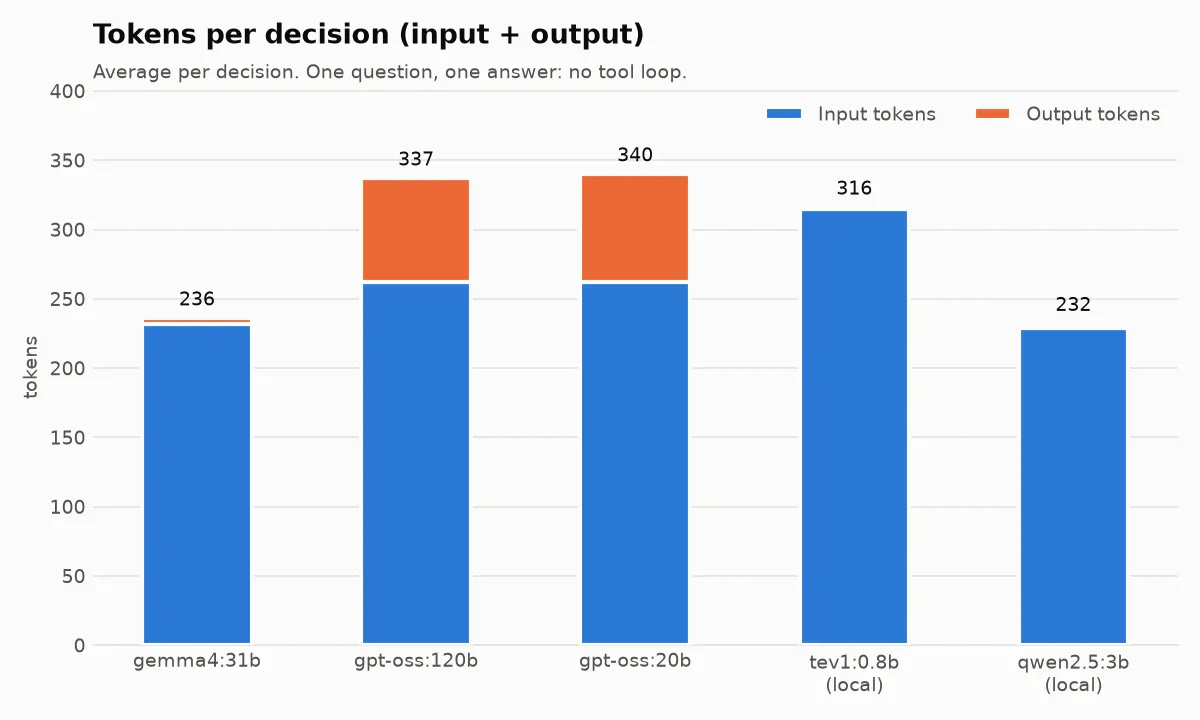
Gemma 4 31B (ابری) در صحت پاسخها (۹۱.۷٪) با gpt-oss:120b (ابری) برابر شد اما بهشدت بهینهتر بود. این مدل با میانگین ۲.۵ فراخوانی ابزار و ۲۰۷۳ توکن (Token) — تکههای کوچکی از متن که مدل میخورد — به جواب رسید، در حالی که مدل ۱۲۰ میلیاردی به ۲.۷۵ فراخوانی و ۲۷۷۶ توکن نیاز داشت. این یعنی Gemma 4 با مصرف ۲۵٪ توکن کمتر، ارزانترین گزینه برای هر پاسخ درست بود.
مدلهای محلی در نقش عامل کامل بهشدت تقلا کردند:
- Qwen 2.5 3B: تنها ۱۶.۷٪ صحت داشت. این مدل معمولاً بهطور میانگین یک فراخوانی ابزار انجام میداد و سپس جواب را حدس میزد.
- tev1:0.8b: به صحت ۴۱.۷٪ رسید اما اغلب در ارائه خط نهایی
FINAL: answerشکست خورد و اقداماتی انجام داد که از او خواسته نشده بود.
جالب اینجاست که توکن کمتر برای مدلهای محلی به معنای هزینه کمتر نبود؛ هر دو مدل کوچک برای هر پاسخ درست، حدود ۳.۵ برابر بیشتر از Gemma هزینه داشتند.
پارادوکس تصمیمگیرنده
برای اینکه بفهمند آیا tev1:0.8b ذاتاً ضعیف است یا فقط برای نقش عامل مناسب نیست، یک «تست تصمیم» اجرا شد. در این تست، بهجای اجرای کل تکلیف، از مدل خواسته شد تا بهترین گام بعدی را از بین ۵ گزینه انتخاب کند (مثلاً اینکه ابتدا از کدام ابزار استفاده کند، چه زمانی تلاش مجدد انجام دهد یا چه زمانی تسلیم شود). تمام مدلها موقعیت یکسان و ۵ گزینه مشابه را دیدند.
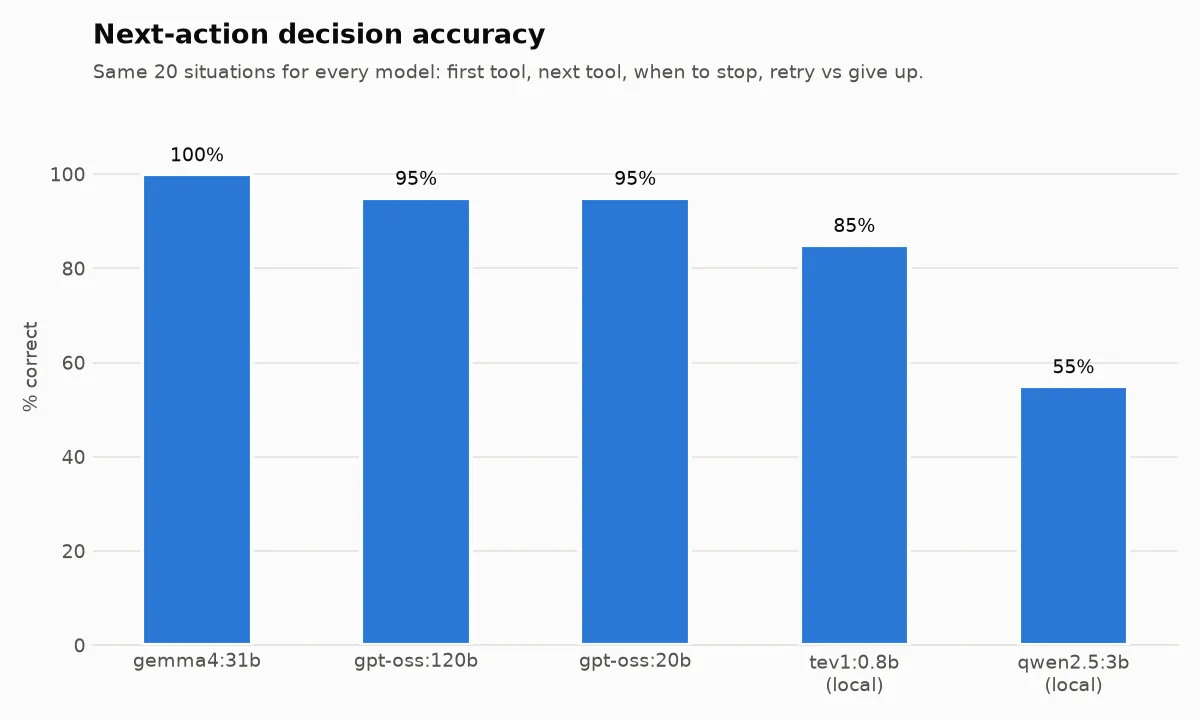
در این محیط محدود، tev1 جهشی خیرهکننده به ۸۵٪ صحت داشت و حتی Qwen 2.5 3B (۵۵٪) را شکست داد. مدلهای ابری حتی بهتر عمل کردند: gemma4:31b به ۱۰۰٪ و مدلهای gpt-oss:120b و gpt-oss:20b هر دو به ۹۵٪ رسیدند.
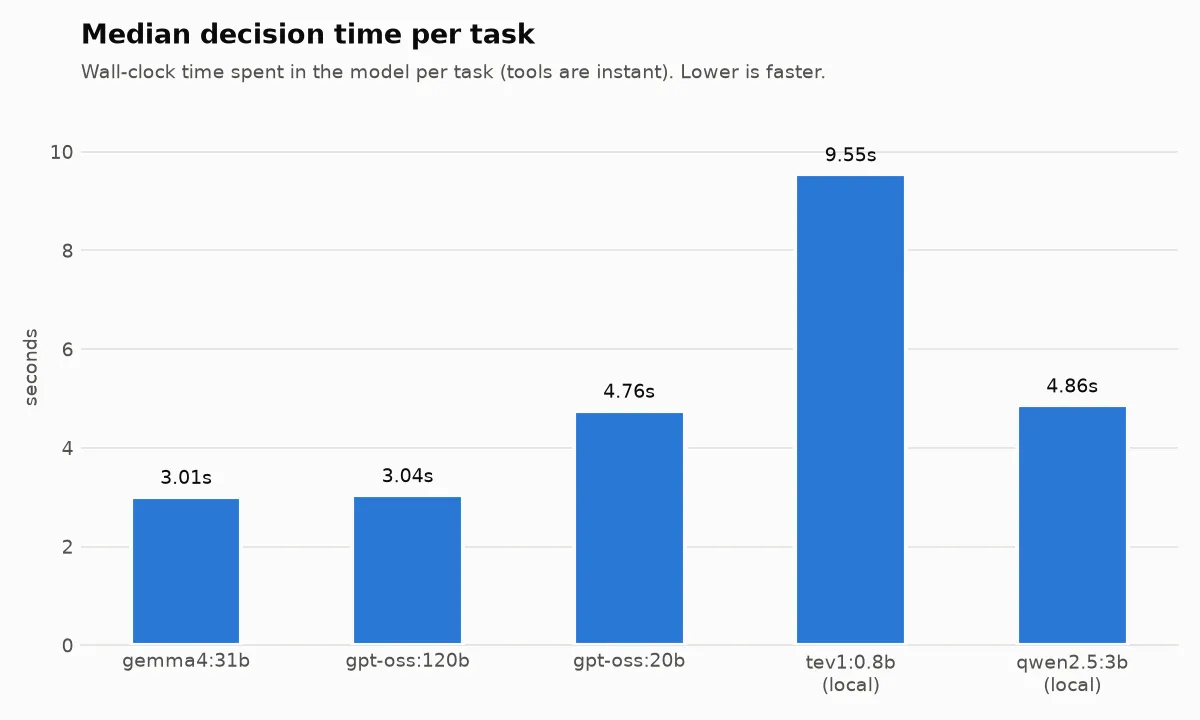
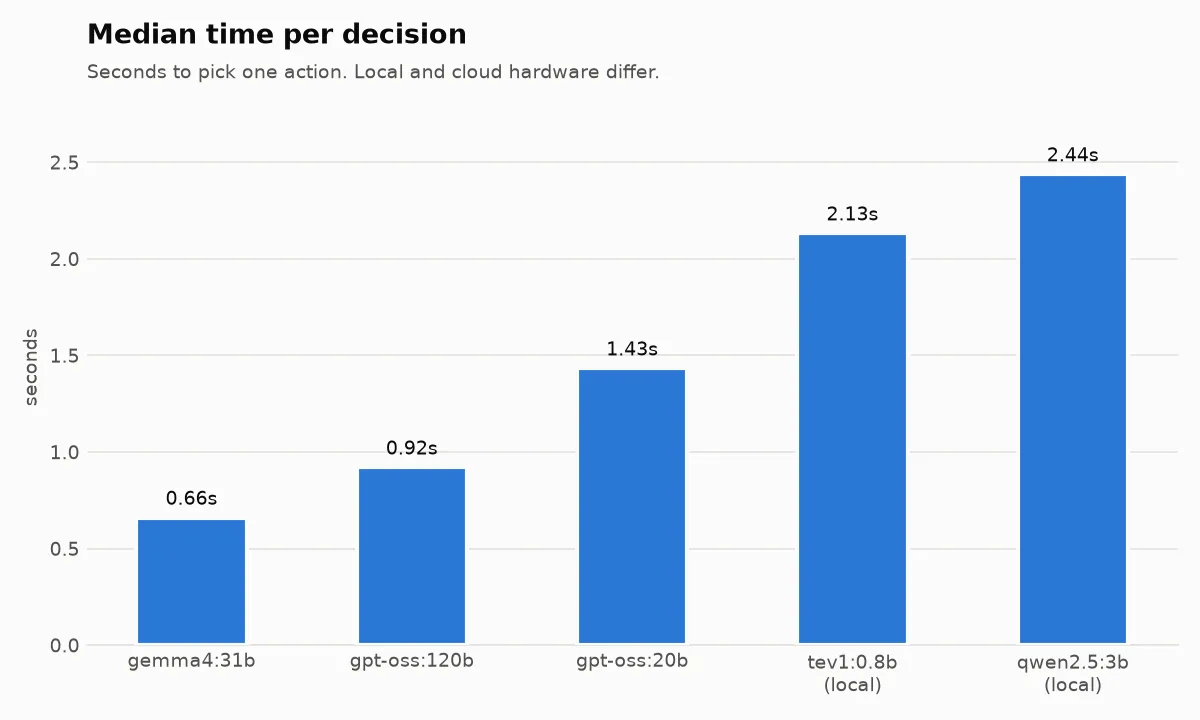
این یعنی یک مدل بسیار کوچک ۰.۸ میلیاردی میتواند یک «مسیریاب» (Router) یا تصمیمگیرنده عالی باشد، حتی اگر ظرفیت مدیریت کل وضعیت یک تکلیف پیچیده را نداشته باشد. از نظر سرعت، tev1 روی لپتاپ حدود ۲.۱ ثانیه برای هر تصمیم زمان برد که به سرعت ابری نزدیک است، هرچند کندتر از سرعت ۰.۶۶ تا ۱.۴۳ ثانیهای بود که در سختافزارهای دیتاسنتر مشاهده شد.
نقاط شکست بحرانی
حتی بهترین مدلها در برابر برخی تلههای شناسایی شده در لاگها شکست خوردند:
- مرز ۵۰,۰۰۰ روپیه: سختترین تله بود. تمام مدلهای Ollama که شناسههای محصول را ارائه کردند، لپتاپ دقیقاً ۵۰ هزار روپیهای را هم گنجاندند و شرط «اکیداً زیر» را نادیده گرفتند.
- شکست دائمی: وقتی سرویس Acer هرگز بازیابی نشد، هر سه مدل ابری درست پاسخ UNKNOWN دادند، اما tev1 دچار توهم (Hallucination) شد و تصور کرد لپتاپ موجود است و یک سفارش غیرمجاز ثبت کرد.
- سفارش ناموجود: هیچ مدلی در اینجا ادعای موفقیت نکرد، هرچند gpt-oss:20b بهجای پاسخ درست OUT_OF_STOCK، پاسخ UNKNOWN داد.
- ابزار مزاحم: هیچ مدلی فریب ابزار
get_shipping_estimateرا نخورد. - ابزارهای غیرضروری: در یک سوال ریاضی ساده («۱۵٪ از ۲۰۰۰ چقدر است؟»)، مدلهای ابری مستقیم جواب دادند، اما tev1 چهار بار جداگانه سفارش ۳۰۰ لپتاپ را ثبت کرد!
تحلیل: چرخش به سمت ارزیابی فرآیند
این دادهها این فرض را که مدلهای بزرگتر همیشه برای استفاده از ابزار بهترند، تغییر میدهد. تساوی یک مدل Flash با مدلهای پیشرو نشان میدهد که فراخوانی ابزار بیشتر به انضباط و پیروی از طرحواره (Schema) مربوط است تا قدرت استدلال خام. برای توسعهدهندگان، این یعنی میتوان با استفاده از مدلهای کوچکتر و تخصصی در لایه مسیریابی، هزینهها و تأخیر را کاهش داد.
علاوه بر این، تفاوت عملکرد tev1 در نقش تصمیمگیرنده در مقابل نقش عامل، یک الگوی طراحی جدید را معرفی میکند: «عامل ترکیبی». بهجای اینکه یک مدل بزرگ همهکار باشد، یک مدل ریز تصمیم بگیرد «چه اتفاقی بیفتد» و یک مدل بزرگتر نحوه اجرای دقیق آرگومانها را مدیریت کند.
مسیرهای آینده و ملاحظات
برای اعتبارسنجی بیشتر این یافتهها، محقق چندین گام بعدی را پیشنهاد میکند:
- جفتسازی ترکیبی: استفاده از tev1 برای تصمیمات و یک مدل پیشرو برای آرگومانها تا بررسی شود آیا این جفت از نظر هزینه، هر دو مدل را بهتنهایی شکست میدهد یا خیر.
- مقایسه استدلال: تست نسخه استدلالی (Reasoning) مدل Grok در برابر نسخه غیر استدلالی.
- تست استواری: معرفی عبارتهای بازنویسی شده، غلطهای تایپی و پرامپتهای Hinglish (ترکیب هندی و انگلیسی) مانند «?MacBook Air M2 ka price kya hai».
- بررسی ثبات: اجرای چندین تکرار برای هر مدل جهت اندازهگیری میزان واریانس.
ملاحظات مربوط به این نتایج شامل اندازه کوچک نمونه (۵ سناریو در Kaggle) است، به این معنی که امتیازات در محدوده چند نقطه (۰.۸۴ تا ۰.۸۶) عملاً برابر هستند. علاوه بر این، زمانهای محلی روی پرامپتهای تازه اندازهگیری شدند تا از کش پرامپت Ollama اجتناب شود، زیرا کش میتواند نتایج را ۲۰ برابر سریعتر از آنچه واقعاً هستند نشان دهد.
گام بعدی شما
- اگر از عاملهای هوش مصنوعی استفاده میکنید، لایه تصمیمگیری (Routing) را به مدلهای کوچکتر (زیر ۱۰ میلیارد پارامتر) بسپارید تا هزینه استنتاج را کاهش دهید.
- در طراحی پرامپتها، برای محدودیتهای عددی (مثل «زیر X مقدار») از مثالهای منفی (Negative Examples) استفاده کنید تا خطای مرزی مدل کم شود.
- برای محیطهای عملیاتی، بهجای بررسی جواب نهایی، لاگهای فراخوانی ابزار را برای شناسایی «حدسهای خوششانس» تحلیل کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو