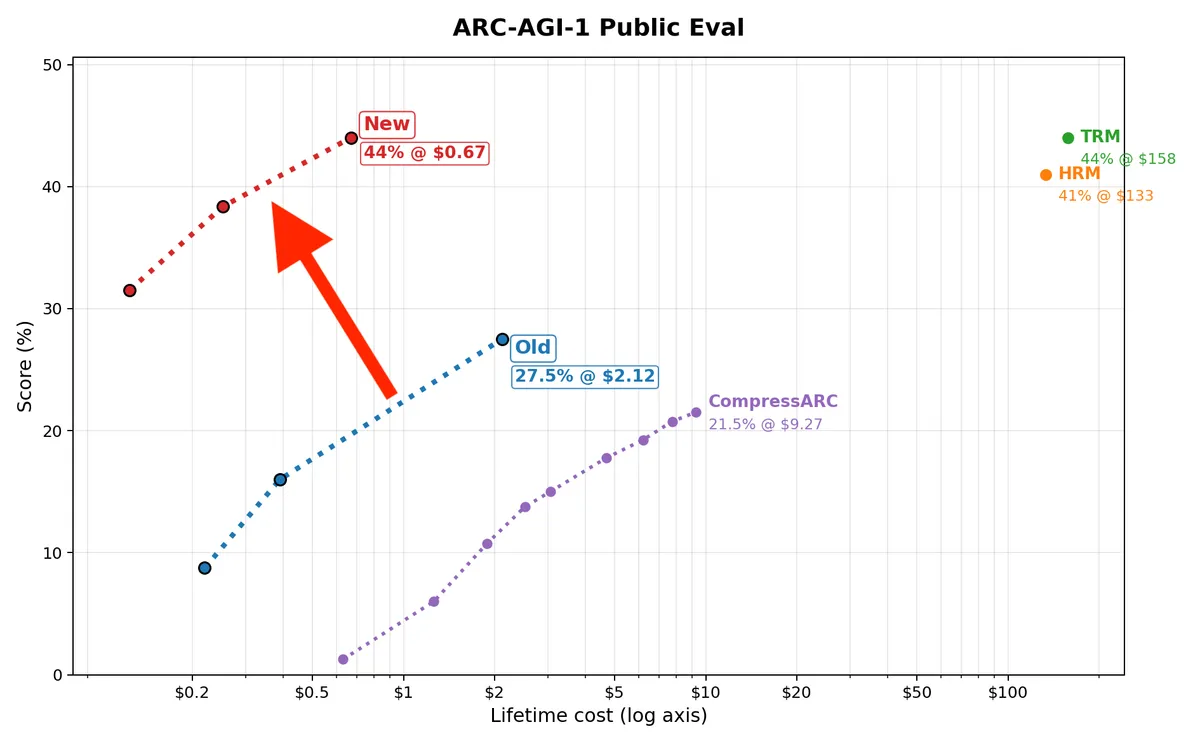
تصور کنید تمام هزینهی آموزش یک مدل هوش مصنوعی که میتواند پازلهای پیچیده انتزاعی را حل کند، کمتر از قیمت یک فنجان قهوه باشد. ۶۷ سنت؛ این تمام هزینهی محاسباتی است که یک پژوهشگر برای رسیدن به امتیاز ۴۴٪ در محک ARC-AGI-1 صرف کرده است.
به نقل از گزارش منتشر شده در ۱ سپتامبر ۲۰۲۶ توسط پژوهشگری به نام mvakde، این مدل روی یک تکپردازنده RTX 5090 آموزش دیده است. این نتیجه نشان میدهد که کارایی نمونه (Sample Efficiency) — یعنی توانایی یادگیری از تعداد بسیار کمی مثال — در چارچوب فعلی ترنسفورمر (Transformer) — ساختاری شبیه به یک سیستم مدیریت توجه که تصمیم میگیرد کدام بخش از دادهها در هر لحظه مهمتر است — یک مسئلهی قابل حل است. این مدل همچنین در آزمون سختتر ARC-2 به امتیاز ۷٪ رسیده است.
برای سالها، محک ARC-AGI (پیکره استدلال و انتزاع) به عنوان «سنگ محک» هوش سیال شناخته شده است. برخلاف بنچمارکهای استاندارد، این آزمون از مدل میخواهد پازلهای کاملاً جدیدی را حل کند که هرگز در دادههای آموزش ندیده است و تنها چند جفت مثال برای راهنمایی در اختیار دارد. در حالی که مدلهای زبانی پیشرو (Frontier LLMs) در این جدول صعود کردهاند، منتقدان معتقدند این موفقیت نتیجهی پیشآموزشهای عظیم یا استفاده از دادههای مصنوعی است؛ اتفاقی که بیشتر شبیه به «بهینهسازی برای آزمون» (Benchmaxxing) است تا استدلال واقعی.
همانطور که در تحلیلهای قبلی ما دربارهی محدودیتهای مدلهای زبانی در استدلال منطقی اشاره کردیم، تکیه بر حجم داده لزوماً به معنای درک مفاهیم نیست. رویکرد جدید mvakde مسیر متفاوتی را میرود. بهجای استفاده از یک غول پیشآموز شده، مدل در زمان تست (Test-time) برای هر پازل بهطور مجزا و از صفر آموزش میبیند. این روش که آموزش در زمان تست (Test-time Training یا TTT) نام دارد، به مدل اجازه میدهد وزنهای خود را با منطق خاص هر پازل تطبیق دهد پیش از آنکه پاسخ نهایی را ارائه کند. این پروژه سومین مقاله از یک سری پژوهشهاست که پیش از این توجه محققانی چون Rohan Anil، Lucas Beyer و Jeremy Howard را جلب کرده بود و نتایج آن در شبکه اجتماعی X به شدت مورد توجه قرار گرفت.
چرا کارایی نمونه اولویت دارد؟
نویسنده استدلال میکند که کارایی نمونه مهمترین چالش فعلی هوش مصنوعی است. هدف این پژوهش دو مورد است: نخست، یافتن مرزهای یادگیری در ترنسفورمرها وقتی محدود به روشهای یادگیری عمیق مدرن هستند و دوم، کاهش هزینهها برای تسریع چرخه آزمایش و خطا برای پژوهشگران سراسر جهان.
محک ARC برای این هدف ایدهآل است چون تعداد نمونههای بسیار کمی (تنها ۱۰۰۰ پازل) در یک فضای ابعادی بالا دارد. در این بنچمارک، هر پازل قانون متفاوتی دارد، هرچند مفاهیم مشترکی بین آنها وجود دارد. از آنجایی که هر مفهومی که در مجموعه ارزیابی (Eval set) وجود دارد، در مجموعه آموزش (Train set) نیز حضور دارد، این مدل به پیشفرضهای (Priors) بسیار کمی نیاز دارد. نکته کلیدی این است که این محک برای رویکردهایی که از دادههای مصنوعی یا سوگیریهای انسانی دوری میکنند، هنوز اشباع نشده است.
نقشه فنی و معماری
این مدل یک ترنسفورمر کوچک است که جفتهای ورودی-خروجی شبکهای را به توالیهایی از توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی که مدل تکهتکه میخورد — تبدیل میکند. این توالیها بهصورت خودبازگشتی (Autoregressive) در زمان تست روی هر دو مجموعه آموزش و ارزیابی آموزش میبینند، در حالی که برچسبهای تست پنهان میمانند.
برای مدیریت ماهیت فضایی پازلها، تغییرات معماری زیر اعمال شده است:
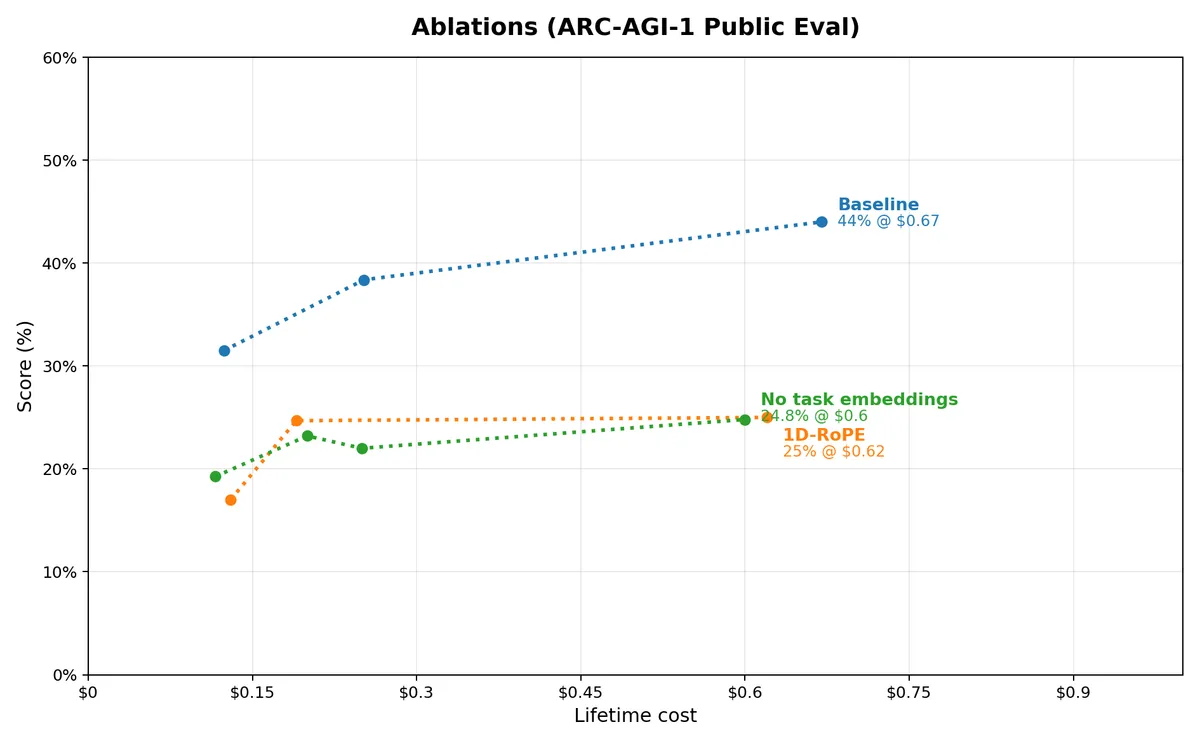
- بردار معنایی 3D RoPE: برای مدیریت دادههای موقعیتی دو شبکه دوبعدی. تغییر از 3D RoPE به 1D RoPE باعث میشود امتیاز مدل به حدود ۲۴٪ سقوط کند.
- بردار معنایی مخصوص هر تسک: هر پازل یک بردار یادگرفتهشده جمعی (Additive learned embedding) مجزا دریافت میکند تا یادگیری بین تسکها ممکن شود. حذف این بخش نیز امتیاز را به حدود ۲۴٪ میرساند.
- معماری مدرن: جایگزینی GELU با SwiGLU و LayerNorm با RMSNorm. تعداد لایهها از ۴ لایه در نسخه قبلی به ۸ لایه افزایش یافته است.
- بهینهساز NorMuon: تغییر از AdamW به NorMuon همگرایی مدل را بهشدت بهبود بخشید. نویسنده اشاره کرد که Muon معمولی باعث میشد مقدار زیان (Loss) در انتها در یک نقطه درجا بزند، اما NorMuon این مشکل پایداری را حل کرد.
- افزایش دادهها (Data Augmentation): توالیها با جایگشتهای رنگی و دووجهی (Dihedral permutations) تقویت شدهاند. در زمان استنتاج، ورودیهای تست تقویت شده و سپس معکوسِ این تقویت روی خروجیها اعمال میشود. در نهایت، دو خروجی رایجترین (AAIVR) ارسال میشوند.
جزئیات پیادهسازی و بهینهسازی
پژوهشگر برای رسیدن به این نتایج، تغییرات گستردهای در دینامیک آموزش و سرعت اجرا ایجاد کرد:
دینامیک آموزش و معماری
- بهینهساز: تغییر از AdamW خالص به NorMuon به همراه یک AdamW کمکی.
- زمانبندی نرخ یادگیری: تغییر از مدل Warmup+Cosine به مدل WSD (درصد گرمکردن، تثبیت، و سپس کاهش خطی تا رسیدن به کف).
- ساختار FFN: تبدیل لایههای Linear $ o$ GELU $ o$ Linear به یک FFN گیتدار به سبک SwiGLU (ترکیب chunk و SiLU gate).
- کاهش وزن (Weight Decay): پیادهسازی کاهش وزن گروهی صریح برای وزنهای توجه، بردارهای توکن و بردارهای تسک/دووجهی، بهجای اعمال آن فقط روی لایههای خطی غیر-توجه.
- هدف آموزش: تغییر از سبک بدون نظارت (زیان LM برای ورودی و خروجی) به سبک یادگیری نظارتشده (Supervised) که فقط زیان خروجی را محاسبه میکند.
- دستهبندی (Batching): تغییر از دستهبندی هوشمند بر اساس طول (Smart bucketing) به دستهبندی کاملاً تصادفی، با استفاده از
drop_last=Trueبرای حذف دستههای ناقص.
دادهها و تقویت
- گسترش مجموعه داده: افزودن تسکهای غیرهمپوشان از ARC-2. این کار با دقت انجام شد تا از نشت داده جلوگیری شود و ۷۷۳ پازل تکراری ARC-1 فیلتر شدند. بدون این دادههای اضافی، مدل همچنان امتیاز ۴۰٪ میگیرد اما به دو برابر محاسبات نیاز دارد.
- تقویت رنگ: تغییر از یک جایگشت سراسری در سطح هر اپوک به توپلهای تقویت بهازای هر مثال. دامنه رنگها اکنون رنگهایی که فقط در خروجی هستند را حذف میکند.
- تنوع: پیادهسازی هشینگ در هر تسک برای حذف ورودیهای تبدیلشده تکراری و استفاده از انتخاب چرخشی در هر اپوک برای کاندیداها.
- بردارهای دووجهی: افزودن یک بردار دووجهی جدید که به شرطگذاری توکنها جمع میشود و باعث بهبود جزئی عملکرد شد.
بهینهسازی سرعت
- جریانهای فشرده (Packed Streams): تغییر دستههای آموزش از حالت پد شده [B,S] به جریانهای توکن فشرده با
cu_seqlensبرای حذف توکنهای Padding. - هستههای توجه: جایگزینی ماسکگذاری SDPA پد شده با Flash-attention متغیر (varlen) و هستههای رمزگشایی Flex-attention برای استنتاج.
- تقویت آنلاین: انتقال تقویت دووجهی از گسترش آفلاین مجموعه داده به انتخاب آنلاین در زمان Collate.
تحلیل عملکرد و ابلاسیون
بررسیها نشان داد که حیاتیترین بخشها برای عملکرد، نمایشهای موقعیتی (Representations) هستند. حذف 3D RoPE یا بردارهای مخصوص هر تسک، باعث سقوط شدید امتیاز به ۲۵٪ شد. هر دوی این ابلاسیونها در سطح ۲۵٪ اشباع میشوند.
سایر نتایج ابلاسیون عبارتند از:
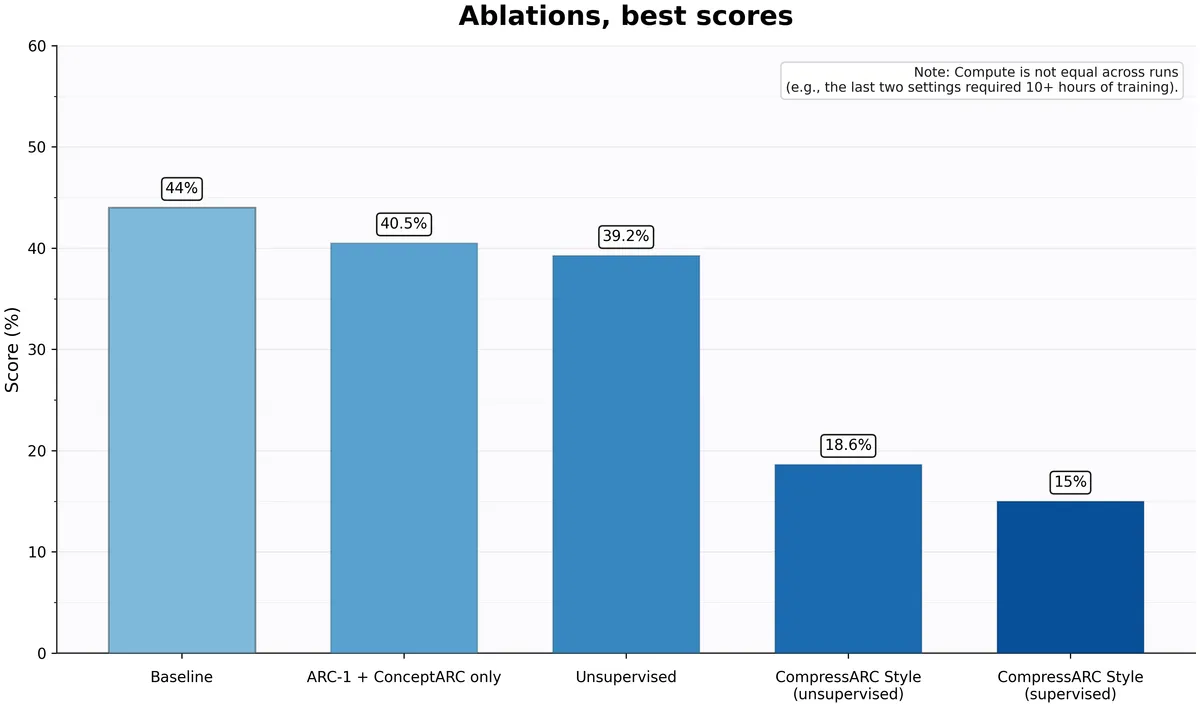
- نظارتشده در برابر بدون نظارت: آموزش روی ورودیها (سبک بدون نظارت) عملکرد ضعیفتری داشت و به حدود ۳۹٪ رسید.
- دامنه مجموعه داده: محدود کردن مجموعه آموزش به ARC-1 + ConceptARC عملکرد مشابهی داشت (حدود ۴۰٪).
- سبک CompressARC: آموزش از صفر روی هر تسک بهطور مجزا و بدون نظارت، عملکرد را به ۱۸٪ کاهش داد. انجام همین کار بهصورت نظارتشده، امتیاز را باز هم کمتر کرد و به ۱۵٪ رساند.
نکته جالب این است که مدل زمانی بهتر عمل کرد که پژوهشگر آموزش روی توکنهای ورودی را متوقف کرد و به یک تابع زیان کاملاً نظارتشده روی توکنهای خروجی روی آورد. این تغییر امتیاز را از ۴۰٪ به ۴۴٪ رساند، هرچند زیان (Loss) در مجموعه اعتبارسنجی بدتر به نظر میرسید. این یافته ثابت میکند که زیان اعتبارسنجی همیشه معیار دقیقی برای موفقیت در بنچمارک نیست و این رویکرد پایدارتر است و نوسان کمتری در امتیازات نشان میدهد.
کارایی و هزینه
کل هزینه محاسباتی در طول چرخه عمر — شامل آموزش از لحظه مقداردهی اولیه و استنتاج در تمام تسکها — بر اساس قیمتهای vast.ai برای یک کارت 5090 به مدت ۲ ساعت، تنها ۶۷ سنت بود. این نتیجه از طریق چندین بهینهسازی حاصل شد:
- کاهش تقویتها: استفاده از تعداد کمتری تقویت داده، از نظر نمونه کارآمدتر بود.
- شتابدهنده سختافزاری: بهرهگیری از Flash Attention با آموزش varlen و هستههای flex attention برای استنتاج.
- جریانهای توکن فشرده: تغییر دستههای آموزش از [B,S] پد شده به جریانهای توکن فشرده با cu_seqlens برای حذف توکنهای اضافی.
- زمانبندی WSD: تغییر نرخ یادگیری از Warmup+Cosine به مدل WSD (گرمکردن، تثبیت و کاهش خطی).
بحث درباره «تقلب» و استدلال
این پروژه بحثی را بین پژوهشگران به راه انداخت که آیا آموزش روی ورودیهای پازلهای ارزیابی، نوعی تقلب است یا خیر. نویسنده استدلال میکند که این در واقع استدلال تراداکتیو (Transductive Reasoning) است؛ تکنیکی مشروع در یادگیری متا که در آن مدل از بستر (Context) مجموعه تست یاد میگیرد بدون اینکه برچسبهای پنهان را ببیند.
برای شفافسازی اصطلاحات: ARC دارای پازلهای آموزش و پازلهای ارزیابی است. هر پازل شامل جفتهای مثال و جفتهای تست است. «برچسب» تنها شبکه خروجیِ جفت تست در یک پازل ارزیابی است. این برچسبها هرگز در آموزش استفاده نشدند. نویسنده معتقد است سیاست تست — که میگوید شرکتکننده نباید بداند تست چه خواهد بود — مربوط به طراح انسانی است، نه خود سیستم AI. این دیدگاه با نظر اعضای جامعهای چون Steven و Chew همسو است.
در پاسخ به سایر انتقادات:
- آموزش روی ورودیهای ارزیابی: نویسنده استدلال میکند که نادیده گرفتن ورودیهای ارزیابی در دنیایی که به دنبال حل یادگیری مستمر (Continual Learning) است، بیمعنی است.
- دسترسی به ورودی تست: او معتقد است همان استدلال تراداکتیو در مورد ورودی خاص تست نیز صدق میکند.
- آموزش دستهای: در حالی که برخی میگویند آموزش روی تمام تسکهای تست بهطور همزمان در مقایسه با حل تکتک مسائل توسط انسان غیرواقعبینانه است، نویسنده اشاره میکند که LLMها نیز روی کل اینترنت بهطور همزمان آموزش میبینند. علاوه بر این، برگزارکنندگان ARC تمام مدلها (از جمله TRM) را به همین روش مقایسه میکنند.
مدلهای زبانی بزرگ در برابر کارایی نمونه
نویسنده معتقد است مدلهایی مثل o1 شرکت OpenAI که به امتیاز ۷۵٪ رسیدهاند، این کار را از طریق پسآموزش (Post-training) روی حجم عظیمی از دادههای مصنوعی انجام دادهاند. وقتی ARC-2 منتشر شد (که شامل ۷۷۳ پازل ARC-1 و ۳۴۷ پازل جدید بود)، امتیاز بسیاری از LLMها ریست شد. این نشان میدهد آنها یاد گرفته بودند پازلهای خاصی را حل کنند، نه اینکه استدلال انتزاعی عمومی را توسعه دهند.
مشاهدات درباره پیشرفت LLMها عبارتند از:
- محدودیتهای پیشآموزش: عملکرد ضعیف اولیه نشان داد که پیشآموزش به تنهایی استدلال عمومی ایجاد نمیکند.
- وابستگی به پسآموزش: پیشرفت در ARC-2 مدیون پسآموزش و دادههای مصنوعی است، زیرا مدلهای پایه همچنان در اعداد تکرقمی گیر کردهاند.
- بنچمکسینگ: نویسنده پیشنهاد میکند آزمایشگاهها بهجای هوش عمومی، در حال بهینهسازی برای اعداد بنچمارک هستند.
نقد رویکردهای فعلی ARC
نویسنده چندین نقص در نحوه برخورد جامعه AI با ARC شناسایی کرده است:
- افسانه بازگشت (Recursion): مدلهایی مثل HRM و TRM موفقیت خود را به حلقههای بازگشتی و نظارت عمیق نسبت میدهند. نویسنده استدلال میکند ابلاسیونهای کافی برای اثبات این موضوع وجود ندارد، زیرا مدل او بدون بازگشت به عملکرد مشابه میرسد.
- اندازه گمراهکننده مدل: او TRM را نقد میکند که خود را یک مدل ۷ میلیون پارامتری معرفی میکند در حالی که O(100M+) وزن در بردارهای معنایی آموزش میدهد، که باعث میشود مدل بیشتر شبیه به یک «جدول جستوجو» (Lookup table) عمل کند.
- دادههای مصنوعی: او استدلال میکند دادههای مصنوعی سطح هوش سیال را پایین میآورند و پیشنهاد میکند پیشآموزش آفلاین ممنوع شود تا تست کارایی نمونه عادلانه باشد.
- مشکلات جدول ردهبندی: نمایش تمام مدلها در یک نمودار واحد گمراهکننده است زیرا هزینههای عظیم پیشآموزش آفلاین LLMها و در دسترس بودن پاسخهای ارزیابی عمومی در اینترنت را نادیده میگیرد.
این پروژه ثابت میکند که یک رویکرد خالص یادگیری عمیق، بدون دادههای مصنوعی یا سوگیریهای طراحیشده انسانی، همچنان بهشدت رقابتی است. نویسنده باور دارد رسیدن به امتیاز ۶۵٪ در چارچوب ترنسفورمر ممکن است. دلیل این باور این است که ترکیب تمام تسکهای حلشده از چندین اجرای مختلف، به امتیاز ۵۵٪ منجر شد.
مسیرهای آینده و دستاوردها
نویسنده معتقد است حوزه AI ممکن است قدرت خام یادگیری عمیق را وقتی با کارایی نمونه شدید ترکیب شود، دستکم بگیرد. برای رسیدن به ۶۵٪، او چندین مسیر را به جامعه متنباز پیشنهاد میکند:
- بردارهای موقعیتی: جایگزینی RoPE با PoPE برای جلوگیری از ترکیب اطلاعات موقعیتی و محتوایی.
- بهینهسازی GPU: کاهش هزینهها تا ۱۰ برابر دیگر از طریق کدنویسی دستی برای GPU.
- حذف تقویتها: یافتن راههایی برای حذف تقویت دادهها در حالی که هزینههای آموزش پایین بماند.
این تغییر دیدگاه، هدف را از «مدل چقدر میتواند بزرگ باشد» به «مدل برای استدلال به چه مقدار داده نیاز دارد» تغییر میدهد. توسعهدهندگان میتوانند به کد متنباز در گیتهاب دسترسی پیدا کنند تا بدون افزایش دادههای آموزش، تلاش کنند سد ۶۵٪ را بشکنند.
گام بعدی شما
- اگر پژوهشگر هستید، کد متنباز این پروژه را در گیتهاب بررسی کنید تا ببینید چگونه میتوان با کاهش دادهها، کارایی را بالا برد.
- در پیادهسازیهای خود، بهجای تکیه بر مدلهای پیشآموز شده، روش آموزش در زمان تست (TTT) را برای تسکهای تخصصی امتحان کنید.
- به جای استفاده از AdamW، بهینهسازهای جدیدتر مثل NorMuon را برای پایداری بیشتر در آموزشهای کوچک تست کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و بهینهسازیهای لایه سختافزار مراجعه کنید.



گفتگو