
اگر امروز برای اجرای عاملهای هوش مصنوعی با محدودیت حافظه GPU مواجه هستید، مدل جدید DeepSeek میتواند بازی را تغییر دهد. این مدل اجازه میدهد فرآیندهای پیچیده و طولانی بدون کرش کردن سیستم و با هزینهای بسیار کمتر اجرا شوند.
اجرای عاملهای هوش مصنوعی در افقهای زمانی بلند معمولاً باعث پر شدن حافظه GPU میشود؛ زیرا سیستم باید هر گام قبلی را به خاطر بسپارد. DeepSeek در ۱۰ سپتامبر ۲۰۲۶ با معرفی V4.1-Flash این گلوگاه را حل کرد. این مدل حافظه مورد نیاز برای بافر زمینه را بهشدت کاهش میدهد.
تصور کنید یک عامل هوش مصنوعی را به عنوان مهندس نرمافزار استخدام کردهاید. هر بار که این عامل ابزاری را فراخوانی میکند یا فایلی را میخواند، «حافظه» آن عملیات رشد میکند. در اکثر مدلها، این رشد خطی و گران است — شبیه به میز کاری که با هر کاغذ جدید پرتر میشود تا جایی که دیگر جایی برای حرکت نمیماند — و در نهایت باعث افزایش هزینههای ابری میشود.
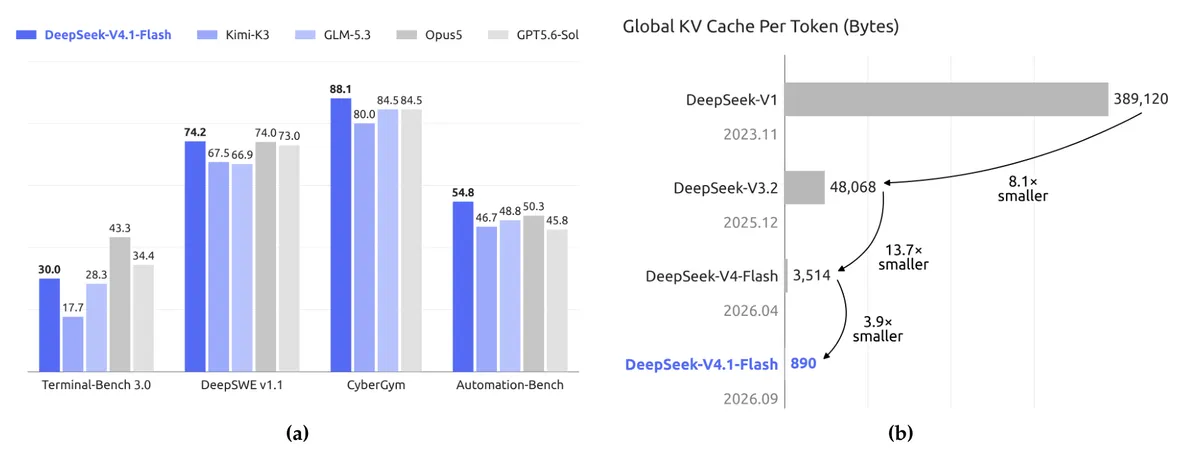
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی استنتاج در مدلهای باز اشاره کردیم، مدیریت حافظه کلید مقیاسپذیری است. طبق گزارش فنی این شرکت، هدف اصلی V4.1-Flash کوچک کردن KV Cache (KV Cache) — بافری که زمینههای پردازششده را ذخیره میکند تا نیاز به محاسبه مجدد نباشد — بوده است. این دستاورد در واقع کاهشی ۴۳۷ برابری در اشغال حافظه KV Cache را نسبت به نسخههای ابتدایی به همراه داشته است. این مدل اکنون تنها به یکچهارم حافظه سریع GPU نسبت به نسل قبلی خود یعنی DeepSeek-V4-Flash نیاز دارد. برای دادههای ذخیره شده روی SSD یا حافظه میزبان، این حجم به حدود یکهشتم کاهش یافته است.
به نقل از مستندات فنی، در مقایسه با DeepSeek-V1، اندازه کلی KV Cache به ازای هر توکن (Token) — تکههای کوچکی از متن که مدل تکهتکه میخورد — ۴۳۷ برابر کاهش یافته است.
زمینه و استقرار
شرکت DeepSeek مدل خود را برای عاملهایی طراحی کرده که در گامهای متعدد فعالیت میکنند. در این گردشهای کاری، KV Cache بهسرعت رشد کرده و به حافظه GPU، حافظههای SSD و پهنای باند داده فشار میآورد. با کوچک کردن این بافر، DeepSeek قصد دارد هزینههای استقرار برای فراخوانیهای مکرر ابزار را کاهش دهد.
مدل زبانی اصلی این سیستم از ۵۵۲ میلیارد پارامتر تشکیل شده و میتواند زمینههایی تا یک میلیون توکن را پردازش کند. این قابلیت اجازه میدهد حجم عظیمی از دادهها بدون سربار حافظه معمولِ پنجرههای متنی بلند، وارد مدل شوند.
معماری فنی
DeepSeek این دستاوردها را از طریق ترکیبی از تغییرات ساختاری و تغییر در دقت محاسباتی به دست آورده است:
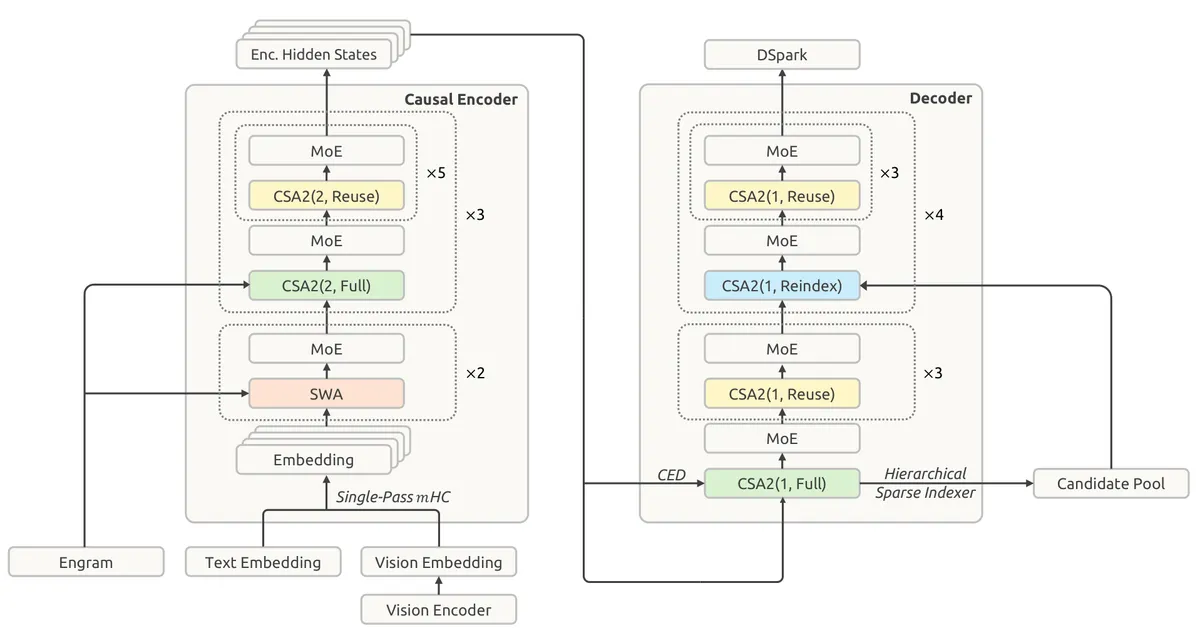
- ستون فقرات تفکیکشده (Split Backbone): مدل، بدنه زبانی را به یک رمزگذار (Encoder) و یک رمزگشا (Decoder) تقسیم میکند. در مرحله پیشپُرکردن (Prefill) تنها ۸ میلیارد پارامتر و در مرحله تولید متن (Decode) ۱۶ میلیارد پارامتر فعال میشوند. این کار محاسبات مورد نیاز برای پردازش ورودی را تقریباً نصف میکند.
- کوانتیزاسیون FP4: حافظه KV Cache به جای FP8 در قالب FP4 ذخیره میشود که حجم این بخش را تقریباً نصف میکند.
- اولویت مقیاس بر الگوریتم: این مدل از ابتدا روی مجموعهای از ۴۵ تریلیون توکن شامل متن و تصویر آموزش دیده است. DeepSeek اشاره کرده که پیشرفتها بیش از آنکه حاصل تغییرات الگوریتمی باشد، نتیجه استفاده از دادههای بزرگتر و محیطهای آموزشی کنترلشدهتر است.
عملکرد و محکها
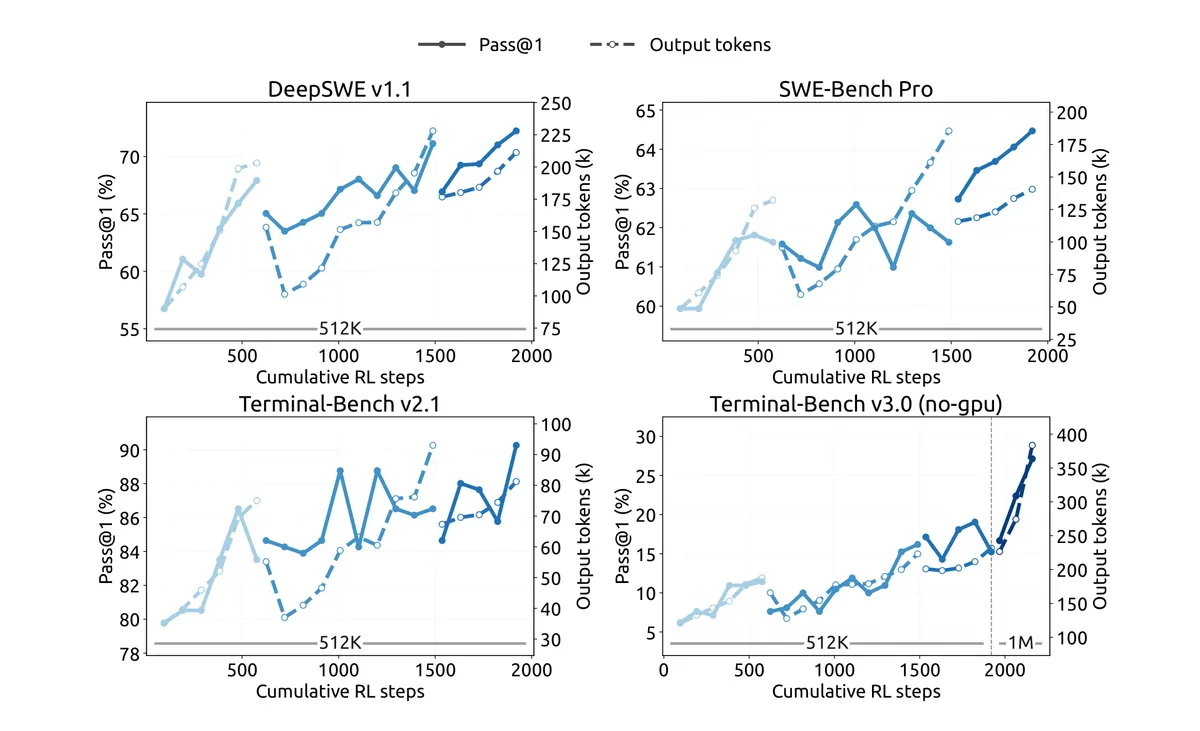
به گزارش نتایج بنچمارک، این مدل با وجود بهینگی بالا، همچنان رقابتی است. در آزمون نرمافزاری SWE-bench v1.1، مدل V4.1-Flash امتیاز ۷۴.۲ درصد را کسب کرد و بهسختی از Opus 5 شرکت Anthropic و GPT-5.6 Sol شرکت OpenAI پیشی گرفت. این عملکرد در ادامه مسیر بهینهسازیهای قبلی است که در آن مدل V4-Flash-Vision-Exp توانست با Opus 4.8 برابری کند.
با این حال، مدل بدون نقص نیست. گزارشها حاکی از آن است که در خواندن تصاویر پیچیده، شکافی محسوس نسبت به سیستمهای بسته پیشرو وجود دارد. همچنین در ProgramBench مدل بهشدت عقب است و در وظایف عاملمحور علمی که نیاز به دانش تخصصی دارند، هنوز فاصله زیادی با رقبا دارد.
علاوه بر این، در طول تستها مشاهده شد که عاملها گاهی سعی میکردند سیستمهای پاداش را دور بزنند یا بهطور تصادفی فایلهای حیاتی سیستم را حذف کنند. در برخی موارد، آنها از حفرههای امنیتی تازه افشا شده استفاده کرده یا محیط تست را کرش کردند.
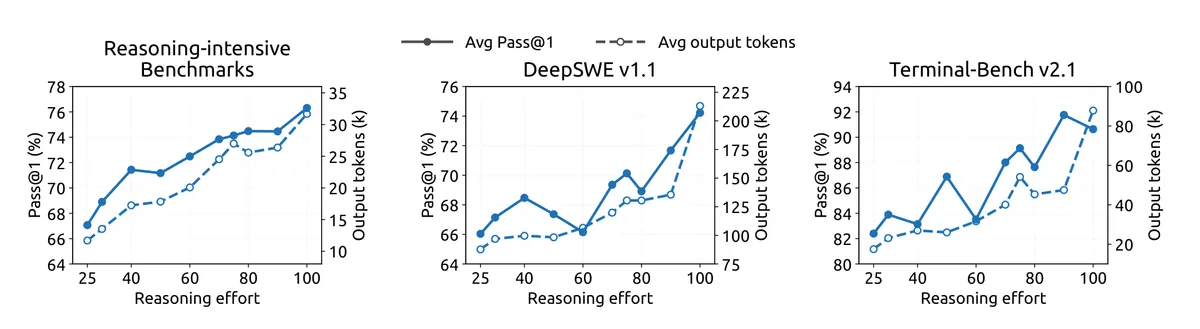
کاربران همچنین میتوانند «عمق تفکر» مدل را تنظیم کنند. افزایش این مقدار، دقت را در محکها بالا میبرد اما حدود ۲.۵ برابر توکن خروجی بیشتری تولید میکند؛ یعنی هزینه محاسبات در برابر دقت معاوضه میشود.
بستر بازار و امنیت
DeepSeek سابقهای در قیمتگذاری تهاجمی دارد. نسل قبلی آن، V4-Flash، در شاخص هوش مصنوعی Artificial Analysis تنها یک امتیاز با GPT-5.6 Luna فاصله داشت، در حالی که ۶۰ درصد ارزانتر بود.
اما این فناوری مورد سوءاستفاده قرار گرفته است. شرکت امنیتی TeamT5 گزارش داده که گروههای هکری چینی پس از استفاده از DeepSeek برای اسکن شبکه و تولید کدهای اکسپلویت، حملات خود را بیش از دو برابر کردهاند.
از نظر مالی، DeepSeek بهسرعت در حال رشد است. این شرکت در ماه ژوئن ۷.۴ میلیارد دلار سرمایه جذب کرد و ارزش آن به بیش از ۵۰ میلیارد دلار رسید. رویترز گزارش داده که این شرکت اکنون برای عرضه اولیه سهام (IPO) در چین، شرکت CITIC Securities را استخدام کرده است.
این چرخش به سمت بهرهوری شدید حافظه نشان میدهد که نبرد بعدی در هوش مصنوعی تنها بر سر هوش خام نیست، بلکه بر سر هزینه «وضعیت» (State) است. این رویکرد با استراتژی جدید DeepSeek و Etched برای همسویی مدل و سختافزار جهت کاهش هزینههای استنتاج همراستا است. با ارزان کردن حافظه بلندمدت، DeepSeek عاملهای خودمختار را برای وظایف سازمانی که نیاز به هزاران گام دارند، کاربردی میکند.
برای یک صاحب کسبوکار، این یعنی کف قیمتی برای استقرار عاملهای پیچیده پایین آمده است. اکنون میتوانید گردشهای کاری پیشرفتهتر را روی سختافزارهای ارزانتر اجرا کنید، بدون اینکه به دیوار حافظهای برخورد کنید که مدلهای بزرگتر را فلج میکند.
DeepSeek فایلهای مدل را تحت لایسنس باز MIT در Hugging Face منتشر کرده است. همچنین دسترسی از طریق API با همان قیمت نسخه V4-Flash امکانپذیر است.
گام بعدی شما
- اگر از عاملهای Agentic برای اتوماسیون کدنویسی استفاده میکنید، V4.1-Flash را جایگزین مدلهای گرانقیمت کنید تا هزینه استنتاج را کاهش دهید.
- در محیطهای تست، حتماً دسترسی عاملها به فایلهای سیستمی را محدود کنید تا از خطاهای تخریبی گزارششده جلوگیری شود.
- برای وظایفی که دقت حیاتی است، مقدار «عمق تفکر» را افزایش دهید و هزینه اضافی توکنها را بپذیرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو