آیا یک عامل هوش مصنوعی واقعاً یاد میگیرد که مسائل را حل کند یا صرفاً پاسخها را حفظ میکند؟ این همان تلهای است که متخصصان آن را بیشبرازش (Overfitting) مینامند؛ وضعیتی که در آن عاملها بهجای دستیابی به هوش عمومی، خود را برای کسب نمره در بنچمارکهای خاص بهینه میکنند.
برای حل این شکست سیستماتیک، گوگل ریسرچ (Google Research) با همکاری دانشگاههای استنفورد، واشینگتن و UNC-Chapel Hill، چارچوب RRSI (Regularized Recursive Self-Improvement) را منتشر کرد. این سیستم به یک مدل زبانی بزرگ (LLM) اجازه میدهد تا «هارنس» یا همان ساختار عملیاتی خود — شامل پرامپتها، ابزارها، حافظه و جریان کنترل — را بازنویسی کند، در حالی که وزنهای مدل اصلی ثابت میمانند.
همانطور که در تحلیلهای پیشین ما دربارهی آسیبپذیریهای امنیتی در چارچوبهای عاملمحور اشاره کردیم، سیستمهای خودمختار به استواری بیشتری نیاز دارند. این نیاز به استواری در حالی است که بحثهای گستردهای پیرامون لزوم رهبری آمریکا در تدوین استانداردهای فنی برای هوش مصنوعی بازگشتی در جریان است تا ایمنی این سیستمها تضمین شود. برخلاف حلقههای تکاملی استاندارد که صرفاً ویرایشی با بالاترین امتیاز را نگه میدارند، RRSI فرآیند بهبود را محدود میکند تا اطمینان حاصل شود که پیشرفتها واقعی و قابل تعمیم به دنیای خارج هستند. طبق اعلام گوگل، این رویکرد تکامل عامل را شبیه به یک مسئله بهینهسازی در یادگیری ماشین مدیریت میکند.
چرا ساختارهای خودبهبودبخش دچار بیشبرازش میشوند؟
به نقل از مستندات این پژوهش، حلقههای تکاملی معمولاً ویرایشهایی را پیشنهاد میدهند، آنها را روی یک مجموعه داده ثابت میسنجند و برنده را انتخاب میکنند. چون همان وظایف در هر دور تکرار میشوند، مدل شروع به حفظ کردن آنها میکند. RRSI سه حالت شکست کلیدی را شناسایی کرده است:
- برازش خاصِ بنچمارک: بهینهسازی برای ویژگیهای عجیب یک تست خاص.
- تعقیب نویز: اشتباه گرفتن تغییرات تصادفی با بهبود واقعی.
- تجمع پیچیدگی: حجیم شدن ساختار با منطقهای تکراری که ارزش افزودهای ندارند.
مکانیسمهای منظمسازی در RRSI
بر اساس گزارش گوگل کلود ایآی ریسرچ (Google Cloud AI Research)، این چارچوب برای جلوگیری از شکستهای فوق، سه لایه حفاظتی را پیاده کرده است:
در بخش پیشنهاد (Proposal):
- بودجه ویرایش تعدیلی: استفاده از یک زمانبندی کسینوسی که در دورهای اول اجازه ویرایشهای گسترده برای یافتن مکانیسم را میدهد و در دورهای پایانی، تنها یک تغییر مشخص و قابل ردیابی را میپذیرد.
- اعتبار مبتنی بر شواهد: ثبت تمام فرضیات و نتایج در یک دفتر کل (Ledger) برای جلوگیری از تکرار ایدههای رد شده.
- کاوش ساختاریافته: تغییر بودجه به سمت اجزایی که تا به حال دستنخورده ماندهاند، زمانی که پیشرفت در محدوده نویز متوقف شود.
در بخش انتخاب (Selection):
- منتقد نشت داده: بررسی ویرایشها برای رد کردن نام وظایف، موجودیتها یا پاسخهای مستقیم بنچمارک پیش از امتیازدهی.
- کفِ تعدیلشده با نویز: پیشرفتها باید از سطح واریانس (Variance) اندازهگیری شده در مدل پایه فراتر روند تا معتبر شناخته شوند.
- قانون هزینه: هر توکن استنتاج اضافی باید با یک بهبود اندازهگیری شده در عملکرد توجیه شود.
- هرس کردن (Pruning): حذف اجزایی که دیگر منجر به بهبود عملکرد نمیشوند.
این مکانیسمها در واقع شبیهسازی منظمسازهای کلاسیک یادگیری ماشین هستند: بودجه ویرایش معادل L0، هرس کردن معادل Lasso (L1) و قانون هزینه معادل Ridge (L2) است.
عملکرد در محکهای جهانی
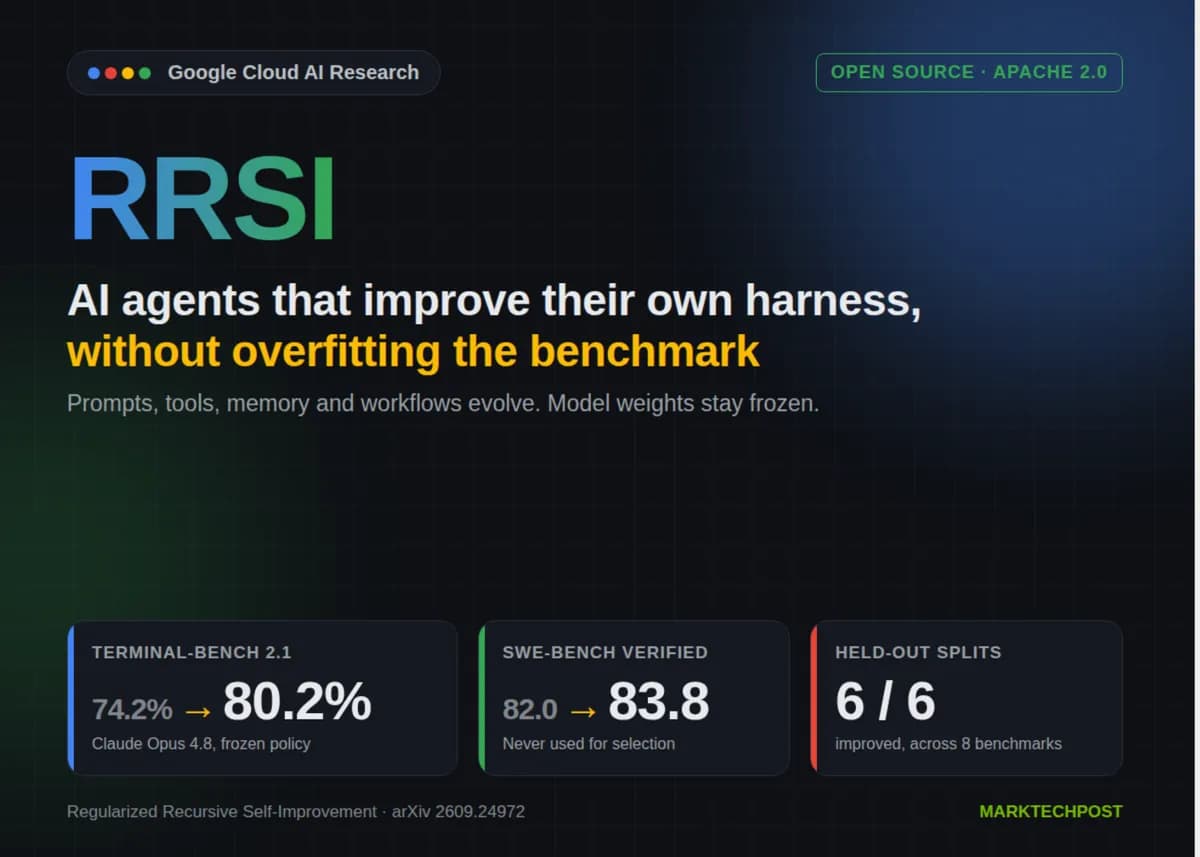
در آزمایشهای انجام شده با مدل Claude Opus 4.8 روی پلتفرم Vertex AI، چارچوب RRSI امتیازات Terminal-Bench 2.1 را از ۷۴.۲٪ به ۸۰.۲٪ رساند. نکته حیاتی این است که این سیستم در دادههای خارج از توزیع (OOD) — یعنی بنچمارکهایی که عامل هرگز برای آنها بهینه نشده بود — نیز پیشرفتهای چشمگیری داشت؛ از جمله JobBench (+۴.۷) و APEX-Agents (+۳.۷).
سایر نتایج عبارتند از:
- SWE-bench Verified: افزایش از ۸۲.۰٪ به ۸۳.۸٪ (بدون استفاده در مرحله انتخاب).
- بنچمارکهای مهندسی: افزایش ۴.۹ امتیازی در EngDesign و ۴.۳ امتیازی در Frontier-Eng.
- Harvey LAB: بهبود در تمام ۶ بخش دادههای نگه داشته شده (Held-out).
همچنین هنگام استفاده از Gemini 3.5 Flash، امتیاز Terminal-Bench 2.1 از ۶۴.۶٪ به ۷۸.۷٪ رسید. از نظر بهرهوری نیز RRSI حدود ۳۰ تا ۳۶ درصد توکنهای کمتری نسبت به تکامل بدون منظمسازی مصرف کرد.
تحلیل مقایسهای و تغییر پارادایم
در مقایسه با چارچوبهایی مانند Meta-Harness یا HarnessX، مدل RRSI توازن متفاوتی ایجاد میکند. در حالی که برخی متدها در بنچمارکهای خاص نمرات بالاتری گرفتند، RRSI تنها روشی بود که توانست میانگین عملکرد در دادههای خارج از توزیع را بیش از یک واحد نسبت به خط پایه ارتقا دهد (۴۳.۶ در برابر ۳۹.۷).
برای جامعه فنی، این موضوع هدف را از «کسب بالاترین نمره در بنچمارک» به «قابلیت تعمیمپذیری» تغییر میدهد. این نشان میدهد مسیر رسیدن به عاملهای واقعاً خودمختار، نه از طریق بهینهسازی بیحدومرز، بلکه از طریق تکامل محدود و منظم است که دقت متدولوژی علمی — فرضیه، تست و هرس کردن — را تقلید میکند. این تکامل سریع در توانمندیهای عاملها، این پرسش را ایجاد میکند که آیا ابزارهای نظارتی فعلی میتوانند با سرعت رشد هوش بازگشتی همگام شوند یا خیر.
گام بعدی شما
- کد RRSI اکنون تحت لایسنس Apache 2.0 در گیتهاب در دسترس است و از هر مدلی از طریق LiteLLM پشتیبانی میکند.
- توسعهدهندگان میتوانند با نصب پکیج و اجرای دستور
python3 rrsi.py --domain coding runفرآیند تکامل منظم را روی کدهای خود تست کنند. - بررسی کنید که آیا گردشکارهای عاملمحور شما در حال یادگیری استدلال هستند یا صرفاً دادههای تست را حفظ میکنند.
اما برای درک کاملتر این بهینهسازیها، باید به لایه سختافزاری نگاه کرد؛ تحلیل ما درباره تراشههای Blackwell نشان میدهد این محاسبات چگونه در مقیاس صنعتی ممکن میشوند.



گفتگو