اگر میخواهید یک سیستم هوش مصنوعی داشته باشید که هیچ دادهای را به ابر ارسال نکند و تماماً تحت کنترل شما باشد، سختافزار مصرفی امروز دیگر یک مانع نیست. یک توسعهدهنده ثابت کرد که با یک Mac Mini M4 Pro میتوان تمام زیرساختهای پیچیدهٔ عاملمحور را از سرورهای ابری به میز کار منتقل کرد. این دستگاه اکنون به عنوان سیستم عصبی مرکزی برای یک «هوملب» (Homelab) کاملاً خصوصی و محلی عمل میکند که برای آزمایشهای عاملمحور (Agentic) طراحی شده است.
تا ۲۴ ژوئن ۲۰۲۶، این پروژه نشان داد که استنتاج (Inference) — یعنی لحظهای که مدل واقعاً جواب تولید میکند، شبیه به خودِ آشپزی در مقابل دورهی آموزش آشپز — و سازماندهی عاملها میتواند بهطور کامل روی یک دستگاه کوچک و کممصرف اجرا شود. سختافزار M4 Pro بهطور مشخص بهدلیل تعادل میان قدرت پردازشی بالا و بهرهوری انرژی انتخاب شده است. علاوه بر این، اندازه بسیار کوچک این دستگاه اجازه میدهد تا بهطور همزمان بهعنوان یک مرکز رسانهای (Media Center) در زیر تلویزیون قرار گیرد و عمل کند.
پذیرش مدلهای زبانی محلی اکنون از چتهای ساده به سمت گردشهای کاری عاملمحور (Agentic) حرکت کرده است؛ یعنی مدلهایی که میتوانند از ابزارهای خارجی برای انجام تکالیف استفاده کنند. این رویکرد یادآور دستاوردهای اخیر در حوزه استقلال از ابر است، همانطور که تیم OpenClaw نیز توانست با مدلهای محلی و عاملهای هوشمند، تحلیل مخازن گیتهاب را بدون نیاز به ابرهای پردازشی بهینهسازی کند. در حالی که اکثر کاربران همچنان به APIهای ابری متکی هستند، فشار برای دستیابی به «حاکمیت محاسباتی» (Compute Sovereignty)، سختافزارهای محلی را به جایگزینی جذاب برای کسانی تبدیل کرده است که کنترل مطلق بر دادهها و نسخههای مدلهای خود را میخواهند. این پروژه حاصل یک سال تجربه در استقرار و ارزیابی مدلهای زبانی روی سختافزارهای مختلف است که منجر به غوطهوری عمیق در ابزارهای متنباز و گزینههای متنوع مدلها شد.

زیرساخت و شبکه
طبق مستندات این پروژه، معماری شبکه بهصورت ترکیبی (Hybrid) طراحی شده است. ساختار به این صورت است که یک سرور مجازی (VPS) ابری از Traefik بهعنوان پروکسی معکوس استفاده میکند تا درخواستها را از طریق تونلهای Tailscale به Mac Mini هدایت کند. در مقصد، یعنی روی دستگاه مک، Nginx مسئولیت مسیردهی سرویسهای محلی را بر عهده دارد. برای تأمین امنیت دسترسی از راه دور، سیستم احراز هویت توسط Authelia روی VPS مدیریت میشود که از مکانیزم auth_request برای اطمینان از دسترسی امن استفاده میکند.
سختافزار و استقرار
تمام فایلهای پیکربندی (Configuration) مربوط به این چیدمان در یک مخزن (Repo) اختصاصی برای هوملب نگهداری میشوند. بر اساس گزارش توسعهدهنده، این پروژه طی چندین تکرار تکامل یافت و در ابتدا با یک ترکیب ساده از Ollama و OpenWebUI شروع شد. اما با گذشت زمان و افزایش نیاز به کنترلهای دقیقتر و جزئیتر (Granular Control)، این ابزارها جایگزین شدند.

نویسنده بهجای استفاده از Ollama، از ابزاری به نام llamactl استفاده میکند. او Ollama را بهدلیل نبود شفافیت، لایسنسهای محدودکننده و عدم قدردانی درست از زیربنای خود یعنی llama.cpp مورد انتقاد قرار داد. ابزار سفارشی llamactl اکنون مدیریت نمونههای متعدد مدلها را با استفاده از llama-server و MLX بر عهده دارد.
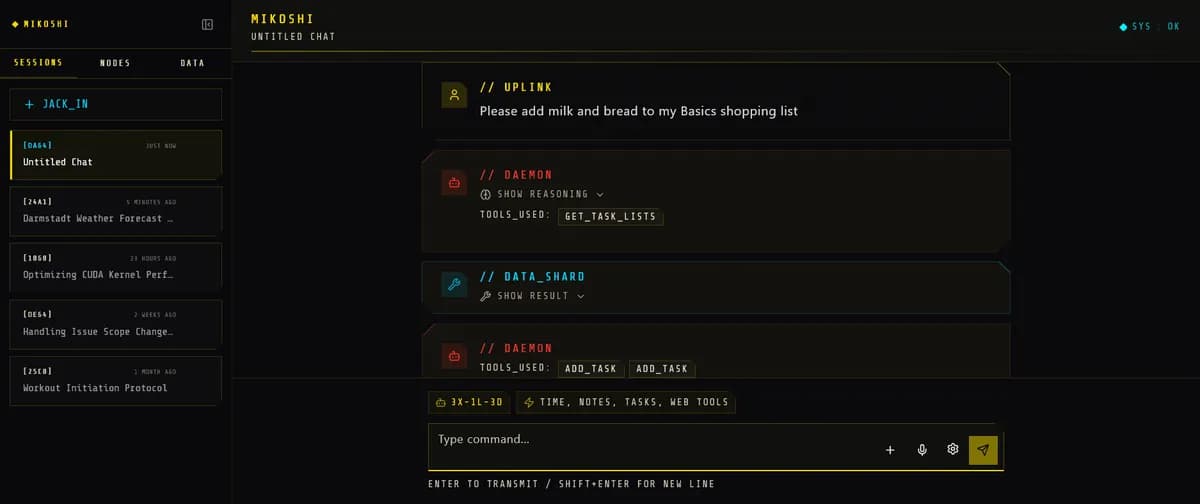
در بخش رابط کاربری نیز تغییرات گستردهای رخ داد. توسعهدهنده دریافت که OpenWebUI بیش از حد «سختگیر» (Opinionated) و کدر است؛ برای مثال، این رابط کاربر را مجبور میکرد از پروکسی MCP اختصاصی خودش (به نام MCPo) استفاده کند، بهجای آنکه مستقیماً از سرورهای پروتکل زمینه مدل (MCP) پشتیبانی کند. علاوه بر این، تفکیک تنظیمات برای مدیران و کاربران در یک محیط تککاربره، گیجکننده بود. برای حل این مشکل، نویسنده فریمورک عامل سفارشی خود را به نام Mikoshi (که در ابتدا AgentKit نام داشت) توسعه داد.
اجزای فنی هسته
- پروتکل زمینه مدل (MCP): این استاندارد باز که از طریق SDK رسمی پایتون پیادهسازی شده، به مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — اجازه میدهد دادهها را با ابزارهای خارجی یکپارچه و به اشتراک بگذارد. برای جلوگیری از بار پردازشی سنگینِ مقداردهی اولیه (Initialization) یک کلاینت و نشست MCP برای هر پیام، نویسنده جریان را بهینه کرد: او یک نشست جهانی (Global Session) برای هر سرور MCP باز نگه میدارد و آن را در پیامهای متعدد بازاستفاده میکند.
- تکامل عامل: مسیر رسیدن به Mikoshi با فریمورک smolagents آغاز شد. نویسنده در ابتدا یک
ToolCallingAgentساخت که در یک حلقه چت قرار داشت. اما هنگام گسترش منطق فراخوانی ابزارها، متوجه شد که در واقع دارد smolagents را از ابتدا بازسازی میکند. زمانی که یکپارچگی با MCP باعث ایجاد تداخل با مدیریت smolagents شد، تمام وابستگیها را حذف کرد تا فریمورک سفارشی خود را به پایان برساند. - پشته صوتی: یک اپلیکیشن FastAPI با استفاده از کتابخانه mlx-audio، نقاط اتصال (Endpoints) سازگار با OpenAI را برای تبدیل گفتار به متن (Whisper ASR) و سنتز متن به گفتار فراهم میکند. برای بهینهسازی و حفظ حافظه (RAM)، این اپلیکیشن مدلها را فقط هنگام نیاز بارگذاری کرده و پس از یک زمان مشخص (Timeout) آنها را تخلیه میکند؛ منطقی که دقیقاً مشابه عملکرد llamactl است.
- مانیتورینگ: ابزار Glances یک رابط وب سبک را برای رصد لحظهای میزان استفاده از CPU، حافظه، دیسک و پهنای باند شبکه فراهم میکند.

ابزارهای یکپارچه شده
برای کاربردی کردن این هوش مصنوعی و تبدیل آن به یک دستیار واقعی، ابزارهای زیر در Mikoshi ادغام شدهاند:
- ابزار وظایف (Task Tool): استفاده از پروتکل CalDAV برای مدیریت تکالیف و لیستهای Todo.
- ابزار یادداشتها (Notes Tool): مدیریت یادداشتهای مارکداون (Markdown) از طریق یک MCP مربوط به Gitea و یک مخزن گیت.
- ابزار Anki: ایجاد مستقیم فلشکارتها در نرمافزار Anki برای یادگیری با تکرار فاصلهدار (Spaced Repetition).
- ابزار دیکشنری: انجام جستوجوهای استاندارد برای یافتن تعاریف کلمات.
چالشهای پیادهسازی در macOS
انتقال از پسزمینه لینوکسی به macOS، نقاط اصکاک قابل توجهی را آشکار کرد. اگرچه Homebrew برای مدیریت پکیجها بسیار مؤثر است، اما جامعیت apt یا pacman را ندارد.
مدیریت سرویسها از طریق Launchd در مقایسه با systemd بسیار محدود است. بهطور خاص، هیچ راه آسانی برای تعریف وابستگیها (Dependencies) بین سرویسها یا مدیریت محدودیتهای منابع وجود ندارد و فرآیند شروع یا توقف سرویسها دشوارتر است. مهمترین نکته فنی این است که چون داکر (Docker) در مک باید درون یک ماشین مجازی (VM) لینوکس اجرا شود، نویسنده نمیتواند از شتابدهنده گرافیکی (GPU) برای بارهای کاری کانتینری استفاده کند. این محدودیت در مدیریت محیطهای ایزوله در مک، موضوعی است که در بررسیهای مربوط به همگامسازی بومی دایرکتوری Home در کانتینرهای اپل مورد بحث قرار گرفته تا موانع Docker در macOS کاهش یابد.
این چرخش به سمت فریمورکهای سفارشی مانند Mikoshi، نشاندهنده نارضایتی روزافزون متخصصان از «پوششهای» (Wrappers) آماده و سختگیر هوش مصنوعی است. برای یک متخصص، مزیت اصلی این روش، حذف لایههای انتزاع است؛ یعنی شما دیگر برای پیادهسازی یک پروتکل جدید یا یک منطق حافظه خاص، با یک رابط کاربری (UI) نمیجنگید.
نقشه راه آینده
مراحل بعدی توسعه شامل اصلاح پلاگینهای Mikoshi و گسترش سیستم مانیتورینگ برای شامل کردن ردیابی (Tracing)، مدیریت پرامپتها (Prompt Management) و قابلیتهای پیشرفته حافظه است. همچنین یک پروژه یکپارچهسازی فعال با Reachy Mini (یک ربات کوچک متنباز) در جریان است که قرار است بهعنوان پلتفرم هدف برای یک دستیار صوتی محلی عمل کند.
با مالکیت کامل پشته (Full Stack) — از سیلیکون M4 Pro گرفته تا حلقه اجرای عامل — توسعهدهندگان میتوانند بدون تحمل هزینههای ابری یا ریسکهای حریم خصوصی، ایدههای خود را تکرار و اصلاح کنند. سازندگانی که علاقهمند به این مسیر هستند، میتوانند مستندات رسمی Model Context Protocol، جامعه r/LocalLlama یا راهنماهای huggingface برای smolagents را برای شروع سفر محلی خود بررسی کنند.
اما داستان سختافزاری این تحول با ورود تراشههای جدیدتر حتی پیچیدهتر میشود — در تحلیلهای بعدی، اثر بهینهسازیهای سطح سیلیکون بر سرعت استنتاج را بررسی خواهیم کرد.



گفتگو