
اگر در حال استقرار مدلهای هوش مصنوعی روی سختافزارهای محدود هستید، احتمالاً با توهمات مدلهای کوچک دستوپنجه نرم میکنید. باید بدانید که دیگر لازم نیست بین «سرعت مدلهای کوچک» و «هوش مدلهای بزرگ» یکی را انتخاب کنید؛ راهکار جدید، مدیریت هوشمندانه ترافیک بین این دو است.
بسیاری از پروژههای بینایی ماشین در لبه با «توهمات مطمئن» روبرو میشوند؛ یعنی مدل کوچک با اطمینان ۱۰۰٪ پاسخ غلط میدهد. هوش مصنوعی زاینده (Generative AI) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — در ابعاد کوچکتر مستعد این خطاهاست. همانطور که در تحلیلهای پیشین ما دربارهی مدلهای زبانی کوچک (SLM) اشاره کردیم، چالش اصلی همواره تعادل بین دقت و مصرف حافظه بوده است.
طبق گزارش ۱۳ ماه مه ۲۰۲۶ در وبسایت dev.to، معماری جدیدی معرفی شده که در آن یک مدل «استاد» (Teacher) و یک مدل «شاگرد» (Student) همکاری میکنند. در این ساختار، مدل Gemma 4 E2B روی دستگاه لبه و مدل بزرگتر Gemma 4 26B روی یک Mac Mini مستقر شده است. این فرآیند چهار مرحله دارد:
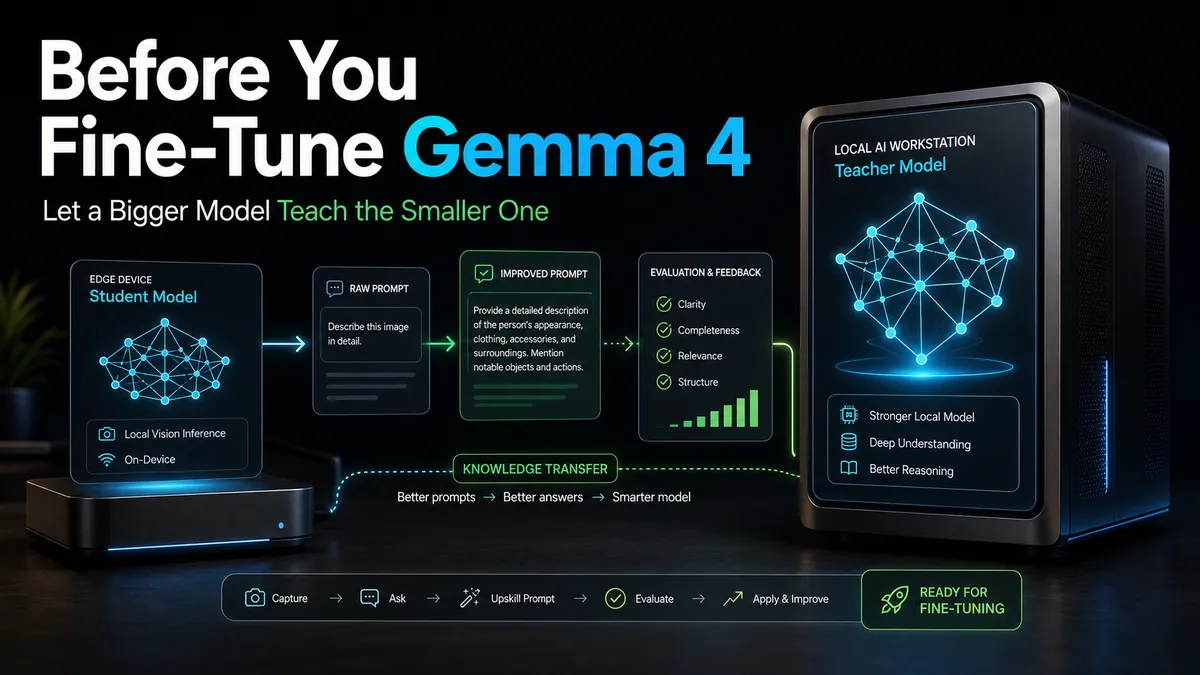
- تعریف نقش بسیار دقیق برای مدل شاگرد تا ابهام در تصمیمگیری کاهش یابد.
- استفاده از مدل استاد برای تولید چندین نمونه از پرامپتهای سیستمی.
- امتیازدهی به این پرامپتها بر اساس یک مجموعه ارزیابی کوچک تا برنده بر اساس داده انتخاب شود، نه حس کاربر.
- اجرای سیاست ارجاع؛ یعنی اگر مدل شاگرد اعتمادبهنفس پایینی داشت یا کلمات حساس شناسایی شدند، درخواست به مدل استاد ارجاع یابد.
این رویکرد هدف توسعهدهنده را از «آموزش یک مدل بهتر» به «طراحی یک سیاست ارجاع بهتر» تغییر میدهد. برای کسانی که ابزارهای نظارتی یا خردهفروشی میسازند، این یعنی رسیدن به پایداری سطح صنعتی بدون نیاز به تنظیم دقیق (Fine-tuning) — که شبیه وقتی است به یک پزشک عمومی، تخصص پوست میدهیم تا در یک حوزه دقیق شود.
گام بعدی شما
- پیادهسازی حلقه امتیازدهی (Scoring Loop) را در گیتهاب بررسی کنید.
- معیارهای ارجاع (Escalation Policy) را بر اساس کلمات کلیدی حساس تعریف کنید.
- مدلهای کوچکتر را با پرامپتهای تولیدشده توسط مدلهای ۲۶ میلیارد پارامتری تست کنید.
اما تأثیر این رویکرد بر مصرف باتری دستگاههای لبه هنوز ناشناخته است — به تحلیل ما دربارهی بهینهسازی سختافزاری مراجعه کنید.



گفتگو