تصور کنید هر لحظه که برای یک استراحت کوتاه از میز کارتان فاصله میگیرید، ترس از دست دادن یک فرصت شغلی یا جایزه نقدی گرانبها شما را رها نکند. یک برنامهنویس در ویتنام برای شکستن این زنجیر دیجیتال، از هوش مصنوعی زاینده (Generative AI) استفاده کرد تا فرآیند خستهکننده بررسی لیستهای جایزه (Bounty) و هکاتونها را به یک عامل هوشمند بسپارد.
این توسعهدهنده سامانه Đi đây (به معنای «من رفتم») را طراحی کرده است تا نقش یک دستیار را ایفا کند که در غیاب کاربر، تمام فرصتهای جدید را بررسی میکند. نکتهی عجیب اینجاست که این سیستم برای اجبار کاربر به استراحت، نتایج را قفل میکند و تنها زمانی آنها را نمایش میدهد که کاربر ثابت کند واقعاً از خانه خارج شده است.
به گزارش منتشر شده در ۸ اکتبر ۲۰۲۴، این سیستم به عنوان یک عامل (Agent) — شبیه به کارمندی که دستورات پیچیده را میفهمد و بهتنهایی اجرا میکند — روی سختافزار شخصی کاربر اجرا میشود. این ابزار صرفاً دادهها را جمعآوری نمیکند، بلکه جزئیات ریز قراردادها را میخواند تا موارد رد صلاحیت را پیدا کند؛ مواردی که معمولاً تنها پس از شروع ثبتنام متوجه آنها میشویم.
همانطور که در تحلیلهای پیشین ما دربارهی مدلهای لبه (Edge AI) اشاره کردیم، اجرای مدلها روی سختافزار محلی، حریم خصوصی را به شدت افزایش میدهد. در اینجا نیز توسعهدهنده برای حفظ حاکمیت دادهها، از یک مدل با وزنهای باز (Open Weights) — یعنی مدلی که دستور پخت و ساختارش علناً منتشر شده — استفاده کرده است. این رویکرد یادآور استفاده از مدلهای محلی Gemma برای حل چالشهای برنامهریزی در محیطهای خاص است که نشان میدهد چگونه مدلهای کوچک میتوانند در کاربردهای تخصصی موثر باشند.
معماری فنی سامانه
این سیستم یک اپلیکیشن سبک با Node.js است که تنها با ۶۰۰ خط کد و بدون وابستگی به کتابخانههای خارجی ساخته شده است. ساختار آن به چهار بخش تقسیم میشود:
server.mjs: مدیریت منطق سفر و قفل نتایج.brain.mjs: مدیریت ارتباط با مدل Gemma 4.sources/: مسئولیت استخراج لیستهای جایزه.public/out.html: رابط کاربری برای گوشی موبایل.
برای اجرای این سامانه از ترکیب سختافزاری و نرمافزاری خاصی استفاده شده است:
- مدل: نسخه Q4_0 GGUF از Gemma 4 E4B.
- موتور استنتاج: استفاده از استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه به خودِ آشپزی و نه دورهی آموزش آشپز — از طریق llama-server در محیط Docker.
- سختافزار: یک کارت گرافیک قدیمی NVIDIA Quadro P1000 با ۴ گیگابایت حافظه ویدیویی (VRAM).
به دلیل محدودیت حافظه، تنها ۸ لایه از مدل روی GPU اجرا میشود و باقی لایهها توسط CPU پردازش میشوند. این موضوع سرعت مدل را کاهش میدهد، اما برای این کاربرد خاص، تأخیر در پاسخگویی پذیرفتنی است.
مکانیزم تأیید خروج از خانه
برای اینکه کاربر نتواند بدون خروج از خانه نتایج را ببیند، سیستم از شواهد چندوجهی (Multimodal) — مدلی که مثل انسان همزمان متن، عکس و صدا را میفهمد — استفاده میکند. کاربر باید از طریق گوشی خود دو مورد را ارسال کند:
۱. شاهد صوتی: یک فایل WAV ۱۰ ثانیهای از صدای محیط بیرون.
۲. شاهد تصویری: یک عکس JPEG از فضای باز.
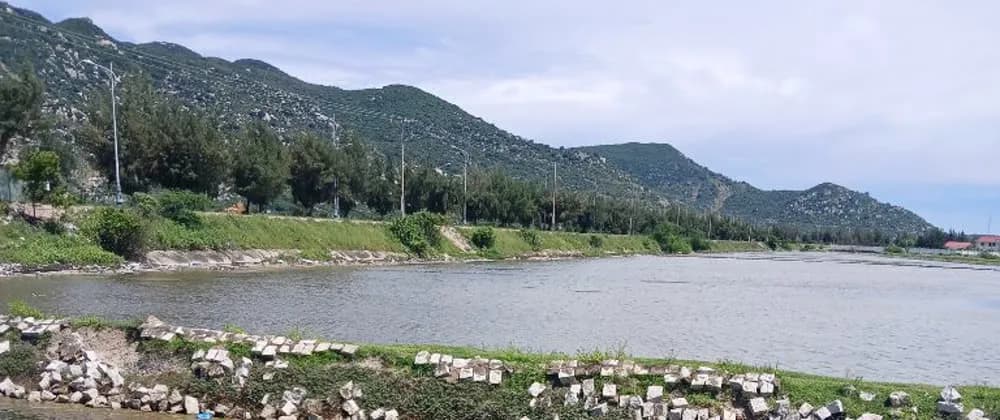
مدل Gemma 4 این ورودیها را تحلیل میکند تا بفهمد آیا کاربر واقعاً «به طبیعت پیوسته است» یا خیر. در آزمونی در ۸ اکتبر، مدل توانست صدای عبور ماشین و باد را تشخیص دهد و تصویری از یک رودخانه و کوهستان را تأیید کند و در نهایت لیست فرصتها را باز کند. این نوع اعتبارسنجی محیطی، شباهت زیادی به سیستمهای راهنمای میدانی آفلاین دارد که با ترکیب Gemma و اعتبارسنجی دادهها برای کاربردهای خارج از محیط دفتر طراحی شدهاند.
عملکرد و دقت در غربالگری
وظیفه اصلی هوش مصنوعی، یافتن «تلهها» در متنهای ریز است. مدل بهطور خاص به دنبال مواردی مثل نیاز به مصاحبه زنده، حضور فیزیکی، نیاز به کارت بانکی خاص یا محدودیتهای جغرافیایی (مثلاً مجاز بودن ویتنام) میگردد.
در اولین تست، سیستم ۲۰ مورد از Superteam Earn را در ۱۰.۵ دقیقه بررسی کرد. هر مورد بین ۲۳ تا ۴۵ ثانیه زمان برد و نتایج به سه دسته «ارزش انجام دادن»، «شاید» و «خیر» تقسیم شدند.
شناسایی موارد رد صلاحیت
ارزش واقعی مدل در لیست «خیر»ها مشخص شد؛ جایی که مواردی را یافت که در نگاه اول دیده نمیشدند:
- محدودیت مکان: دو هکاتون که حضور فیزیکی در کراکوف و ورشو را میطلبیدند.
- محدودیت منطقهای: یک مسیر که فقط برای تیمهای پاکستانی و دیگری منحصراً برای اوکراینیها بود.
- محدودیت فرمت: یک روز نمایش (Demo Day) که ارائه زنده محصول را اجباری کرده بود.
اصلاح خطاها و بهینهسازی منطق
سیستم در ابتدا بینقص نبود. مدل در برخی موارد دچار توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که وجود ندارد، شبیه دوستی که خاطرهای را اشتباه تعریف میکند — شد و برای مواردی که فقط ویدیو میخواستند، شرط «مصاحبه زنده» را تصور کرد.
برای رفع این مشکل، توسعهدهنده یک قانون سختگیرانه وضع کرد: یک مورد تنها زمانی «رد» میشود که مدل بتواند نقلقولی مستقیم حاوی کلمات کلیدی (مثل live یا interview) ارائه دهد. سایر بهینهسازیها شامل موارد زیر بود:
- ترتیب ورودیها: ابتدا صدا و سپس عکس پردازش میشود تا تداخل در تحلیل رخ ندهد.
- مدیریت منطقه زمانی: برای جلوگیری از اشتباه در تبدیل ساعت PDT به ساعت ویتنام، مدل فقط متن زمان را کپی میکند و محاسبات ریاضی را به کد Node.js میسپارد.
- فرمت JSON: برای جلوگیری از مصرف توکنهای اضافی، از
json_objectبا مثالهای کوتاه استفاده شد. - پاکسازی HTML: حذف کامنتهای مخفی HTML برای جلوگیری از گیج شدن مدل.
تست عصرگاهی و حریم خصوصی
در تست دوم در همان روز (۸ اکتبر)، مدل صداهای مبهم و ساختمانها را زیر آسمان ابری تشخیص داد. در این مرحله، به دلیل طولانیتر بودن قوانین هکاتونهای Devpost، هر مورد تا ۲ دقیقه زمان برد و گلوگاه سیستم، سختافزار لپتاپ بود.
انتخاب یک مدل با وزنهای باز به دلیل نیاز به حاکمیت دادهها بود. ارسال روزانه صدای محیط و عکسهای شخصی به سرورهای ابری، ریسک حریم خصوصی بزرگی است. با اجرای محلی، کاربر هم از هزینههای API در امان است و هم دادههای حساس را از میز کارش خارج نمیکند.
این پروژه که با کمک Claude Code ساخته شده، نشاندهنده گذار به سمت عاملهای «نامرئی» است؛ ابزارهایی که در پسزمینه زندگی فیزیکی ما کار میکنند و هوش مصنوعی را از ابزاری که با آن «حرف میزنیم» به ابزاری تبدیل میکنند که وقتی «کار نمیکنیم»، برای ما کار میکند.
گام بعدی شما
- اگر از مدلهای محلی استفاده میکنید، برای کاهش توهمات، خروجی مدل را به نقلقولهای مستقیم از متن محدود کنید.
- برای اجرای مدلهای بزرگ روی GPUهای ضعیف، از روشهای کوانتش (Quantization) برای کاهش مصرف VRAM استفاده کنید.
- سعی کنید برای کارهای تکراری، زنجیرهای از تاییدات فیزیکی (مانند عکس یا مکان) بسازید تا تعادل میان کار و زندگی برقرار شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو