تصور کنید به جای خرید یک ماشین مسابقهای و تنظیم موتور آن، تصمیم بگیرید یک موتور را از صفر و با ورقههای فولاد خام بسازید. این دقیقاً همان مسیری است که gulding برای ساخت EmsyAI (V4) طی کرد تا بفهمد در لایههای زیرین مدلهایی مثل Llama 3 چه میگذرد.
در ۳ سپتامبر ۲۰۲۶، جزئیات این پروژه منتشر شد تا ثابت کند ساخت یک مدل بنیادی (Foundation Model) — شبیه ساختن زیربنای یک ساختمان عظیم که هر لرزش کوچکی در پی آن کل سازه را تهدید میکند — نبردی سخت علیه ناپایداریهای عددی است. طبق گزارش منتشر شده در dev.to، این توسعهدهنده برای اجتناب از کتابخانههای سطح بالا، تمام اجزا از توکنساز (Tokenizer) BPE تا حلقههای آموزش را بهصورت دستی در PyTorch پیادهسازی کرد. این رویکرد دستی در تضاد کامل با تلاشهای اخیر برای سادهسازی است؛ برای مثال، چارچوب Tensorless تلاش میکند تا بسیاری از این تنظیمات پیچیده در PyTorch را خودکار کند.
همانطور که در تحلیل قبلی ما دربارهی معیارهای ارزیابی مدلها اشاره کردیم، شکاف عمیقی میان کاهش تابع زیان در آموزش و توانایی واقعی مدل در حل مسائل پیچیده وجود دارد. برای یک برنامهنویس، این تجربه یعنی درک این نکته که صرفاً داشتن داده کافی، تضمینکنندهٔ هوشمندی مدل نیست.
بر اساس مستندات فنی، معماری این مدل شامل موارد زیر است:
- پارامترهای فعال: ۱۹۶.۷ میلیون (۱۸۰ میلیون در بلوکهای ترنسفورمر و حدود ۱۶ هزار در بردار معنایی (Embedding) واژگان) — بردار معنایی مثل کارت معرفی عددی برای هر واژه است که میگوید این کلمه همسایهی چه کلمات دیگری است.
- دادههای آموزشی: ۱.۹۶ میلیارد توکن (Token) — تکههای کوچکی از متن شبیه برشهای کیک که مدل تکهتکه میخورد — در ۱۵ هزار گام با دقت ترکیبی FP16.
- پیکربندی: پنجرهٔ زمینه ۴,۰۹۶، بُعد پنهان ۱,۰۲۴ و استفاده از GQA.
- بُعد FFN: ۲,۸۱۶ با استفاده از بلوکهای SwiGLU.
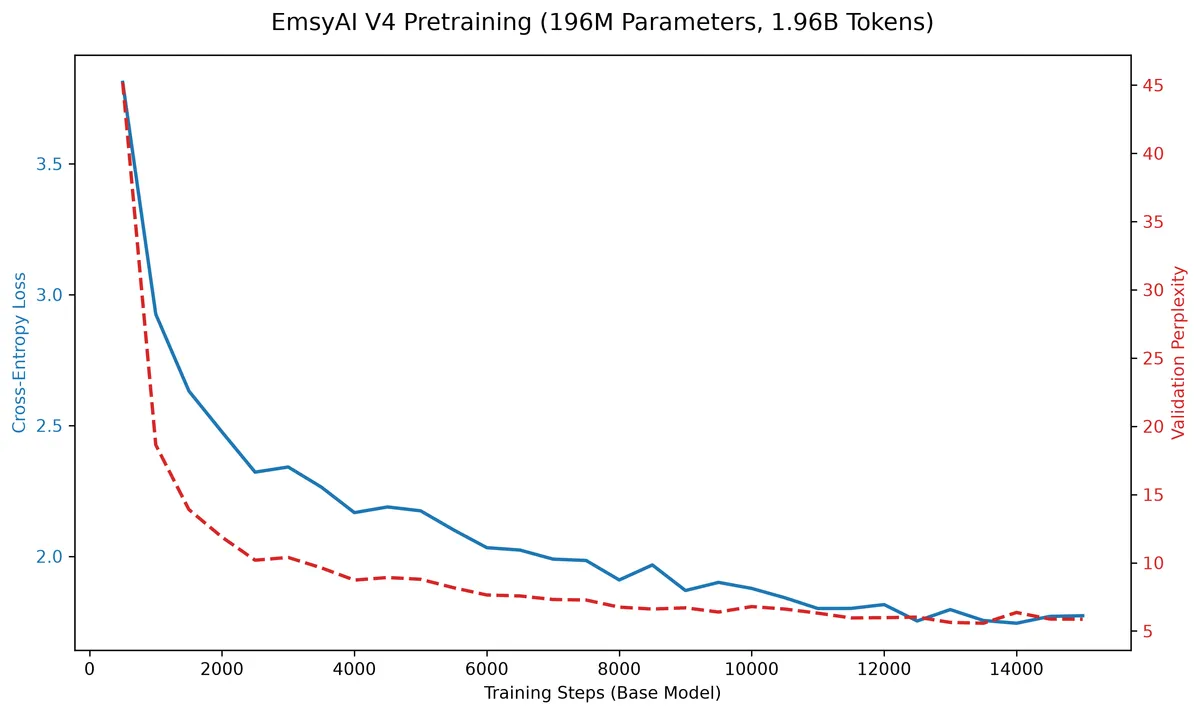
نویسنده پس از پیشآموزش، یک آداپتور لورا (LoRA) با ۲.۳ میلیون پارامتر را با استفاده از مجموعه داده CodeAlpaca اعمال کرد. با این حال، EmsyAI در محک HumanEval شرکت OpenAI امتیاز ۰.۰٪ کسب کرد. نکته عجیب اینجا بود که بررسیها نشان داد ۱,۶۴۴ توالی از منطق HumanEval در دادههای آموزشی نشت کرده بود، اما مدل باز هم شکست خورد. این یعنی معماری ۱۹۶ میلیون پارامتری ظرفیت لازم برای حفظ طوطیوار پاسخهای نشتکرده را ندارد.
این شکست یک بینش حیاتی را فاش میکند: ظرفیت مدل یک سقف سخت برای حافظه است. حتی وقتی پاسخها در دادههای آموزش باشند، مدلی که بیش از حد کوچک است نمیتواند تقلب کند. این موضوع تمرکز بحثها را از ترسِ «آلودگی دادهها» به رابطه بنیادی میان تعداد پارامترها و حفظ دانش تغییر میدهد.
مقیاسبندی تا ۱۹۶ میلیون پارامتر سه شکست فنی را هم آشکار کرد. اول، لاجیتهای توجه در بُعد پنهان ۱۰۲۴ بهشدت نوسان داشتند که قرار است در نسخه V5 با QK-Norm اصلاح شود. دوم، باگی در توکنساز BPE باعث تداخل بین توکنهای کنترلی و بایتهای ۰ تا ۳ شد. در نهایت، لودر دادهها فایلها را بهصورت کورکورانه متصل میکرد که منجر به «مسمومیت توجه» شد؛ وضعیتی که مدل به اسناد نامرتبط توجه میکرد. این چالشهای پیکربندی دستی دقیقاً همان دلیلی است که پروژههایی مانند Tensorless را برای حذف تنظیمات دستی در PyTorch به وجود آورده است.
گام بعدی شما
- اگر به معماری مدلها علاقه دارید، وزنهای GGUF این مدل را از گیتهاب EmsyAI دانلود کنید.
- مدل را از طریق اولاما (Ollama) بهصورت محلی اجرا کنید تا اثر ناپایداریهای ذکر شده را ببینید.
- مستندات پیادهسازی دستی BPE در این پروژه را برای درک عمیقتر توکنسازی مطالعه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو