تصور کنید در یک منطقه حادثهزده هستید، دکلهای مخابراتی تخریب شدهاند و تنها راهنمای شما یک مدل هوش مصنوعی روی گوشی است؛ در این لحظه، یک پاسخ اشتباه دربارهٔ خوراکی بودن یک گیاه میتواند مرگبار باشد. برای حل این بحران، تیم HeliGO در ۶ اکتبر ۲۰۲۶ معماری جدیدی را معرفی کرد که قدرت تصمیمگیری در مسائل حیاتی را بهطور کامل از مدل هوش مصنوعی میگیرد. هدف این تیم طراحی یک معماری قابلیت اطمینان (Reliability Architecture) بود که بهطور خاص برای حذف توانایی مدل در اتخاذ تصمیمات مرگ و زندگی طراحی شده است.
بسیاری از سیستمهای ایمنی فعلی برای اعتبارسنجی به اتصال شبکه و مدلهای بزرگتر وابسته هستند تا بتوانند خطاها را در سرور ثبت کنند یا اصلاحات سریع (Hotfixes) را اعمال نمایند. اما در شرایط اضطراری، دکلهای تلفن همراه اغلب تبدیل به تلی از آوار میشوند و گوشیها برای روزها در حالت هواپیما میمانند. در چنین محیطی، این فرض استاندارد که یک مدل «باهوشتر» میتواند اشتباهات یک مدل «کوچکتر» را شناسایی کند، از بین میرود. در واقع، هیچ مدل بزرگتری برای فراخوانی وجود ندارد و هیچ اصلاحیه نرمافزاری بهموقع نخواهد رسید.
تیم HeliGO با تکیه بر بحثهای فنی پیشین درباره «پین کردن رشتهها» (Thread Pinning) و «بارگذاری تنبل» (Lazy Loading) برای تراشههای موبایل، بر روی شکاف اعتماد تمرکز کرد. آنها دریافتند که در مدلهای کوچک، پرسیدن از هوش مصنوعی درباره اینکه آیا از پاسخ خود «مطمئن» است یا خیر، نتیجهای بدتر از پرتاب سکه دارد. طبق گزارش این تیم، در بسیاری از موارد، میزان اعتماد مدل معکوس بود؛ یعنی پاسخهای غلط، امتیاز اطمینان بالاتری نسبت به پاسخهای درست داشتند. این بدان معناست که لایه قابلیت اطمینان نمیتواند در خروجی متنی مدل جای بگیرد، بلکه باید مانند یک پوسته، کل مدل را در بر بگیرد. این رویکرد در راستای تحولی گستردهتر در صنعت است که در آن مدلهای چندلایهی قابلیت اطمینان در حال جایگزینی استانداردهای سنتی SLA میشوند تا پایداری سیستمها در شرایط بحرانی تضمین شود.
چرا پرامپتنویسی در حالت آفلاین شکست میخورد؟
شاید فکر کنید یک پرامپت سیستمی (System Prompt) — مانند دستورالعملهای سختگیرانهای که به یک کارمند تازهکار میدهیم تا اشتباه نکند، مثلاً: «تو یک دستیار مدیریت بحران هستی. هرگز توصیه خطرناک نکن و هرگاه مطمئن نبودی، بگو که نمیدانی» — کافی باشد. اما در یک مدل ۴ میلیاردی (4B) بدون دسترسی به شبکه، این روش به دو دلیل صرفاً یک «آرزومندی» است و نه یک راهکار فنی:
- پرامپتها پیشنهاد هستند، نه محدودیت: مدلهای کوچک هنگام مواجهه با «تغییر توزیع» (Distribution Shift) — مانند یک سؤال دستوری غلط و پراکنده از سوی کاربری وحشتزده درباره یک قارچ در تاریکی — همچنان ممکن است گهگاه پاسخی بسیار مطمئن، اما غلط و مرگبار تولید کنند.
- اعتماد معکوس: همانطور که اشاره شد، اعتماد اعلامشده توسط خود مدل بیفایده است. وقتی از مدل خواسته میشود عددی برای میزان اطمینان به پاسخهایش پیوست کند، تمایل دارد در زمانهایی که اشتباه میکند، جسورتر باشد.
گیتهای ایمنی سهمرحلهای
برای حل این مشکل، توسعهدهندگان یک پوسته قطعی (Deterministic Wrapper) دور مدل Edge-4B-TELL (بر پایه Gemma-4 E4B گوگل) ساختند. هر پاسخ پیش از رسیدن به کاربر باید از سه گیت مجزا عبور کند. این یک خط لوله تصمیمگیری (Decision Pipeline) است، نه یک فیلتر ساده:
- مرحله ۱: مسدودکننده خروجیهای مرگبار (Fatal-Output Block). سیستم دستههایی را شناسایی میکند که در صورت اشتباه بودن، منجر به مرگ میشوند؛ مواردی مانند «بله، میتوانید این را بخورید»، «بله، این آب پاک است» یا «بله، از این مسیر بروید». اگر پاسخی در این دستهها قرار بگیرد و هرگونه سیگنال ریسکی داشته باشد، فوراً سرکوب میشود. در اینجا اطمینان مدل هیچ ارزشی ندارد؛ اگر دسته پاسخ «مرگبار» باشد، اجازه داده نمیشود که قطعیت مدل در تصمیمگیری رأی دهد.
- مرحله ۲: جایگزینی با متن رسمی (Official-Text Substitution). اپلیکیشن حاوی ۷۵ دستورالعمل پاسخ رسمی از وزارت کشور و ایمنی کره جنوبی (MOIS) است. این دستورالعملها موارد مربوط به زلزله، سیل، آتشسوزی جنگلی و کمکهای اولیه را پوشش میدهند. اگر مدل تشخیص دهد پرسش کاربر با یکی از این دستورالعملها مطابقت دارد، بازنویسیهای هوش مصنوعی را حذف کرده و متن کلمه-به-کلمه رسمی را جایگزین میکند. مدل تنها وظیفه تطبیق و بازیابی را بر عهده دارد، اما کاربر منبع معتبر را میخواند تا از «انحراف معنایی» (Drift) در بازنویسیهای مدل ۴ میلیاردی جلوگیری شود.
- مرحله ۳: امتناع از پاسخ (Refusal). اگر پاسخ نه یک جایگزینی ایمن باشد و نه بهطور قطعی قابل تأیید، اپلیکیشن صرفاً میگوید: «مطمئن نیستم». در یک ابزار مدیریت بحران، امتناع از پاسخ یک خروجی معتبر و اغلب درست است. امتناع ممکن است کمی از زمان کاربر بگیرد، اما یک پاسخ غلطِ مطمئن میتواند به قیمت یک جان تمام شود. امتناع، حالت پیشفرض برای شکست سیستم است.
اصل عدم تقارن (The Asymmetry Principle)
این معماری بهطور عمدی به سمت «خطاهای ارزان» سوگیری دارد. تیم توسعهدهنده استدلال میکند که هزینه یک هشدار اشتباه (False Alarm) پایین است، در حالی که هزینه یک هشدار نادیده گرفته شده (Missed Warning) فاجعهبار است. این یک استدلال ساده بر اساس «هزینه مورد انتظار» است.
برای درک بهتر، سه سناریو را در مورد یک گیاه بررسی کنید:
۱. گیاه خوراکی است: اپلیکیشن میگوید «نمیتوانم تأیید کنم که این ایمن است». کاربر گرسنه میماند. این یک هزینه پایین و قابل جبران است.
۲. گیاه سمی است: اپلیکیشن میگوید «این ممکن است سمی باشد». کاربر از خوردن غذای ایمن اجتناب میکند. این نیز یک هزینه پایین و قابل جبران است.
۳. گیاه سمی است: اپلیکیشن میگوید «خوردن این ایمن است». کاربر مسموم میشود. این یک هزینه فاجعهبار است.
از آنجایی که سه مورد اول قابل بقا هستند و مورد آخر نیست، اپلیکیشن بهگونهای تنظیم شده که اشتباه غیرقابل بقا را تقریباً غیرممکن کند. سیستم هرگز نمیگوید چیزی «ایمن» است، اما همیشه در صورت احتمال «سمی بودن» هشدار میدهد. این رویکرد در مورد ۱۲ هشدار مربوط به گونههای سمی و زهرآگین که همراه اپلیکیشن ارائه شده نیز صدق میکند: هشدار اشتباه ارزان است، اما نادیده گرفتن خطر، گران.
خواندن مدل از طریق TELL
برای اینکه گیتها بدون تکیه به کلمات خود مدل کار کنند، تیم از تکنیک TELL استفاده کرده است. بهجای پرسیدن عدد اطمینان از مدل، TELL وضعیتهای نهان (Hidden States) داخلی مدل را در حین تولید پاسخ میخواند.
منطق این است که محاسباتی که یک ترنسفورمر در مسیر رسیدن به پاسخ انجام میدهد، سیگنالی درباره این دارد که آیا آن پاسخ بر پایه دادههای مستحکم است یا خیر. این وضعیت داخلی صادقانهتر از گزارش متنی است که مدل در انتها ارائه میدهد، زیرا وضعیتهای نهان هیچ انگیزهای ندارند تا برای کاربر «مطمئن به نظر برسند».
با تبدیل مدل به یک «ابزار برای خواندن» بهجای یک «شاهد برای بازجویی»، سیستم تخمینی از قابلیت اطمینان بهدست میآورد که خارج از جریان توکنها (Token Stream) قرار دارد. اگرچه سیگنالهای داخلی و آستانههای دقیق برای جلوگیری از دور زدن گیتها محرمانه نگه داشته شدهاند، اما نکته معماری این است که بررسی اطمینان، خارجی نسبت به متن است.
زیرساخت کاملاً آفلاین
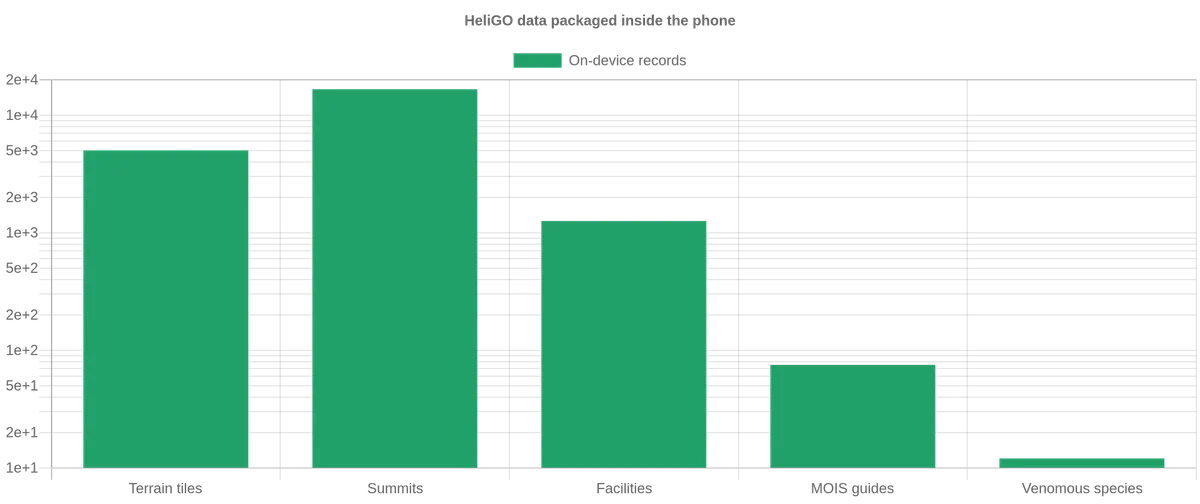
برای اینکه یک ابزار واقعاً آفلاین باشد، عبارت «روی دستگاه» (On-device) باید معنای تحتاللفظی داشته باشد. هر آنچه گیتها و نقشه نیاز دارند، در اپلیکیشن بستهبندی شده تا با خاموش بودن رادیو (اتصالات) کار کند. دادههای زیر بهصورت محلی ذخیره شدهاند:
- عوارض زمین و نقشهبرداری: ۴۹۹۸ تایل زمین با دادههای ارتفاعی و خطوط تراز که بهطور خودکار بر اساس محدوده زوم بازترسیم میشوند.
- دادههای قلهها: ارتفاع ۱۶۵۶۸ قله کوهستانی.
- تسهیلات اضطراری: ۱۲۵۵ مرکز پناهگاه، پزشکی، آب و آتشنشانی، شامل مسیریابی به نزدیکترین نقاط مرتفع برای زمان سیل.
- پایگاه متون رسمی: ۷۵ دستورالعمل پاسخ رسمی MOIS برای جایگزینی در مرحله دوم.
- هشدار گونهها: ۱۲ هشدار مربوط به گونههای سمی و زهرآگین.
- مدل: مدل Edge-4B-TELL برای چت آفلاین، شناسایی عکس و ورودی صوتی.
هیچیک از این موارد با سرور ارتباط برقرار نمیکنند. تاریخچه مکان هرگز دستگاه را ترک نمیکند، که این هم یک ویژگی حریم خصوصی است و هم یک ویژگی قابلیت اطمینان؛ زیرا هیچ وابستگی به شبکهای وجود ندارد که احتمال شکست داشته باشد.
خلاصه معماری قابلیت اطمینان
چگونه میتوان یک هوش مصنوعی آفلاین را بدون وجود مدل بزرگتر برای بررسی، قابل اعتماد کرد؟ پاسخ این است: اعتماد را از داخل مدل خارج کرده و به یک پوسته قطعی منتقل کنید. مدل پیشنویس میزند و بازیابی میکند، اما گیت کنترلشده توسط مهندسان تصمیم میگیرد چه چیزی به کاربر برسد.
- دستههای مرگبار بر اساس محتوا مسدود میشوند، نه بر اساس میزان اطمینان.
- پاسخهای معتبر از متون رسمی بستهبندی شده میآیند.
- عدم قطعیت منجر به امتناع از پاسخ میشود.
مدل هرگز حرف آخر را در مورد هر چیزی که میتواند باعث مرگ شود، نمیزند. این ثابت میکند که قابلیت اطمینان در هوش مصنوعی لبه (Edge AI) از پوسته (Wrapper) میآید، نه از تعداد پارامترها. یک مدل ۴ میلیاردی برای تراشههای مصرفکننده کافی است، به شرطی که منطق ایمنی قطعی و خارج از وزنهای مدل باشد.
پرسشهای متداول (FAQ)
آیا HeliGO چیزی را به سرور ارسال میکند؟
خیر. نقشهها، خطوط تراز، ارتفاع، قطبنما، مختصات امداد و چت هوش مصنوعی همگی روی دستگاه و در حالت هواپیما اجرا میشوند. تاریخچه مکان از گوشی خارج نمیشود.
مدل مورد استفاده چیست؟
مدل Edge-4B-TELL که بر پایه Gemma-4 E4B گوگل ساخته شده و در Hugging Face منتشر شده است. این مدل چت آفلاین، شناسایی عکس و ورودی صوتی را روی تراشه خود گوشی مدیریت میکند.
چرا هرگز نمیگوید چیزی برای خوردن ایمن است؟
زیرا هزینه اشتباه در اینجا نامتقارن است. از دست دادن یک وعده غذایی ایمن منجر به گرسنگی میشود، اما یک تأیید اشتباه منجر به مسمومیت میگردد. گیت سیستم به سمت خطای قابل جبران سوگیری دارد.
آیا میتوانم به میزان اطمینان هوش مصنوعی هنگام پاسخ دادن اعتماد کنم؟
خیر. در این مدل اندازهگیری شد که پاسخهای غلط تمایل دارند با اطمینان بیشتری بیان شوند تا پاسخهای درست. HeliGO اطمینان را از وضعیت داخلی مدل (TELL) استخراج میکند.
آیا این جایگزینی برای تماس با خدمات اضطراری است؟
خیر. HeliGO جایگزین خدمات امداد و نجات نیست. اگر هرگونه سیگنالی دارید، ابتدا با خدمات اضطراری تماس بگیرید. این ابزاری برای زمانی است که هیچ اتصالی ندارید.
نکات کلیدی برای توسعهدهندگان لبه
۱. منطق ایمنی را خارج از مدل قرار دهید. پرامپت یک پیشنهاد است؛ یک گیت قطعی یک محدودیت است.
۲. به اطمینان خود-گزارشی (Self-reported) اعتماد نکنید. پیش از تکیه بر آن، بررسی کنید که آیا کالیبره شده است یا خیر، زیرا ممکن است معکوس باشد.
۳. مدیریت خطا را نامتقارن کنید. وقتی هزینهها نامتقارن هستند، به سمت اشتباه ارزان سوگیری کنید.
۴. همه چیز را بستهبندی کنید. برای یک ابزار واقعاً آفلاین، هر دادهای که اپلیکیشن نیاز دارد باید روی دستگاه باشد.
منتظر بهروزرسانیهای آینده در مورد تکنیک TELL باشید که ممکن است فیلترینگ عدم اطمینان را بهطور مستقیمتری برای کاربر نهایی نمایش دهد.
اما داستان سختافزاری اجرای این مدلها روی تراشههای موبایل حتی پیچیدهتر است — به تحلیل ما درباره بهینهسازیهای NPU مراجعه کنید.



گفتگو