اگر فارغالتحصیل جدیدی هستید که ساعتها وقت خود را با کلیک روی دکمهٔ «Easy Apply» برای شغلهایی که اصلاً نمیخواهید تلف میکنید، فریمورک Job Searcher راه نجات شماست. این سیستم که در ۶ ژوئن ۲۰۲۶ از طریق Hugging Face منتشر شد، جستوجوی دستی را با یک خط لولهٔ سهمرحلهای جایگزین میکند: تولید پرسوجو، استخراج خودکار دادهها و امتیازدهی چندبعدی.
جستوجوی شغل به یک شغل تماموقت تبدیل شده است؛ جایی که هزینهٔ ذهنی ارزیابی یک آگهی، گاهی از هزینهٔ ارسال یک درخواست کورکورانه بیشتر است. بسیاری از متقاضیان دچار «خستگی از درخواست» (application fatigue) میشوند و برای حفظ انگیزه، برای نقشهایی در صنایعی اقدام میکنند که حتی از آنها متنفرند. Job Searcher با ایفای نقش به عنوان یک فیلتر شخصی، تنها فهرستی کوتاه از نقشهای مناسب را همراه با استدلالی منطقی ارائه میدهد.
همانطور که در تحلیلهای پیشین ما دربارهی عاملهای هوشمند (AI Agents) اشاره کردیم، کلید موفقیت این ابزارها در توانایی آنها برای تبدیل اهداف کلی به گامهای اجرایی دقیق است. این سیستم از یک معماری تقطیر (Distillation) — شبیه به وقتی که یک استاد Experienced تمام نکات کلیدی یک کتاب هزار صفحهای را در چند برگه خلاصه میکند تا شاگردش سریعتر یاد بگیرد — استفاده میکند.
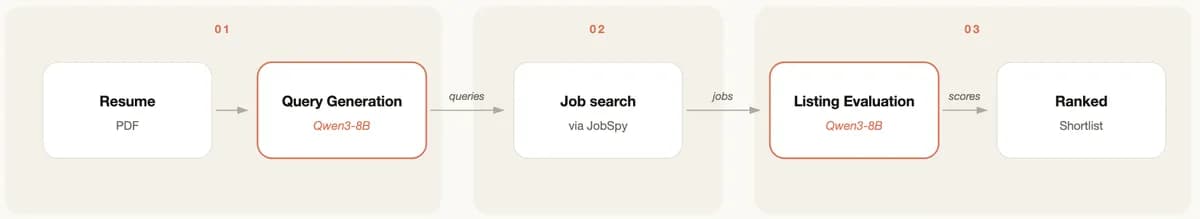
طبق مستندات فنی در huggingface.co، این سیستم در سه مرحله عمل میکند تا از یک رزومه به یک لیست کوتاه برسد:
۱. تولید پرسوجو: مدل شاگرد رزومه و ترجیحات کاربر (از جمله نوع شغل، مکان، نحوه همکاری و یادداشتهای آزاد) را میخواند تا پرسوجوهای متناسب با ساختار لینکدین را طراحی کند و در حین این کار، استدلالهای خود را بهصورت بلند بیان کند.
۲. جستوجو: این پرسوجوها یکییکی از طریق ابزار JobSpy به لینکدین ارسال و پردازش میشوند.
۳. امتیازدهی: مدل، جفتِ (رزومه، شغل) را تحلیل کرده و در ۵ بُعد امتیاز میدهد.
به نقل از توسعهدهندگان، مدل «استاد» در این پروژه DeepSeek V4 Pro بود که به دلیل قدرت بالا در استدلال ساختاریافته و توانایی پیروی از طرحهای خروجی (output schemas) سختگیرانه انتخاب شد. این مدل آفلاین، مجموعهای از ۲۵۰۰ رزومه را که بر پایه Divyaamith/Kaggle-Resume ساخته شده بود، پردازش کرد تا برچسبهای آموزشی بسازد. سپس این پرسوجوها از طریق JobSpy حدود ۱۰,۰۰۰ آگهی شغلی لینکدین را استخراج کردند. هر یک از این آگهیها توسط پرسوجویی سطحدهی شده بود که مدل استاد بهطور خاص برای آن رزومه نوشته بود. در نهایت، مدل استاد برای هر جفتِ بهدستآمده، یک جمله استدلال برای هر بُعد نوشت.

در بخش جزئیات فنی، مدل «شاگرد» یعنی Qwen3-8B انتخاب شد. این مدل به گونهای طراحی شد که پس از کوانتیزه شدن به Q4_K_M، به اندازه کافی کوچک باشد تا روی یک تکه ZeroGPU جای بگیرد، اما آنقدر قدرتمند باشد که قضاوتهای مدل استاد را جذب کند.
بر اساس گزارش فنی پروژه، جزئیات پیادهسازی به شرح زیر است:
- آموزش: تیم توسعه دو اجرای LoRA SFT روی یک GPU مدل A100 از طریق Modal انجام داد. هر تسک یک epoch داشت و برای بررسی صحت عملکرد (sanity checking)، هر ۲۰۰ گام یک چکپوینت میانی گرفته میشد.
- پیکربندی LoRA: این تنظیمات از رتبه (Rank) ۱۶ و آلفای ۱۶ استفاده کرد. در این حالت Dropout خاموش بود و لایههای q_proj، k_proj، v_proj، o_proj، gate_proj، up_proj و down_proj هدف قرار گرفتند.
- خروجیها: مصنوعات نهایی شامل Safetensors و نسخههای Q4_K_M base به همراه sidecarهای LoRA-GGUF برای مسیر سرویسدهی llama.cpp است.
برای اطمینان از دقت بالا، توسعهدهندگان تسکها را به دو آداپتور مجزا تقسیم کردند: یکی برای تولید پرسوجو و دیگری برای ارزیابی تناسب. این کار باعث شد تا مدل از نشت فرمتهای JSON به پاسخهای متنی (prose) جلوگیری کند.
هر شغل در ۵ بُعد ارزیابی میشود:
- تطبیق مهارتها
- مرتبط بودن تجربه
- تحصیلات و گواهینامهها
- تناسب با صنعت/دامنه
- همسویی با سطح ارشدیت (Seniority)
این سیستم برای استقرار از llama-cpp-python با یک CUDA wheel پیشساخته در فضای HuggingFace ZeroGPU Space استفاده میکند. برای حذف تأخیر ناشی از «استارت سرد» (Cold Start)، توسعهدهندگان سیستم را طوری طراحی کردند که تمام ارزیابیهای تناسب برای یک درخواست واحد، در یک فراخوانی GPU انجام شود. دلیل این کار این است که ZeroGPU با هر فراخوانی، کانتکست CUDA را بازیافت میکند و اگر یک نمونه در سطح ماژول (module-level instance) تعریف شود، در استفاده دوم کانتکست مرده خواهد داشت. این معماری اجازه میدهد تا استدلالها بهصورت توکنبه-توکن از طریق API مدل OpenAI یعنی create_chat_completion(stream=True) برای کاربر جاری شوند.
این رویکرد ثابت میکند که کیفیت پرامپتِ مدل استاد، بسیار حیاتیتر از اندازه مدل شاگرد است. با مجبور کردن DeepSeek V4 Pro به ذکر جزئیات دقیق رزومه (مثلاً ذکر «چهار سال تجربه Rust در حالی که شغل پنج سال میخواهد» بهجای عبارت کلی «تطبیق فنی خوب»)، مدل شاگرد دقتی را به ارث برد که پرامپتهای عمومی هرگز نمیتوانند تولید کنند.
برای شما به عنوان کاربر، این یعنی سد ورود به ساخت ابزارهای تخصصی و عاملمحور (agentic) در حال ریزش است. اگر بتوانید «عادات استدلالی» یک مدل پیشرو را در یک مدل ۸ میلیارد پارامتری کوانتیزه شده که روی یک تکه GPU جای میگیرد تقطیر کنید، دیگر نیازی به مدلهای غولپیکر در زمان استنتاج (inference) ندارید.
تیم سازنده حتی تمام جلسات Claude Code را به عنوان مجموعهدادهای از ردپای عاملها (agent-traces) منتشر کرده است. این مجموعه از طریق رویدادهای raw JSONL و نمایشدهنده ردپای بومی HuggingFace، نگاهی شفاف به هر بنبست و بازیابی در مسیر ساخت پروژه ارائه میدهد.
گام بعدی شما
- اگر برنامهنویس هستید، مجموعهداده agent-traces را در Hugging Face بررسی کنید تا با نحوه تعامل Claude Code با کد آشنا شوید.
- برای اتوماسیون شخصی، ابزار JobSpy را برای استخراج دادههای لینکدین امتحان کنید.
- سعی کنید مدلهای کوچک (زیر ۱۰ میلیارد پارامتر) را با دادههای استدلالی مدلهای بزرگتر Fine-tune کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو