
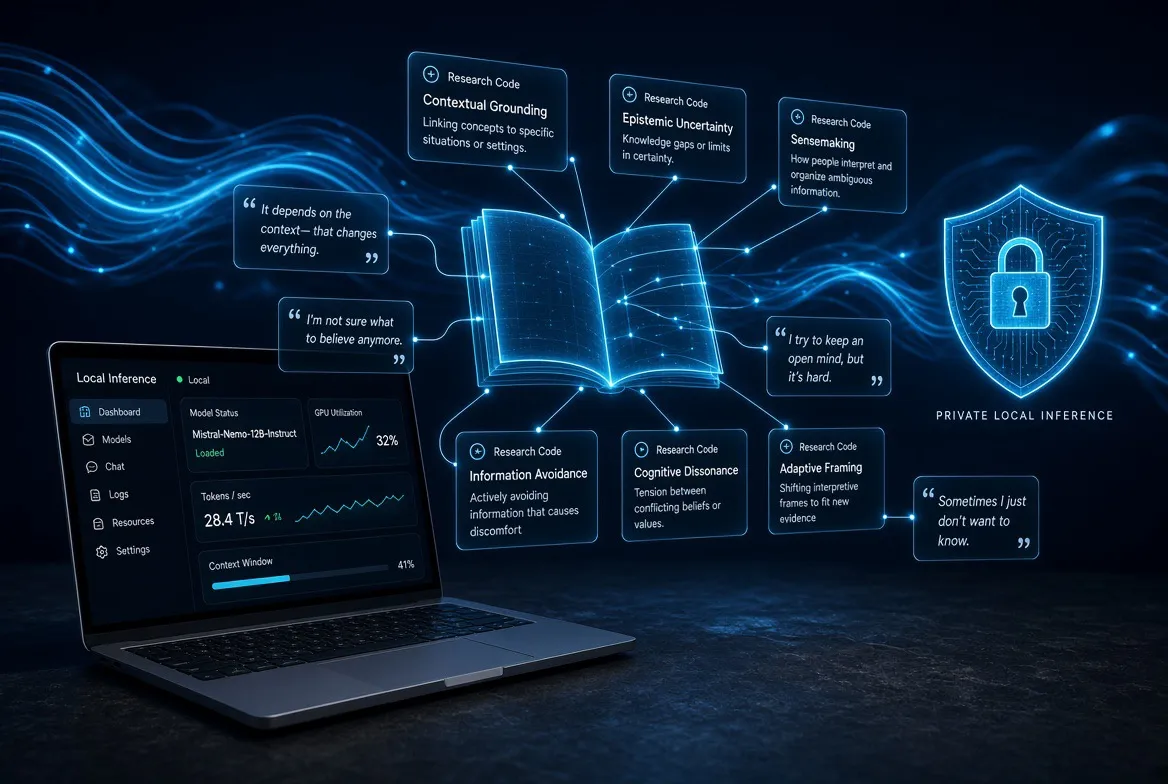
اگر پژوهشگری هستید که با دادههای حساس مصاحبههای انسانی سروکار دارید، نشت اطلاعات به ابرهای عمومی یک ریسک غیرقابلپذیر است. اکنون با ترکیب یک مدل ۲۴ میلیارد پارامتری مثل Mistral Small 3.1 با Ollama و FastAPI، تیمهای تحقیق میتوانند اولین مرحله از کدگذاری مضمونی را بهطور کامل خودکار کنند. این استقرار محلی تضمین میکند که دادههای حساس بدون ریسک نشت در محیطهای ابری پردازش شوند.
این رویکرد در زمانی ارائه میشود که سازمانها با تضاد شدید میان بهرهوری هوش مصنوعی و حریم خصوصی دادهها دستوپنجه نرم میکنند. همانطور که در تحلیل قبلی ما دربارهی استراتژیهای Mistral برای هوش مصنوعی حاکمیتی (Sovereign AI) در عربستان اشاره کردیم، چرخش به سمت استقرار محلی برای بخشهایی با قوانین سختگیرانه اقامت دادهها، به یک ضرورت تبدیل شده است. برای پژوهشگران، این تغییر شبیه جابهجایی از یک کتابخانه عمومی به یک گاوصندوق خصوصی است؛ شما ابزارها را دارید، اما کلید در را در دست خودتان نگه میدارید.
پشته فنی هوش مصنوعی محلی
به نقل از راهنمای منتشر شده در وبسایت dev.to در ۱ سپتامبر ۲۰۲۶، هسته این گردشکار خصوصی بر سه مؤلفه متکی است:
- Ollama: برای اجرای مدلها بهصورت خصوصی روی ماشینهای محلی یا ماشینهای مجازی مجهز به GPU (واحد پردازش گرافیکی). این ابزار با رشد سریع کاربرانی که به دنبال استقلال از ابر هستند، به نمادی از تغییر جهت صنعت به سمت هوش مصنوعی محلی تبدیل شده است.
- Mistral Small 3.1: یک مدل با ۲۴ میلیارد پارامتر که بهعنوان موتور تحلیلی برای پیشنویس ورودیهای کدباک عمل میکند. در سال ۲۰۲۶، Mistral از این مدل بهعنوان والد خانواده Ministral 3 برای تولید مدلهای بینایی-زبانی کوچکتر از طریق هرس کردن (Pruning) و distillation (تقطیر) استفاده کرد.
- FastAPI: لایه کاربردی که درخواستها را مدیریت کرده و خروجیهای تحلیلی را بازمیگرداند.
اعتبارسنجی و تأیید
بسیار حیاتی است که میان معماری تأییدشده و ادعاهای فنی پشتیبانینشده تمایز قائل شویم. در حالی که استفاده از Ollama و Mistral Small 3.1 تأیید شده است، این طرح بیشتر یک نقشه ساخت است تا یک دستورالعمل «کپی و اجرا».
پژوهشگران باید پیش از استقرار نهایی، موارد زیر را بهطور مستقل بررسی کنند:
- شناسههای دقیق مدلهای قابل دانلود در Ollama و نقاط انتهایی API.
- پورتهای پیشفرض شبکه و گزینههای خروجی ساختاریافته.
- محدودیتهای پنجره زمینه (Context Window) — مثل میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — و شرایط مجوز.
- نیازمندیهای سختافزاری تضمینشده برای مدل ۲۴ میلیارد پارامتری.
- نسخههای وابستگی پایتون و انتخابهای مدل بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که همسایگی آن با کلمات دیگر را مشخص میکند.
- انتخاب پایگاهداده برداری و الگوریتمهای خوشهبندی.
این انضباط مانع از شکست رایج در آموزشهایی میشود که دستورات یا طرحهای درخواست آنها با محیط فعلی مطابقت ندارد.
مسئله پژوهشی: از پاسخهای خام تا کدها
یک کدباک کیفی، یک ابزار تحلیلی مستند است و نه صرفاً فهرستی از برچسبها. هر ورودی به یک نام واضح، تعریف، راهنمای شمول، راهنمای عدم شمول و شواهد منبع نیاز دارد. این ساختار اجازه میدهد سایر بازبینهای واجد شرایط، پیشنهادها را درک کنند. همچنین پژوهشگران باید ثبت کنند که کدها چگونه در طول زمان ادغام، تقسیم، تغییر نام، رد یا اعمال شدهاند.
هوش مصنوعی محلی با سازماندهی گزیدهها، پیشنهاد برچسبها و پیشنویس تعاریف، در حجم کاری مرحله اول کمک میکند. با این حال، مدل نمیتواند بهطور مستقل شیوع، علیت، قصد شرکتکننده، ویژگیهای جمعیتشناختی یا اعتبار یک نتیجه پژوهشی را تعیین کند. یک برچسب مضمونی تنها پیشنهادی برای تحلیل است، نه یک یافته نهایی.
گردشکار پژوهشی پنج مرحلهای
این راهنما تأکید میکند که هوش مصنوعی باید مضامین را پیشنهاد دهد، نه اینکه یافتهها را تثبیت کند. توالی پیشنهادی برای تضمین قابلیت حسابرسی، گروهبندی دادهها را از تفسیر جدا میکند:
۱. جذب بدنه: دریافت بدنه پژوهشی محدود و نرمالسازی متن در حالی که پیوند به ردیفهای منبع حفظ شود.
۲. گروهبندی شباهت: استفاده از روشهای مستند برای گروهبندی گزیدههای مرتبط، پیش از آنکه هوش مصنوعی آنها را ببیند. این کار باعث جداسازی عملیات گروهبندی از تفسیر معنایی میشود.
۳. پیشنویس محدود به شواهد: درخواست از مدل برای تدوین یک پیشنهاد کدباک برای هر گروه، صرفاً با استفاده از متن ارائهشده.
۴. تأیید انسانی: الزام پژوهشگر به تأیید، ادغام یا رد کدهای پیشنهادی.
۵. مستندسازی: ثبت نحوه تکامل کدها در طول زمان برای حفظ یک ابزار تحلیلی قابل دفاع.
حفاظت از دادههای حساس
حریم خصوصی در این سامانه خودکار نیست. طبق گزارش این راهنما، در حالی که Ollama دادهها را محلی نگه میدارد، امنیت کلی به دسترسی نقاط انتهایی، ذخیرهسازی رمزنگاریشده و مجوزهای کاربر بستگی دارد. این موضوع برای تیمها در کشورهای حوزه خلیج فارس و خاورمیانه، جایی که قوانین اقامت دادهها، مقررات بخشی، رضایت شرکتکنندگان و محدودیتهای انتقال فرامرزی بر اساس حوزه قضایی متفاوت است، حیاتی است.
استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه خودِ آشپزی است نه دوره آموزش آشپز — جابهجایی غیرضروری دادهها به بیرون را کاهش میدهد، اما جایگزینی برای بررسیهای حقوقی یا ارزیابی مستند حاکمیت داده نیست. تیمها باید پیش از پردازش، به چهار پرسش پاسخ دهند:
- چه کسی میتواند فایلهای پژوهشی را آپلود یا دانلود کند؟
- ورودیهای خام، گزارشهای تولیدشده، لاگها و پشتیبانها کجا ذخیره میشوند؟
- کدام فیلدها ممکن است هویت شرکتکننده یا سازمان را فاش کند؟
- هر اثر تا چه زمانی در دسترس خواهد بود؟
برای جلوگیری از نشت تصادفی، گردشکار یک «قرارداد جذب ایمن» را اجرا میکند. این کار مستلزم آن است که کاربران صراحتاً ستون متن (مثلاً interview_excerpt ، response ، comment یا research_note) را نامگذاری کنند تا مدل بهطور تصادفی اطلاعات شناسایی شخصی (PII)، جزئیات تماس یا شمارههای داخلی تیکتها را تحلیل نکند.
جزئیات پیادهسازی فنی
پیادهسازی این سیستم نیازمند یک محیط منضبط است. پیشنهاد میشود ابتدا با یک مجموعه داده آزمایشی غیرحساس — یا مصنوعی یا صراحتاً تأییدشده — شروع کنید تا گردشکار پیش از انتقال به مصاحبههای محرمانه، اعتبارسنجی شود.
محیط و عملکرد:
- محیط: از یک محیط توسعه ایزوله استفاده کنید. نوع میزبان، نسخه سیستمعامل، نسخه Ollama، شناسهی دقیق مدل، منبع فایل مدل و تاریخ اعتبارسنجی را ثبت کنید.
- زیرساخت: در صورت استفاده از ماشین مجازی خصوصی، کنترلهای حساب ارائهدهنده، منطقه (Region)، سیاست فایروال و هویت مدیر سیستم را ثبت کنید. برای ایستگاههای کاری، بررسی کنید که آیا سایر کاربران محلی به کش مدلها، گزارشها، آپلودهای مرورگر، تاریخچه شل یا فایلهای موقت دسترسی دارند یا خیر.
- عملکرد: محیطهای مجهز به GPU برای بهرهوری توصیه میشوند. اما ظرفیت به کوانتش (Quantization)، انتخابهای زمان اجرا، حجم کاری همزمان و حافظه در دسترس بستگی دارد. از ادعاهای کلی درباره رم یا سرعت بدون شواهد حاصل از تنظیمات واقعی اجتناب کنید.
طراحی API و جذب:
- طراحی API: سرویس FastAPI باید از طراحی «شغل پسزمینه» (Background-job) برای مطالعات بزرگ استفاده کند تا از قطع شدن درخواستهای وب در حین تولید بردارها و تولید متن جلوگیری شود. وضعیتها باید بهصورت صفبندیشده، در حال اجرا، تکمیلشده، شکستخورده یا در انتظار بررسی انسانی نمایش داده شوند. سیستم هرگز نباید گزیدههای شکستخورده را بهطور بیصدا حذف کند یا یک کدباک ناقص را بهجای نسخه کامل بازگرداند.
- نگاشت ارجاع: به هر پاسخ یک مرجع داخلی پایدار اختصاص دهید. این کار به بازبینها اجازه میدهد بدون قرار دادن کل مجموعه داده در هر پرامپت، استنادها را به رکوردهای منبع ردیابی کنند. این نگاشت باید تحت همان کنترلهای دسترسی بدنه پژوهش نگهداری شود.
- قوانین نرمالسازی: قوانینی برای رد رکوردهای خالی، حذف فضاهای خالی (Trim) و شناسایی موارد تکراری مستند کنید. حذف تکرارهای دقیق از اعوجاج جلوگیری میکند، اما حذف تکرارهای نزدیک میتواند تفاوتهای معنادار (مثلاً یک نفی ساده) را پاک کند.
- محدودیتها: محدودیتهای عملی برای اندازه فایل، تعداد ردیفها، حداکثر کاراکتر در هر پاسخ و مدت زمان نگهداری گزارشها را بر اساس تستهای ظرفیت و ارزیابیهای تهدید تعیین کنید. افزایش محدودیتها بدون تغییر در طراحی میتواند باعث فشار به حافظه یا قرار گرفتن در معرض حملات منع سرویس (DoS) شود.
نقش Mistral Small 3.1
مقیاس ۲۴ میلیارد پارامتری Mistral Small 3.1 برای یک وظیفه محدود به کار میرود: تدوین نام کد، تعریف موجز، معیارهای شمول/عدم شمول و ارجاعات شواهد. مدل صراحتاً دستور میگیرد که فقط از متن ارائهشده استفاده کند و پروفایل شرکتکنندگان، علل رفتار، معیارهای محصول یا نتایج حقوقی را ابداع نکند.
اگر گزیدهای فاقد اطلاعات کافی باشد، مدل باید بهجای تولید یک روایت صیقلخورده که شکافها را پر کند، یک پیشنهاد با اطمینان پایین یا درخواست برای بررسی بازگرداند. پرامپت باید هر گزیده را با یک مرجع داخلی پایدار شناسایی کرده و الزام کند که یک برچسب عدم قطعیت از یک لیست ثابت انتخاب شود.
اعتبارسنجی خروجیها
هر نتیجه تولیدشده باید اعتبارسنجی شود تا اطمینان حاصل شود که:
- ارجاعات ذکرشده دقیقاً متعلق به گروه کاندید ارائهشده است.
- فیلدهای مورد نیاز مطابق با طرح (Schema) تأییدشده هستند.
- متن تولیدشده ادعای قطعیت بدون پشتوانه نمیکند.
این راهنما تأکید میکند که بازگرداندن متنی شبیه JSON توسط مدل، دلیلی بر صحت آن نیست؛ خروجیهای بدشکل باید بهعنوان خطای سیستم با یک مسیر تلاش مجدد (Retry) واضح تلقی شوند.
ایجاد گروههای کاندید
پیش از آنکه هوش مصنوعی کدها را تدوین کند، تیم باید رویکرد شباهت و گروهبندی را انتخاب کند. بردارها و خوشهبندی مفید هستند اما حقیقت مطلق نیستند. یک پارامتر خوشهبندی میتواند گروههای بسیار محدود یا بسیار گسترده ایجاد کند، یا مرزهای ناپایداری بسازد.
هنگام استفاده از مدلهای بردار محلی، هویت دقیق، نسخه، منبع و پیشپردازشهای اعمالشده را مستند کنید. معیار شباهت، روش خوشهبندی، تصمیم درباره آستانه یا تعداد خوشهها و حداقل اندازه گروه را ثبت کنید. این ردیابی ضروری است زیرا اجرای مجدد در آینده ممکن است پس از یک تغییر پیکربندی، گروهبندیهای متفاوتی تولید کند.
برای جلوگیری از پنهان کردن تجربیات اقلیت یا موارد خاص، صفحه بررسی باید هم شواهد انتخابشده برای پرامپت و هم مجموعه کامل رکوردهای اختصاصیافته به آن گروه را نمایش دهد. از زبانی که بازتابدهنده عدم قطعیت است، مانند «مضامین کاندید» یا «کدهای پیشنهادی» استفاده کنید.
ارزیابی روش
موفقیت با کاربردی بودن کدباک سنجیده میشود، نه سرعت API. یک اجرای آزمایشی باید شامل یک بدنه متنوع با گروههای متمایز، مثالهای مبهم و الگوهای متناقض باشد. حداقل یک بازبین واجد شرایط باید رکوردهای خام، گروههای پیشنهادی، شواهد انتخابشده و ورودیهای تدوینشده را بررسی کند.
بازبینها باید ارزیابی کنند که:
- آیا گروههای کاندید، تمایزات معنادار را حفظ کردهاند؟
- آیا مدل فقط به شواهد ارائهشده استناد میکند؟
- آیا تعاریف برای یک کدگذار دوم قابل استفاده است؟
- آیا معیارهای عدم شمول از همپوشانی بین کدها جلوگیری میکند؟
شکستهای عملیاتی نیز باید تست شوند. سیستم باید در صورت عدم دسترسی به زمان اجرای مدل، نصب نبودن مدل، نبود ستون درخواستی در فایل یا فراتر رفتن فایل از محدودیتها، خطاهای کنترلشده ارائه دهد.
تحلیل: تغییر پارادایم پژوهشی
این گردشکار این فرض را تغییر میدهد که پژوهش کیفی باید انتخابی بین نیروی کار دستی و ریسکهای ابری باشد. با تبدیل هوش مصنوعی به یک «دستیار پیشنویس» بهجای یک «تحلیلگر»، پژوهشگر مسئولیت متدولوژیک را حفظ میکند. این رویکرد در واقع بخشی از یک جنبش گستردهتر است که در آن زیرساختهای باز در برابر مدلهای بسته برای بازپسگیری مالکیت دادهها قرار میگیرند.
برای یک پژوهشگر حرفهای، این بدان معنای آن است که ارزش از توانایی برچسبگذاری دادهها به توانایی حسابرسی منطق گروهبندی هوش مصنوعی منتقل میشود. اثر مرتبه دوم این است که فرآیند پژوهش شفافتر میشود، جایی که هر کد به یک زنجیره شواهد محلی و خاص متصل است.
گامهای بعدی
پژوهشگران اکنون باید بر ایجاد یک فضای کاری برای بررسی انسانی تمرکز کنند که اجازه ادغام و تقسیم گروههای پیشنهادی توسط هوش مصنوعی را بدهد. این فضای کاری باید هر تصمیم ویرایشی را با برچسب زمانی و هویت بازبین حفظ کند.
علاوه بر این، یک فرآیند نگهداری و حذف دادهها ایجاد کنید. گزارشهای تولیدشده حاوی گزیدههای نماینده، به اندازه بدنه اصلی پژوهش حساس هستند. تصمیم بگیرید که این گزارشها کجا ذخیره شوند، چه کسی به آنها دسترسی داشته باشد، چه زمانی منقضی شوند و حذف آنها چگونه تأیید شود.
در نهایت، یکپارچگی فنی را از طریق مستندات رسمی اعتبارسنجی کنید. دستورالعملهای نصب فعلی Ollama، آرتیفکت Mistral Small 3.1 موجود برای محیط شما، رابط نرمافزاری مورد استفاده توسط زمان اجرای نصبشده و نسخههای پشتیبانیشده FastAPI و وابستگیهای پایتون را تأیید کنید.
پادمان پژوهشی: یک کد تولیدشده هرگز بهطور پیشفرض یک یافته نهایی نیست. گزیدههای استنادشده را بازبینی کنید، پاسخهای متناقض را بررسی کنید، تنظیمات گروهبندی را مستند کنید و پیش از گزارش نتایج به ذینفعان، تأیید انسانی واجد شرایط را الزامی کنید.



گفتگو