تصور کنید بخواهید مدلهای هوش مصنوعی خودتان را داشته باشید، اما نه با هزینههای میلیونی، بلکه با مبلغی کمتر از یک شام دو نفره در رستوران. این رویایی است که حالا با ابزار ML-Intern به واقعیت تبدیل شده است.
۱۰۳ دلار؛ این کل هزینهای است که یک کاربر برای استقرار هفت مدل هوش مصنوعی تخصصی در عرض چند روز پرداخت کرد. این ابزار که در محیط HuggingChat در دسترس است، یک سیستم عاملمحور (Agentic) — شبیه به یک مدیر پروژه هوشمند که هم برنامه میریزد و هم کارها را اجرا میکند — است که تمام چرخه حیات یادگیری ماشین، از برنامهریزی و جمعآوری داده تا آموزش و انتشار در Hugging Face Hub را مدیریت میکند.
بسیاری از توسعهدهندگان با سدی بلند روبرو هستند: مدلهای موجود یا برای سختافزار آنها بیش از حد بزرگاند یا تخصص لازم در یک حوزه خاص را ندارند. برای مثال، بازنویس رسمی برای مدل Qwen-Image 2.1 یک مدل ۹ میلیارد پارامتری است که به ۲۰ گیگابایت حافظه نیاز دارد. این مدل اغلب پیش از نوشتن حتی یک پاراگراف ساده، هزاران توکن — تکههای کوچکی از متن، مثل برشهای یک کیک طولانی که مدل تکهتکه میخورد — تولید میکند و به اصطلاح «فکر» میکند. برای کاربرانی که سختافزار معمولی دارند، این موضوع شکافی ایجاد میکند که در آن تنها گزینههای موجود در Hub، نسخههای فشرده شده از همان مدل حجیم ۹ میلیارد پارامتری هستند.
همانطور که در تحلیلهای قبلی ما دربارهی مدلهای زبانی کوچک اشاره کردیم، بهینهسازی مدلها برای سختافزارهای لبه یک ضرورت است. ML-Intern دقیقاً همین شکاف را پر میکند. این ابزار صرفاً کد پیشنهاد نمیدهد، بلکه مانند یک مهندس یادگیری ماشین مستقل، دستورات را روی سختافزار Hugging Face اجرا میکند، بودجه را مدیریت میکند و پیش از صرف هزینه اصلی، «تستهای دود» (Smoke Tests) میگیرد تا مطمئن شود وزنها (Weights) واقعاً تغییر میکنند و بودجه بیهوده هدر نمیرود. این عامل ابتدا کار را برنامهریزی میکند، پیش از هر هزینه درخواست بودجه میدهد، یک تست کوچک اجرا میکند و سپس به مراحل آموزش، ارزیابی و انتشار نتیجه میپردازد.
هدایت عامل با پرامپت
به نقل از گزارشی که در ۸ اکتبر ۲۰۲۶ منتشر شد، این عامل از طریق پرامپتهای دقیق هدایت میشود. کاربر در پروژه اول برای ساخت یک مدل تشخیص بیماریهای مرکبات، حدود ۴۵۰ کلمه نوشت، اما در پروژه ششم، این دستورات به ۲۰۰۰ کلمه رسید چون هر پروژه نیازهای جدیدی را به کاربر میآموخت. تمام این پرامپتها در گیتهاب در مسیر yvrjsharma/ml-intern-prompts در دسترس هستند. این رویکرد نشان میدهد که چگونه مهندسی پرامپت در حال تبدیل شدن به هسته اصلی توسعه است، هرچند بسیاری از آژانسهای جدید هوش مصنوعی صرفاً پوستهای برای همین مهندسی پرامپت هستند و ارزش افزودهی فنی کمی ایجاد میکنند.
یک پرامپت موفق در این سیستم ساختار مشخصی دارد:
- ایده: توصیف هدف و دلیل پشت آن در یک خط.
- اجزاء: نام دقیق مجموعه داده، مدل پایه و اسکریپت آموزش.
- حقایق تأییدشده: بخشی با عنوان «حقایق تأیید شده، دوباره استخراج نکن» برای جلوگیری از اتلاف بودجه با بازکشف اطلاعات شناختهشده. برای مثال در یک لورای زاویه دوربین، این بخش شامل این بود که کدام Trainer از تصاویر شفاف پشتیبانی میکند و کدام مشکلات گیتهاب باعث میشود استفاده از Trainerهای جایگزین ریسکپذیر باشد.
- خط پایه (Baseline): درخواست حیاتی برای گزارش نمره مدل پایه در حالت Zero-shot روی همان معیار پیش از آموزش، تا میزان پیشرفت واقعی و سودمند بودن آموزش کمی شود.
- تست دود: بررسی سریع برای اطمینان از کارکرد فرآیند؛ مثلاً برای لوراهای تصویری، کاربر درخواست ۵۰ گام آموزش و سپس بررسی تغییر وزنهای ذخیره شده را داد تا پیش از پرداخت هزینه کامل، از صحت روند مطمئن شود.
- خروجیها و سقف هزینه: تعریف دقیق آنچه باید در کارت مدل (Model Card) درج شود و تعیین سقف هزینه سختگیرانه (مثلاً: «مجموع هزینهها را به ۱۲ دلار محدود کن و پیش از عبور از آن از من بپرس»).
از آنجا که ML-Intern هر وظیفه را با بودجه صفر شروع میکند، این محدودیتها بهشدت رعایت میشوند. اگر بودجهای تعیین نشود، عامل مسیرهای مختلفی را بر اساس اندازه پروژه پیشنهاد میدهد و نظر کاربر را میپرسد.
بازنویس جیبی: قدرت در ابعاد کوچک
اولین پروژه روی ساخت یک «بازنویس جیبی» متمرکز بود. هدف این بود که مدل ۹ میلیارد پارامتری (معلم) به یک نسخه ۰.۸ میلیارد پارامتری (شاگرد) تبدیل شود که روی CPU اجرا شود. این فرآیند در واقع یک distillation — شبیه به عصارهگیری از یک کتاب قطور برای تبدیل آن به یک دفترچه راهنمای کوچک و کاربردی — است.
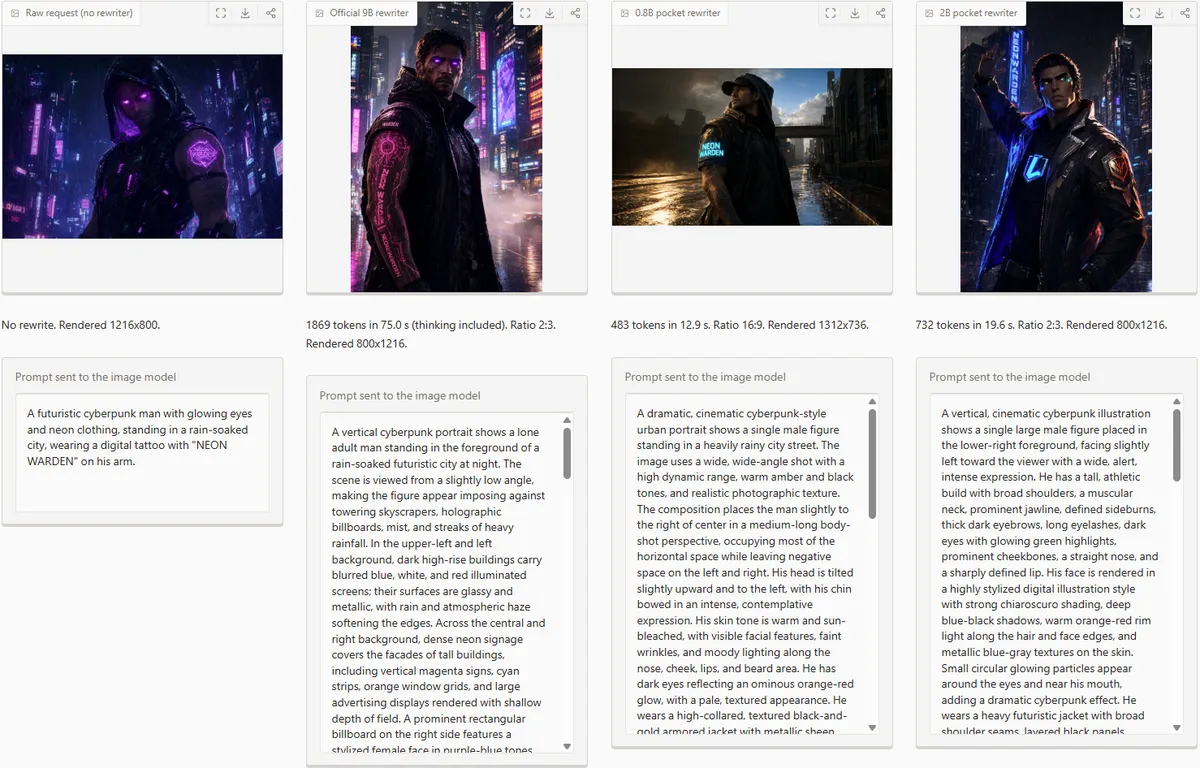
برای این کار، ML-Intern تعداد ۸,۷۹۷ درخواست کوتاه تصویری را با استفاده از یک مدل Instruct کوچک از طریق ارائهدهندگان استنتاج (Inference Providers) تولید کرد. پرامپت کاربر مشخص کرده بود که ترکیبی از عکسها، پوسترها، لوگوها و اینفوگرافیکها تولید شوند؛ به طوری که حدود یکسوم آنها درخواست متن دقیق در گیومه باشند و بسیاری از آنها به زبانهایی غیر از انگلیسی باشند. سپس مدل معلم ۹ میلیارد پارامتری، تمام اینها را در ۲ ساعت و ۳۷ دقیقه روی یک GPU A100 بازنویسی کرد که ۶.۵۰ دلار هزینه داشت. این تلاش برای دستیابی به کارایی بالا با هزینه کم، یادآور موفقیت مدل Step 3.7 Flash است که توانست عملکرد نسخههای Pro را با یکنهم هزینه بازتولید کند.
پس از فیلتر کردن کیفیت، ۱,۸۴۰ نمونه برای آموزش انتخاب شد. آموزش مدلهای شاگرد ۰.۸ و ۲ میلیارد پارامتری روی A10G تنها ۱۲ و ۱۸ دقیقه زمان برد و مجموعاً ۰.۷۵ دلار هزینه داشت. مدل نهایی ۰.۸ میلیارد پارامتری در قالب یک فایل ۸۱۲ مگابایتی GGUF عرضه شد که در ۹۹.۷٪ موارد خروجی معتبر میدهد و تنها یکچهارم توکنهای مدل معلم را مصرف میکند. کل این پروژه ۱۱ ساعت زمان و ۲۴ عملیات اجرایی با هزینه ۱۶.۰۵ دلار نیاز داشت.
بینایی تخصصی و هنر
علاوه بر تقطیر مدل، این عامل مدلهای دامنه-محور ساخت. مدل citrus-disease-vlm-instruct نمونهای از این دست است. یک مدل بینایی عمومی میتواند برگ زرد را توصیف کند، اما نمیتواند به راحتی بین مشکل کنه و کمبود منیزیم تفاوت قائل شود یا راهکارهای بیولوژیک و غیربیولوژیک برای درمان ارائه دهد.
کاربر با کمک Claude، سه منبع از سازمان Project-AgML را در Hub ادغام کرد. مجموعه داده حاصل شامل ۳,۰۱۷ تصویر برچسبگذاریشده از ۲۱ نوع آفت، بیماری، کمبودهای تغذیهای و روشهای درمانی بود. ML-Intern مدل Qwen3.5-2B را با این دادهها تحت تنظیم دقیق (Fine-tuning) — مثل وقتی به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — قرار داد. در تست روی ۳۳۵ عکس، صحت مدل پایه در تشخیص درست مشکل ۱۴.۹٪ بود که پس از دو Epoch آموزش روی یک A10G، صحت مدل به ۵۲.۸٪ رسید. هزینه این محاسبات تنها ۱.۹۰ دلار بود.
در حوزه خلاقیت، یک لورا (LoRA) برای مدل FLUX.2 klein base 4B ساخته شد تا شخصیتی به نام «Huggy» را با سبک داراییهای برند Hugging Face رسم کند. این مدل روی ۸۴ نقاشی دارای کپشن از مجموعه داده Chunte/huggy_for_training آموزش دید. عامل هر ۱۰۰ گام یک Checkpoint ذخیره کرد و پرامپتهای یکسانی را برای هر مرحله رسم کرد. گام ۲۰۰ اولین جایی بود که Huggy کاملاً مطابق مدل شد؛ اما در گام ۵۰۰، استایل شروع به «نشت» به پرامپتهای غیرمرتبط کرد. این لورا روی مدل تقطیر شده klein در ۴ گام نیز کار میکند. هزینه این پروژه ۷.۶۰ دلار بود.
سنتز پیچیده دادهها
برخی مدلها نیاز داشتند که عامل، دادههای آموزش را از صفر اختراع کند. برای ساخت لورای زاویه دوربین برای Qwen-Image 2.1، ابزار ML-Intern تعداد ۱,۰۳۰ شیء خانگی اسکن شده از Google Scanned Objects را در ۲۴ زاویه مختلف رندر کرد.
این کار منجر به تولید ۲۴,۷۲۲ تصویر شفاف از طریق یک عملیات CPU شد که هزینه آن تنها چند سنت بود. سپس عامل ۴۶۱ شیء را برای آموزش، ۴۰ شیء را برای تست و ۱,۸۴۴ جفت تصویر «قبل و بعد از آموزش» را در ۲۳ دستور زاویه دوربین نهایی کرد. آموزش در ۹۰ دقیقه روی A100 با هزینه ۳.۷۵ دلار انجام شد. کل پروژه نیم روز زمان و ۴۸ عملیات اجرایی (شامل ارسال مجدد برای بستههای گمشده یا مسیرهای اشتباه) با هزینه ۱۶ دلار داشت.
به همین ترتیب، یک لورای «Doodle-in» برای جایگزینی خطخطیهای ارغوانی در عکسها با اشیاء واقعی ساخته شد، در حالی که نورپردازی و ترکیببندی حفظ شود. چون دادهای وجود نداشت، عامل فرآیند سفارشی زیر را اجرا کرد:
- شروع با یک عکس واقعی از Open Images.
- حذف شیء با استفاده از مدل Inpainting مدل LaMa.
- رسم یک خطخطی در جایی که شیء بود؛ در این حالت عکس اصلی تبدیل به هدف (Target) شد.
ML-Intern ابتدا اسکریپتهای ساخت جفت-داده را در یک Sandbox مبتنی بر CPU تست کرد و سپس عملیات GPU را اجرا کرد و نویسنده و لایسنس هر عکس منبع را ثبت نمود. این ابزار ۶,۰۴۲ جفت آموزشی و یک مجموعه تست ۱۶۰ تایی (شامل ۴۰ جفت از ۲۳ کلاس شیء که کاملاً از آموزش دور نگه داشته شده بودند) ساخت. پیش از آموزش، عملکرد مدل پایه و لورای Viggle turbo اندازهگیری شد. آموزش در ۱ ساعت و ۳۸ دقیقه روی A100 با هزینه ۴ دلار انجام شد. گام ۵۰۰ پس از مقایسه ۴۸ جفت تست انتخاب شد. در ترکیب با لورای Viggle turbo در ۶ گام، این مدل به نرخ تشخیص ۶۷.۵٪ با سرعت ۴.۷ ثانیه برای هر ویرایش رسید. کلاسهای دیده نشده نیز عملکرد مشابهی داشتند (۶۵.۰٪ در مقابل ۶۴.۲٪). این پروژه بیش از یک روز زمان و ۵۹ عملیات اجرایی با هزینه ۲۴.۳۰ دلار نیاز داشت.
بهینهسازی مبتنی بر مرورگر
آخرین پروژه روی Agate Preview 002 بود؛ یک مدل تبدیل متن به تصویر با ۲۶۰ میلیون پارامتر. این مدل به دلیل اندازه کوچک برای مرورگر مناسب بود، اما در ابتدا به ۵۰ گام با Guidance نیاز داشت (۱۰۰ پاس شبکه برای هر عکس). ML-Intern این مقدار را در دو مرحله به تنها ۴ پاس کاهش داد.
در مرحله اول، عامل ۱۵۵,۰۰۰ تصویر آموزشی را به عنوان Latent ذخیره کرد، Guidance را در مدل جاسازی کرد و گامها را روی A100 از ۱۶ به ۸ و سپس ۴ رساند. مدل شاگرد ۴ گامهای در بنچمارکهای GenEval و FID از مدل معلم (در ۴ گام) پیشی گرفت. این مرحله ۱۳ ساعت زمان و ۲۲ دلار هزینه داشت.
در مرحله دوم، ۲۴,۰۰۰ جفت تصویر دیگر با مدل معلم در ۱۶ گام ساخته شد و مدل شاگرد یک ساعت آموزش دید. امتیاز GenEval از ۰.۵۰۹ به ۰.۵۳۶ رسید (در حالی که مدل معلم در ۵۰ گام ۰.۵۶۳ بود)، در حالی که تنها یکچهارم محاسبات مصرف شد. در نهایت نسخه مرورگر از طریق ONNX صادر شد. هزینه این مرحله ۸ ساعت زمان و مجموعاً ۳۷ دلار بود.
تحلیل هزینهها
تمام هزینهها توسط مکانیزم درخواست بودجه عامل کنترل شد:
- دکتر مرکبات: ۱.۹۰ دلار (Qwen3.5-2B)
- لورای Huggy: ۷.۶۰ دلار (FLUX.2 klein base 4B)
- بازنویس جیبی: ۱۶.۰۵ دلار (Qwen3.5-0.8B and 2B)
- مدار دید: ۱۶.۰۰ دلار (Qwen-Image 2.1)
- لورای Doodle-in: ۲۴.۳۰ دلار (Qwen-Image 2.1)
- مدل Agate ۴ گامهای: ۳۷.۰۰ دلار (Agate Preview 002)
مجموع ۱۰۲.۸۵ دلار نشاندهنده تغییری بنیادین در توسعه هوش مصنوعی در مقیاس کوچک است. به جای اینکه یک مهندس هفتهها وقت خود را صرف پاکسازی دادهها و تنظیم ابرپارامترها کند، عامل تمام کارهای سخت و تکراری خط لوله یادگیری ماشین را بر عهده میگیرد. برای جلوگیری از خطاهای رایج در استقرار این مدلها، استفاده از استانداردهایی مانند «مانیفست انتشار» برای توقف فروپاشی سیستمهای AI در محیط تولید توصیه میشود تا نسخهبندی مدلها به درستی مدیریت شود.
این یعنی «سد ورود» برای ساخت مدلهای سفارشی دیگر تخصص فنی در PyTorch یا CUDA نیست، بلکه توانایی نوشتن یک پرامپت دقیق و ساختاریافته است. حیاتیترین بخشها اکنون «تست دود» برای تایید تغییر وزنها و «خط پایه» برای اندازهگیری پیشرفت واقعی است تا اطمینان حاصل شود که هزینه صرف شده واقعاً منجر به بهبود شده است.
برای کاربر معمولی، هوش مصنوعی از ابزاری که فقط «استفاده» میکند به ابزاری تبدیل میشود که «میسازد». دیگر نیازی نیست منتظر بمانید تا شرکتی نسخه کوچک یک مدل را منتشر کند؛ کافی است محدودیتها و رفتار مورد نظر را برای یک عامل توصیف کنید و چند دلار برای محاسبات بپردازید.
گام بعدی شما
- پرامپتهای دقیق این ۷ پروژه را در گیتهاب yvrjsharma/ml-intern-prompts بررسی کنید تا ساختار دستورات را یاد بگیرید.
- با تعریف یک بودجه بسیار کوچک (مثلاً ۵ دلار) و درخواست نمره خط پایه، اولین مدل تخصصی خود را آزمایش کنید.
- روی مدلهای زبانی کوچک (SLM) تمرکز کنید تا بتوانید کاربردهای محلی و آفلاین بسازید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو