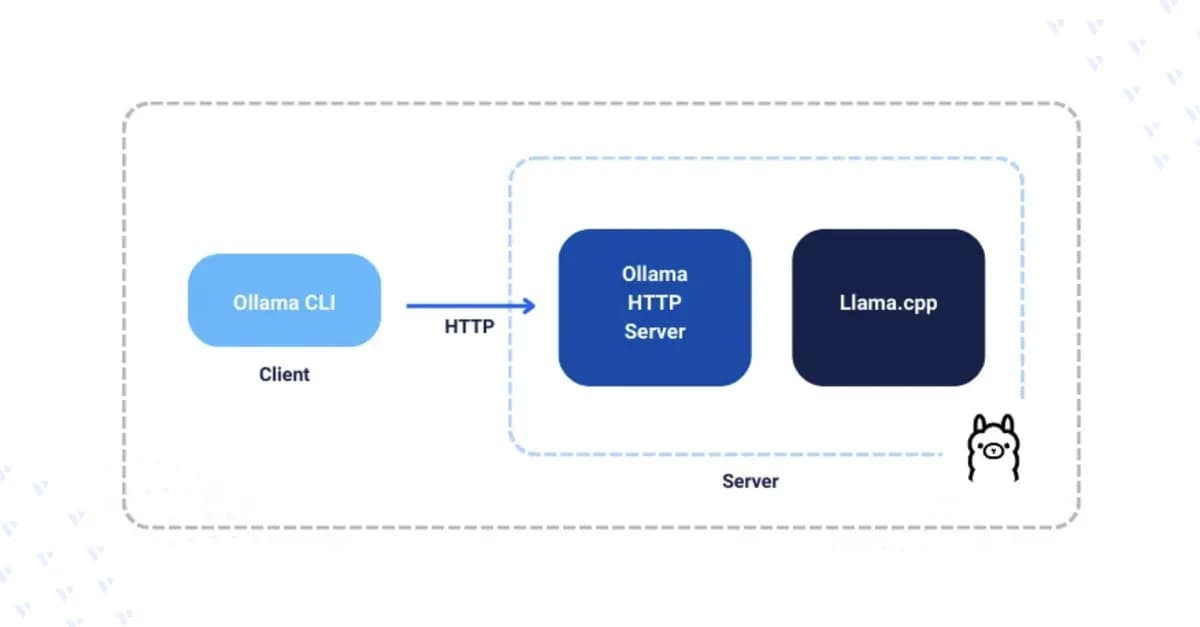
اگر امروز برای هر پاسخ ساده به یک مدل هوش مصنوعی، منتظر پاسخ سروری در آن سوی دنیا هستید، زمان آن رسیده که مدل را به خانه بیاورید. با استفاده از اولاما (Ollama)، استنتاج محلی (Local Inference) وابستگی به APIهای ابری را از بین میبرد و کنترل کامل عملکرد مدل و حریم خصوصی دادهها را در دستان کاربر قرار میدهد. با استفاده از این ابزار، شما دیگر نیازی به پرداخت هزینه توکن یا نگرانی درباره حریم خصوصی دادههایتان ندارید؛ رویکردی که در تحلیلهای پیشین ما درباره حذف هزینههای API از طریق اجرای محلی به طور مفصل بررسی شد.
در دنیایی که غولهای فناوری میلیاردها دلار روی مدلهای ابری سرمایهگذاری میکنند، نیاز به ابزاری است که این قدرت را به سطح دستگاه کاربر بیاورد. برای مثال، در حالی که صنعت شاهد سرمایهگذاریهای کلان برای تغییرات سیستمی است — مانند تلاش ۱.۰۳ میلیارد دلاری شرکت AMI Labs برای جایگزینی LLMهای استاندارد با مدلهای جهانی (World Models) — اکثر توسعهدهندگان همچنان به استدلالهای متنمحور متکی هستند. طبق گزارشهای منتشر شده تا ۲۴ ژوئیه ۲۰۲۶، اولاما با ارائه یک چارچوب یکپارچه، مسیر استقرار مدل زبانی بزرگ (LLM) — که شبیه کتابخانهداری است که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — را روی لینوکس، مک و ویندوز هموار کرده است. این رشد سریع ابزار اولاما با جذب سرمایههای کلان برای گسترش استنتاج مدلهای باز تسریع شده است تا دسترسی به مدلهای قدرتمند برای همگان ممکن شود. این ابزار با سادهسازی نصب مدلهای باز-وزنی (Open-weight)، شکاف بین تحقیقات سطح بالا و کاربردهای عملی روی دستگاه را پر میکند. همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن دیدیم، حذف واسطههای ابری و عدم نیاز به اتصال اینترنت، ریسک نشت دادهها و خطرات امنیتی مرتبط با پردازش دادهها توسط شخص ثالث را به شدت کاهش میدهد.
بر اساس مستندات فنی و راهنمای dev.to، فرآیند نصب بسته به سیستمعامل متفاوت است اما بسیار سریع و ساده طی میشود. کاربران لینوکس میتوانند با استفاده از اسکریپت رسمی از طریق دستور curl -fsSL https://ollama.com/install.sh | sh نرمافزار را نصب کنند. آنها میتوانند این نرمافزار را به عنوان یک سرویس systemd مدیریت کرده و با دستور sudo systemctl وضعیت سرویس را بررسی کنند، آن را برای اجرا در هنگام بوت فعال نمایند یا سرویس را ریاستارت کنند.
در macOS، کاربران باید بسته را از سایت ollama.com/download دانلود کرده، آن را از حالت فشرده خارج کنند و Ollama.app را به پوشه Applications منتقل نمایند. کاربران ویندوز نیز فایل .exe را از بخش دانلود ویندوز دریافت کرده و نصبکننده را اجرا میکنند. برای کسانی که از سختافزارهای خاص استفاده میکنند، اولاما پشتیبانی اختصاصی از ROCm برای واحد پردازش گرافیکی (GPU)های شرکت AMD از طریق یک بسته اختصاصی .tgz ارائه میدهد تا سرعت استنتاج (Inference) — یعنی همان لحظه تولید پاسخ توسط مدل — افزایش یابد.

مدیریت مدلها در این پلتفرم از طریق خط فرمان (CLI) انجام میشود و کاربر میتواند طیف گستردهای از مدلها را با دستورات ساده فراخوانی و اجرا کند. راهنمای فنی چندین گزینه کلیدی را برجسته میکند:
- Llama 3.3: مدلی قدرتمند که برای اجرا به حدود ۴۰ گیگابایت فضای دیسک نیاز دارد.
- DeepSeek R1: یک مدل استدلالی (Reasoning Model) — شبیه شطرنجبازی که چند حرکت جلوتر را میبیند — که با نمایش صریح بلوک
<think>، ردپای منطقی و روند تفکر خود را پیش از ارائه پاسخ نهایی افشا میکند. این مدل از طریق دستورollama run deepseek-r1:1.5bقابل دسترسی است. - Mistral، Phi-4 و Gemma 2: جایگزینهایی بهینه برای سختافزارهای با منابع محدود؛ برای مثال آخرین نسخه Mistral تنها حدود ۴.۱ گیگابایت فضا اشغال میکند.
برای مدیریت منابع، دستور ollama list لیست مدلهای موجود را نمایش میدهد و دستور ollama show به کاربر اجازه میدهد پارامترهای خاص، مجوزها (License) و طول زمینه (Context Length) هر مدل را بازرسی کند. همچنین برای آزادسازی فضای دیسک، کاربران میتوانند مدلهای اضافی را با دستور ollama rm حذف نمایند.
مدیران سیستم میتوانند محیط را با استفاده از متغیرهای محیطی خاص تنظیم کنند. این متغیرها شامل موارد زیر است:
- OLLAMA_HOST: آدرس باند سرور. تنظیم آن روی
0.0.0.0اجازه میدهد سایر میزبانهای شبکه به اولاما دسترسی داشته باشند. - OLLAMA_GPU_OVERHEAD: مقدار VRAM رزرو شده برای هر GPU که بر حسب بایت اندازهگیری میشود.
- OLLAMA_KEEP_ALIVE: کنترل میکند که مدل چه مدت در حافظه بارگذاری شده باقی بماند.
- OLLAMA_MODELS: تعریف یک دایرکتوری سفارشی برای ذخیرهسازی مدلها.
- OLLAMA_DEBUG: فعالسازی لاگهای مفصل برای عیبیابی (Troubleshooting).
- OLLAMA_FLASH_ATTENTION: ارائه بهینهسازیهای تجربی برای مکانیزم Attention.
- OLLAMA_NOPRUNE: نادیده گرفتن عملیات پاکسازی (Pruning) بلوکها در هنگام استارتآپ.
در لینوکس، این تنظیمات از طریق فایل یونیت systemd در مسیر /etc/systemd/system/ollama.service ویرایش میشوند. در macOS از launchctl setenv و در ویندوز از منوی System Variables استفاده میشود.
به نقل از راهنمای توسعهدهندگان، برای تبدیل این محیط متنی به یک رابط گرافیکی شبیه به چتباتی و تجربه بصریتر، توصیه میشود اولاما با Open WebUI ترکیب شود. این رویکرد، تغییر بزرگی در نحوه توسعه AI ایجاد میکند؛ به خصوص با ادغام اولاما در چارچوبهایی مانند Spring Boot که امکان ایجاد APIهای محلی را فراهم کرده و وابستگی به ابر را به شدت کاهش میدهد. توسعهدهندگان دیگر نیازی به بودجهبندی برای توکنهای غیرپیشبینیپذیر API ندارند و نگران تغییرات ناگهانی نسخههای مدل توسط ارائهدهندگان ابری نیستند. در این حالت، گلوگاه توسعه از لایسنسهای نرمافزاری به توان سختافزاری، بهویژه حافظه ویدیویی (VRAM) و سرعت دیسک منتقل میشود.
برای کاربر نهایی، این یعنی امکان مقایسه و بنچمارک مدلهای مختلف در یک سختافزار واحد؛ مثلاً سنجش عملکرد یک مدل ۱.۵ میلیارد پارامتری در برابر یک غول ۴۰ گیگابایتی برای یافتن نقطه تعادل بهینه بین کیفیت و سرعت برای یک وظیفه خاص.
گام بعدی شما
- فضای دیسک خود را برای وزنهای مدلهای بزرگ بررسی کنید تا از فضای کافی مطمئن شوید.
- با دستور
ollama listمنابع محلی خود را به طور کامل شناسایی و حسابرسی کنید. - برای کاربران پیشرفته: مجموعهای از پرامپتهای متنوع را با استفاده از اسکریپتنویسی در دستور
ollama runاجرا کنید تا یک خطکش عملکرد محلی (Baseline) برای سیستم خود بسازید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ برای درک اینکه چگونه VRAM تبدیل به ارز جدید دنیای AI شده، به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو