تصور کنید مدل زبانی کوچکی را که بهجای حل مسائل ریاضی، یاد گرفته است چگونه با ضربههای قلمموی نامنظم و لکههای رنگی، یک تابلوی آبرنگ خلق کند. این مدل نه با یادگیری پیکسلها، بلکه با یادگیری «سلیقه» و زیباییشناسی، هنر را بازتولید میکند.
در ۲۳ اوت ۲۰۲۴، ویدیویی از سوریا ناردی (Surya Narreddi) با بیش از ۱.۵ میلیون بازدید منتشر شد که در آن یک مدل زبانی کوچک (SLM) — شبیه به دستیاری که تخصصش در نوشتن دستورالعملهای دقیق است — با نوشتن کدهای جاوااسکریپت، نقاشیهای آبرنگی میکشید. این نمایش ثابت کرد که مدلها میتوانند وقتی بهجای دقت، برای «سلیقه» پاداش بگیرند، لمس ناقص و انسانی یک هنرمند را تقلید کنند. این موفقیت منجر به بازسازی این مسیر در فضای متنباز با استفاده از کتابخانههای TRL و OpenEnv شد تا این فرآیند از یک گزارش فنی خصوصی به یک خط لوله (Pipeline) کاملاً باز در Hugging Face تبدیل شود.
بیشتر مدلهای یادگیری تقویتی (Reinforcement Learning) — سیستمی شبیه به آموزش سگ با تشویقی برای انجام کارهای درست — روی حقایق قابل تایید متمرکز هستند؛ مثل مسائل ریاضی با یک پاسخ واحد، کدهایی که باید از تستهای سختگیرانه پاس شوند، یا ارزیابهایی که پاسخهای درست و غلط آنها مشخص و اجرایشان ارزان است. اما این پروژه منطق را برعکس میکند. سؤال اینجاست: آیا میتوان مدلی را بر اساس «سلیقه» آموزش داد، جایی که پاداش بهجای یک پاسخ باینری (درست یا غلط)، بر اساس یک ترجیح زیباییشناختی ذهنی باشد؟ این رویکرد به یادگیری تقویتی از بازخورد انسانی (RLHF) نزدیکتر است، جایی که مدلها از ترجیحات انسانی یاد میگیرند.
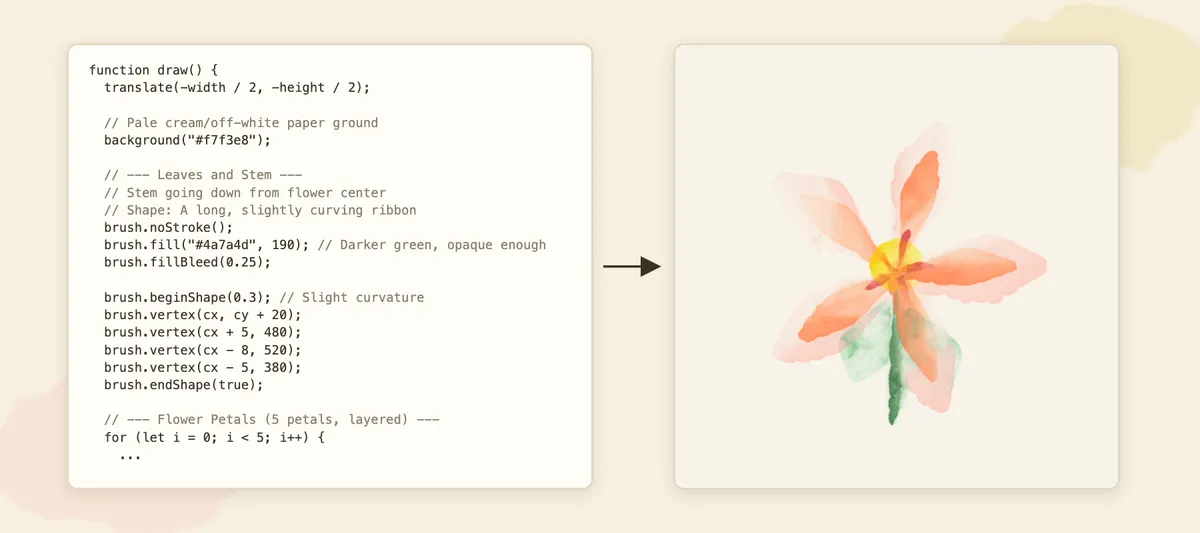
همانطور که در تحلیلهای پیشین ما دربارهی همراستاسازی مدلها اشاره کردیم، انتقال از پاداشهای سخت به پاداشهای نرم، کلید رسیدن به رفتارهای انسانیتر است. در این سیستم، مدل مستقیماً پیکسل تولید نمیکند. در عوض، مدل برنامهای حدود ۱۵۰ خطی به زبان جاوااسکریپت با استفاده از کتابخانه p5.brush مینویسد؛ کتابخانهای توسط @acamposuribe که ابزارهای طراحی طبیعی را به p5.js اضافه میکند. به این ترتیب، هوش مصنوعی تصمیم میگیرد رنگ چگونه در کاغذ پخش شود یا ضربات قلممو چگونه روی هم قرار بگیرند. در واقع خروجی یک کد قابل ویرایش است، نه یک تصویر ایستا. تصمیم پشت هر ضربه قلممو قابل مشاهده است و سبک هنری با محدود کردن مدل به تنها ۱۰ متد از ۴۷ متد موجود در کتابخانه، تحمیل میشود.
هنر در بستر ابزار
این نقاشیها در دورانی که مدلهای تصویری خروجیهایی بیش از حد کامل، صیقلخورده و از نظر آماری «متوسط» تولید میکنند، ظاهری دستساز و لرزان دارند. طبق گزارش ناردی، این تضاد دلیل ویروسی شدن ویدیو بود. این رویکرد یادآور روزهای اولیه هنر هوش مصنوعی است؛ مانند DeepDream در سال ۲۰۱۵ که ابتدا به عنوان ابزاری برای عیبیابی شروع شد، یا اثر Edmond de Belamy در سال ۲۰۱۸ که توسط هنرمندانی در حال کاوش در GANها خلق شد. این پروژه، مشابه آثار ماریو کلینگمن، در واقع کاوشی در خودِ مدیوم و ابزار است. این تلاش برای دستیابی به خروجیهای غیرمتعارف، مشابه رویکرد مدلهای متنباز مانند Pony Diffusion V6 XL است که آزادی عمل بیشتری را برای هنرمندان فراهم میکند تا از محدودیتهای مدلهای تجاری فاصله بگیرند.
سوریا در پایاننامه خود، تکامل این رویکرد را شرح میدهد. او ابتدا با مدلهای متن-به-تصویر شروع کرد، جایی که «پرامپت» تنها اهرم کنترل بود. اما آموزش دادن خودِ مدل، اجازه نفوذ و تأثیر عمیقتری را میدهد. با خروجی گرفتن به صورت کد، فرآیند مدل شفاف میشود. محدودیت به ۱۰ متد خاص مانع از آن میشود که مدل از خطوط صاف یا هاشور زدن استفاده کند، زیرا این کار زیباییشناسی آبرنگ را از بین میبرد.
مکانیسمهای مدیوم
ابزار p5.brush بهجای رسم اشکال هندسی، یک مدیوم هنری را شبیهسازی میکند. رنگ از لبههای شکل بیرون میزند، کاغذ بافت دارد و میدانهای جریان (flow fields)، ضربات قلممو را به اطراف میکشند. وقتی مدل دستور brush.fillBleed(0.25) را فراخوانی میکند، در واقع دارد تصمیم میگیرد که جوهر دقیقاً تا کجا روی کاغذ پخش شود.
این رویکرد به تاریخچه طولانیتری از آموزش ماشینها برای نقاشی متصل است. در سال ۲۰۲۲، @acamposuribe مجموعهای از هنرهای زاینده را بر اساس خاطراتی درباره آموزش p5.js برای کشیدن شبیه به یک کودک خلق کرد. در آن خاطرات، از استیصال ماشینی گفته شده بود که بهسختی میتواند از مداد شمعی استفاده کند و قادر به دنبال کردن دستورات ساده نیست. سوریا اشاره کرد که پروژه فعلی در واقع «قطعه سوم» از آن مجموعه است که حالا به طور مستقل به ثمر رسیده است.
موتور پاداش: کمیسازی زیبایی
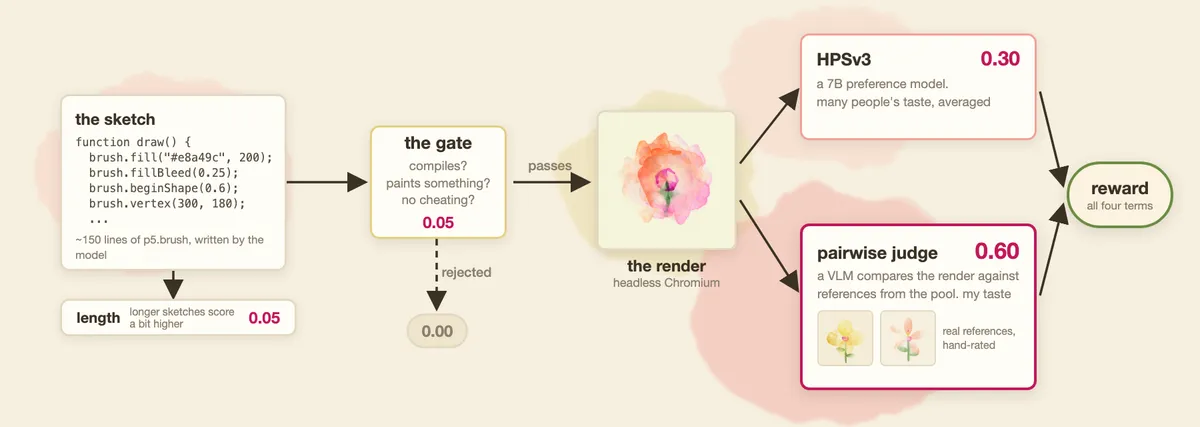
قلب این پروژه، یک تابع پاداش است که بهعنوان نمایندهای از سلیقه انسانی عمل میکند. بر اساس مستندات پروژه، این پاداش به چهار بخش مجزا تقسیم شده است که ناردی پس از آزمایشهای مختلف روی وزنهای آنها به توافق رسید:
- دروازه (۰.۰۵): یک بررسی باینری برای اطمینان از اینکه کد کامپایل میشود، چیزی روی بوم میکشد، از کتابخانه p5.brush بهجای فراخوانیهای مستقیم p5 استفاده میکند و برای فریب دادن سیستم (مثلاً نوشتن متن روی بوم برای گول زدن داور) تقلب نمیکند.
- طول کد (۰.۰۵): یک فشار نرم به سمت نوشتن قطعه کدهای طولانیتر برای تشویق مدل به ایجاد جزئیات بیشتر.
- داور جفتساز (۰.۶۰): یک مدل بینایی-زبانی (Qwen3-VL-30B-A3B-Instruct) که از طریق ارائهدهندگان استنتاج HF فراخوانی میشود. این مدل، نقاشی کاندید را با چهار نمونه مرجع که بهطور تصادفی از یک مجموعه انتخاب شدهاند مقایسه میکند. این مقایسه بر اساس توصیفاتی از لکههای رنگ، شستهای شفاف و لبههای نرم انجام میشود. امتیاز نهایی، سهم پیروزیهای کاندید در این مقایسههاست.
- HPSv3 (۰.۳۰): یک مدل ترجیحی ۷ میلیارد پارامتری و متنباز. این مدل یک تصویر و توصیف متنی را میگیرد و امتیازی بر اساس ترجیحات جمعیت عمومی انسانها بازمیگرداند (آموزش دیده بر روی مجموعه بزرگی از انتخابهای انسانی).
ساخت مجموعه مرجع
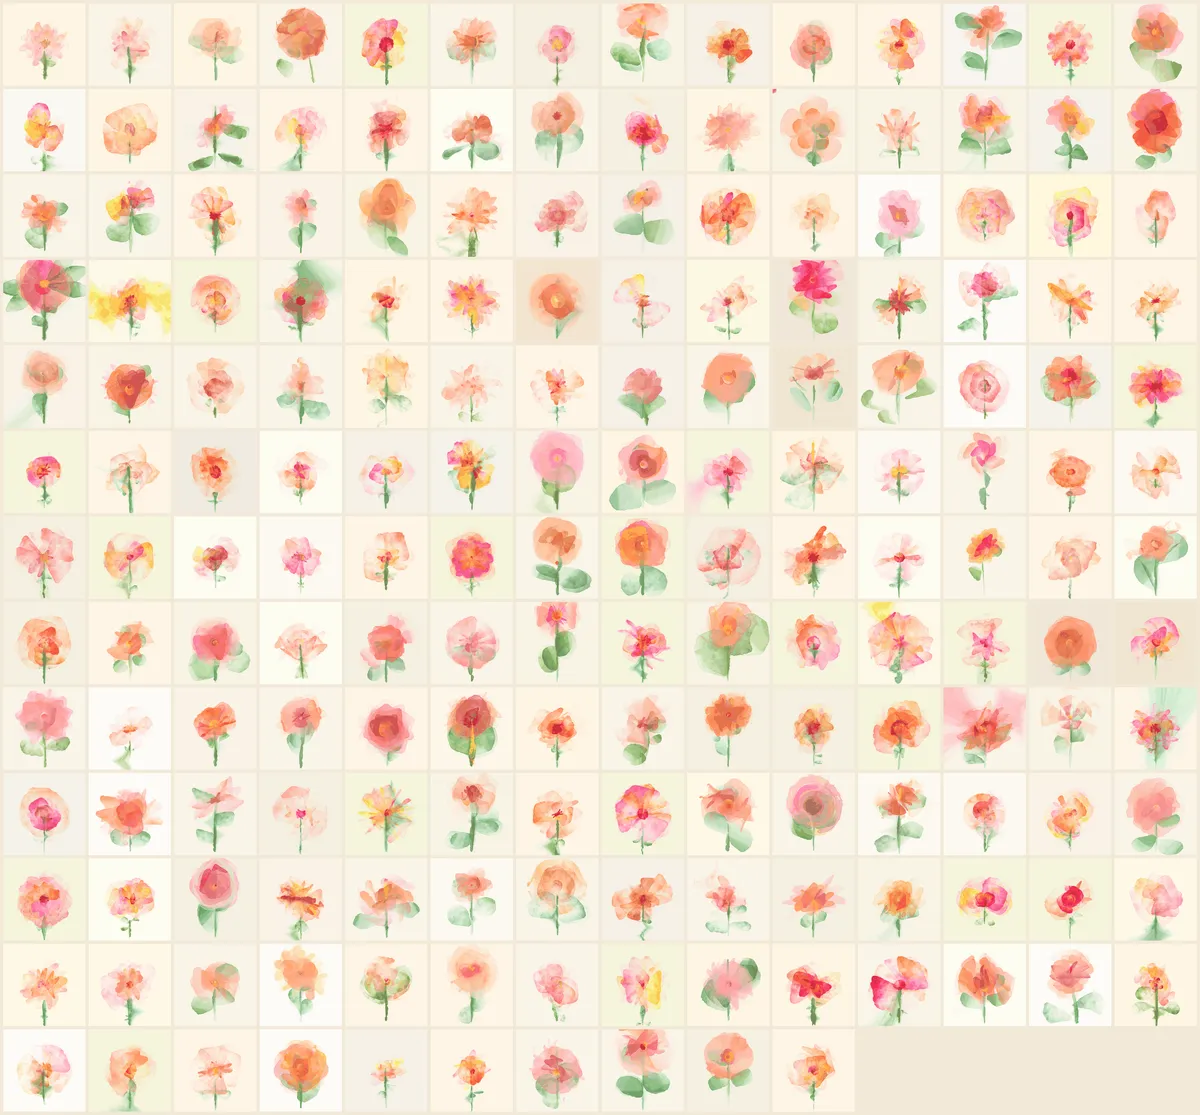
سلیقه مدل کاملاً توسط «مجموعه مرجع» تعریف میشود. نویسنده ۱۷۸ نقاشی را دستچین کرد و آنها را بر اساس ترجیحات شخصی به دو سطح «عالی» (love) و «متوسط» (okay) تقسیم نمود. این مراجع توسط چهار خانواده مختلف از مدلهای با وزنهای باز تولید شده بودند که از یک بررسی قابلیت اطمینان عبور کرده بودند. هر طرح بر اساس عکسهای واقعی و دارای لایسنس باز از گلهای ختمی در وبسایت iNaturalist ساخته شد و طی سه تکرار تحت نظارت یک منتقد بینایی اصلاح گردید.
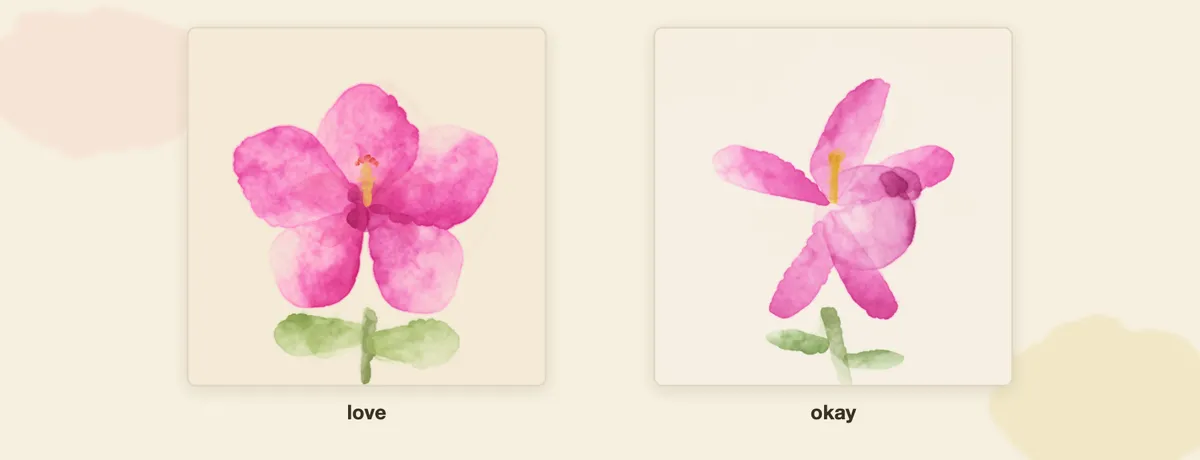
با مقایسه تلاشهای جدید با این مجموعه، داور جفتساز مدل را به سمت یک سبک هنری خاص هدایت میکند. نویسنده یک تغییر عمدی در دستورالعمل اصلی ایجاد کرد: داور مراجع را از هر دو سطح (نیمی عالی و نیمی متوسط) انتخاب میکند. این کار تضمین میکند که حتی یک مدل ضعیف در ابتدای آموزش، با شکست دادن سطح «متوسط»، سیگنال پاداش دریافت کند؛ در حالی که در نسخه اصلی، مقایسه فقط با سطح برتر انجام میشد.
اگر این مجموعه مرجع به حیوانات یا هنر انتزاعی تغییر میکرد، «سلیقه» مدل بهطور خودکار بدون تغییر حتی یک خط از کد آموزش، تغییر میکرد. این رویکرد مشابه کار آنا ریدلر (Anna Ridler) است که هزاران عکس لاله را گرفت و دستی برچسب زد تا مدلی را آموزش دهد و سپس خودِ مجموعه داده را به عنوان اثر هنری به نمایش گذاشت.
پیادهسازی فنی و موانع
این خط لوله بهطور کامل روی Hugging Face اجرا میشود. آموزش روی HF Jobs انجام میشود، در حالی که محیط RL و مدل امتیازدهنده به عنوان Spaces اجرا میشوند. تمام مصنوعات در یک مجموعه در Hub جمعآوری شدهاند. مدل پایه مورد استفاده Qwen/Qwen3.5-35B-A3B بود.
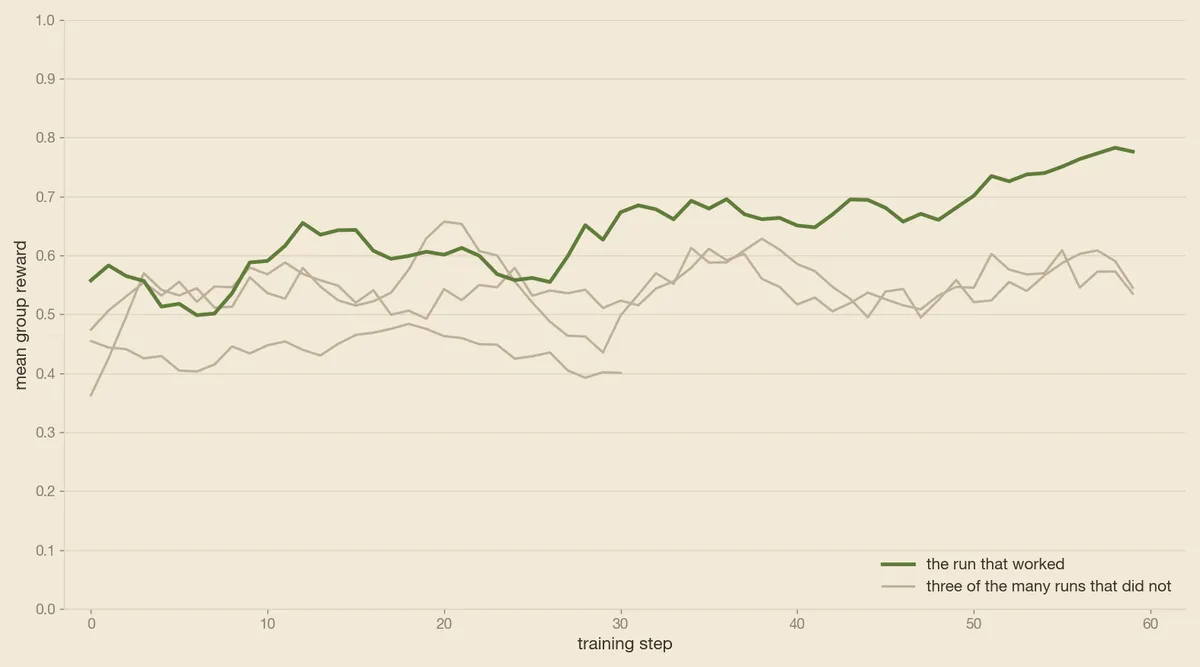
آموزش در ابتدا فوری نبود. اجراهای اولیه منحنیهای پاداش تخت (بدون رشد) را نشان میدادند. نویسنده متوجه شد که لیست معمول target_modules برای LoRA فرض میکند مدل متراکم (Dense) است، اما Qwen3.5-35B-A3B یک مدل ترکیب خبرهها (MoE) با نامهای پروژکشن متفاوت است. این یعنی آداپتور تنها ۱۰ لایه از ۴۰ لایه را آموزش میداد.
برای حل این مشکل و باز کردن قفل یادگیری، چهار تغییر حیاتی در GRPOTrainer در TRL اعمال شد:
- نرخ یادگیری: افزایش از 2e-5 به 5e-5.
- زمانبند نرخ یادگیری: تغییر از
linearبهconstant_with_warmupزیرا کاهش خطی باعث شده بود بیشتر نرخ یادگیری تا اواسط اجرا مصرف شود. - مقیاس پاداش: تنظیم روی
noneزیرا رد شدنها در مرحله دروازه، هر مزیت دیگری را در گروه خنثی میکرد. - ماژولهای هدف: تغییر به
all-linearبرای دسترسی به تمام لایههای خطی در معماری MoE.
پرامپتنویسی و GEPA
پرامپت سیستمی مدل را به ۱۰ متد خاص محدود میکند: scaleBrushes ،noStroke ،fill ،noFill ،fillBleed ،fillTexture ،beginShape ،vertex ،endShape و circle. استفاده از یک مرجع API طولانی اغلب باعث میشد مدل متدهای خیالی ابداع کند. برای حل این مشکل، پروژه اصلی از GEPA (یک بهینهساز خودکار پرامپت) برای ۲۰۰ تکرار استفاده کرد تا به یک لیست مجاز سختگیرانه بدون مستندات برسد.
نویسنده یک دستور ظریف هنری به این دستورالعمل اضافه کرد: «هر گلبرگ را دو یا سه بار رنگ کن؛ اول یک لایه بزرگ و بعد یک لایه کوچکتر و ماتتر در داخل آن». این تغییر کوچک منجر به خروجیهایی بهشدت رنگارنگتر شد.
مقایسه ترکیبهای پاداش
نویسنده سه پیکربندی مختلف پاداش را آزمایش کرد تا ببیند مدل چه مقدار «سلیقه شخصی» را میتواند تحمل کند و آنها را بهطور موازی تکامل داد:
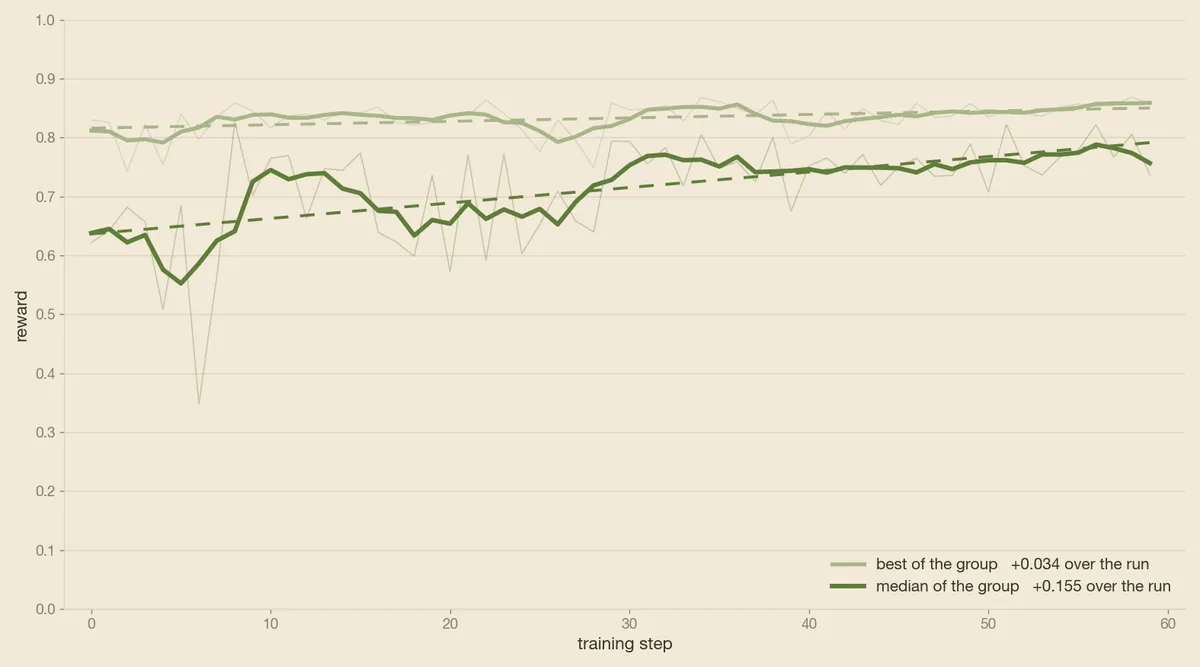
- فقط HPS (اجرای اعتبارسنجی): وزن ۰.۰۰ برای داور / ۰.۹۰ برای HPSv3. در گام ۶۰ متوقف شد. این اجرا تایید کرد که خط لوله قادر به یادگیری است. مدل دیگر بومهای خالی نمیکشید، اما کیفیت نقاشیهای خوب تنها ۰.۰۳+ رشد کرد.
- محور HPS (نقطه میانی): وزن ۰.۳۰ برای داور / ۰.۶۰ برای HPSv3. در گام ۱۱۰ متوقف شد. این حالت آبرنگهای متقاعدکنندهای با ظاهر نرم و «تر-روی-تر» تولید کرد.
- محور داور (ترکیب اصلی): وزن ۰.۶۰ برای داور / ۰.۳۰ برای HPSv3. در گام ۱۱۰ متوقف شد. این ترکیب منجر به متنوعترین و از نظر هنری جذابترین خروجیها شد.
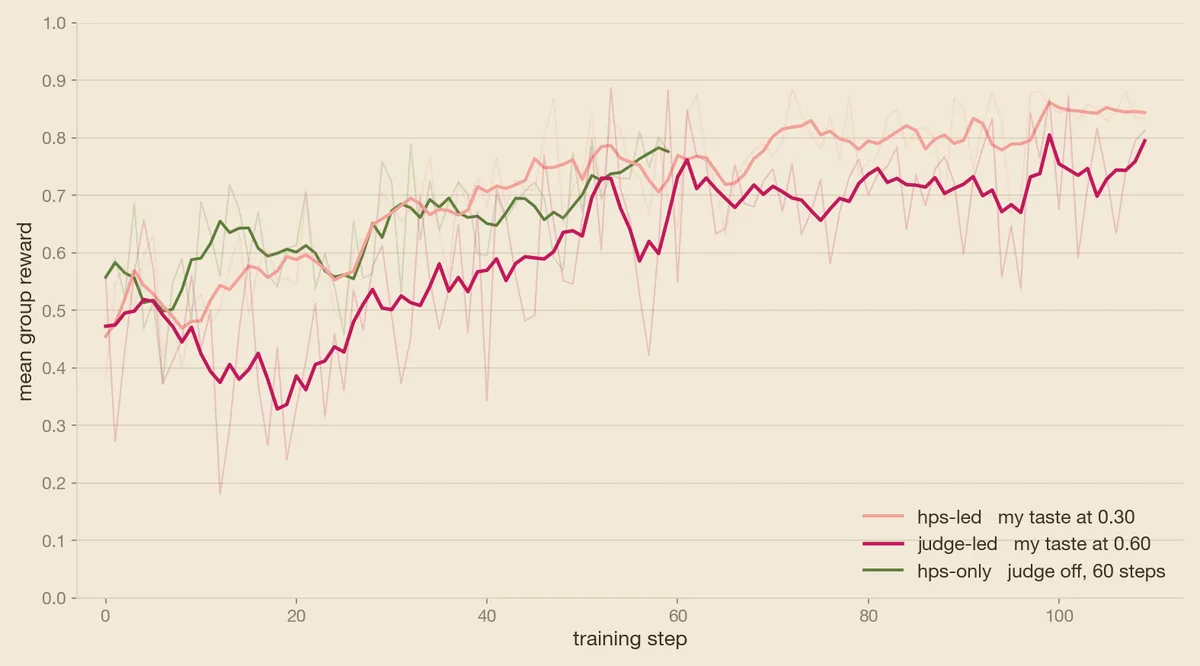
دادهها نشان میدهد که اجرای محور داور بیشترین رشد را داشت و میانگین پاداش گروه در ۱۱۰ گام، ۰.۲۷+ افزایش یافت (از ۰.۴۵ به ۰.۷۲). در مقابل، حالت فقط HPS از ۰.۵۸ به ۰.۷۱ رسید. مهمتر از آن، پوشش رنگ در اجراهای محور داور دو برابر شد (از ۰.۱۱ به ۰.۲۳ برای محور داور و ۰.۱۳ به ۰.۳۰ برای محور HPS)، که ثابت میکند مدل یاد گرفته است برای ارضای سلیقه داور، از رنگ بیشتری استفاده کند.
هزینه زیرساختی
ساخت این سیستم نیازمند یک پشته زیرساختی پیچیده بود. یک اجرای آموزشی به موارد زیر نیاز داشت:
- آموزشدهنده (Trainer): یک GPU H200. ۱۸ ساعت برای ۶۰ گام و حدود ۳۴ ساعت برای ۱۱۰ گام.
- HPSv3: یک Space با A100-large که در تمام طول اجرا فعال بود.
- محیط (Environment): یک Space با CPU ارتقایافته برای رندرینگ بدون سر (headless) در کرومیوم.
- داور جفتساز: سهمیه Inference Providers برای مدل Qwen/Qwen3-VL-30B-A3B-Instruct.
رندرینگ گلوگاه اصلی بود و ۷۰ تا ۸۰ درصد از کل زمان هر گام را میگرفت. هر رندر بین ۶۹ تا ۹۶ ثانیه زمان میبرد در حالی که ضربالاجل ۹۰ ثانیه بود. چون Space فاقد GPU است، کرومیوم بوم WEBGL را بهصورت نرمافزاری رندر میکند و افکتهای پخش رنگ و بافت در p5.brush عملیات سنگینی روی پیکسلها هستند.
شکستهای زیرساختی اغلب به عنوان امتیاز صفر وارد سیستم میشدند. یک رندر تایم-اوت شده یا شکست خاموش داور، همان امتیاز یک نقاشی بد (۰.۰) را میگرفت. این موضوع حدود ۱.۵٪ از اجراها (و در بدترین حالت تا ۵.۲٪) را تحت تاثیر قرار داد. نویسنده این مشکل را با اطمینان از اینکه این مسیرها مقدار None برگردانند حل کرد تا آن اجرا از گروه حذف شود. همچنین یک باگ در OpenEnv مربوط به وبساکتهای کششده پیدا شد و برای اصلاح به توسعهدهندگان ارسال گردید.
تحلیل: از «ساختن» به «تشخیص دادن»
این پروژه نشاندهنده تغییری در گلوگاههای هوش مصنوعی زاینده است. وقتی مدل از پیش توانایی نوشتن کد لازم را دارد، ارزش از «توانایی ساخت» به «توانایی تشخیص» — یعنی کیوریتوری و دستچین کردن مجموعه پاداش — منتقل میشود. این تمرکز بر بهینهسازی فرآیند تولید و کاهش خطاها، مشابه رویکرد مهندسی محدودیت در Veridian Resonance است که توانست دفعات بازبینی را بهشدت کاهش دهد.
با استفاده از یادگیری تقویتی بر اساس سلیقه، ما از کمال «میانگین آماری» مدلهای دیفیوژن فاصله میگیریم. هنر حاصله به این دلیل دستساز به نظر میرسد که مدل آموزش دیده است تا یک مجموعه منتخب از «نقصها» را تقلید کند. مدل حتی یاد گرفت دستور پرامپت سیستمی برای استفاده از ۱۵ تا ۳۰ شکل رنگشده را نادیده بگیرد (میانگین واقعی ۷ تا ۹ شکل بود)، زیرا برای اطاعت از آن جمله خاص پاداشی دریافت نمیکرد.
گامهای بعدی
نویسنده چندین مسیر برای کاوشهای آینده پیشنهاد میکند:
- بازخورد چندمرحلهای: اجازه دادن به مدل برای «دیدن» نقاشی خود و تکرار آن. مجموعه مرجع با یک حلقه ۳ مرحلهای ساخته شده بود؛ مدل هم باید چنین حلقهای داشته باشد.
- مدلهای کوچکتر: شواهد نشان میدهد مدلهای ۴ میلیارد پارامتری میتوانند کدهای معتبر بنویسند که هزینهها را تا یک مرتبه بزرگی کاهش میدهد.
- SFT: انجام تنظیم نظارتشده (Supervised Fine-Tuning) روی منابع مجموعه مرجع پیش از شروع RL.
- پاداشهای پویا: تغییر ترکیب مراجع داور از «آسان» به «سخت» با پیشرفت مراحل آموزش.
- گسترش لیست مجاز: افزایش محدودیت ۱۰ متدی، هرچند تلاشهای اولیه باعث کرش کردن بیشتر کدها و تخریب ظاهر آبرنگی شد.
- بررسیهای سازگاری: امتیازدهی دو باره به یک تصویر برای تایید قابلیت اطمینان داور جفتساز.
شما میتوانید دستورالعمل کامل متنباز، شامل مجموعه دستچین شده و اسکریپتهای آموزش را در Hugging Face Hub بررسی کنید.
گام بعدی شما
- بررسی مجموعه دادههای دستچین شده و اسکریپتهای آموزش در Hugging Face Hub برای درک نحوه تعریف «سلیقه».
- آزمایش مدلهای کوچکتر (مثلاً ۴ میلیارد پارامتری) برای کاهش هزینههای استنتاج در پروژههای مشابه.
- مطالعه درباره ترکیب SFT (تنظیم نظارتشده) پیش از شروع یادگیری تقویتی برای تسریع همگرایی مدل.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو