تصور کنید دو مدل بازشناسی گفتار نمرات کلی تقریباً یکسانی دارند، اما یکی از آنها بسته به منطقه جغرافیایی گوینده، چهار برابر ضعیفتر عمل میکند. این واقعیت در ۲۸ اوت ۲۰۲۶ فاش شد؛ زمانی که Hugging Face و Voice Arena مجموعههای ارزیابی Monsoon را منتشر کردند تا ثابت کنند یک عدد واحد برای نرخ خطای کلمه (Word Error Rate - WER) درباره کیفیت واقعی مدلها به شما دروغ میگوید.
بیشتر محکهای بازشناسی گفتار (ASR) از دادههای صوتی در دسترس و راحت ساخته شدهاند که منجر به ایجاد نقاط کور خطرناکی میشود. وقتی یک جدول ردهبندی تنها یک عدد میانگین را گزارش میکند، تفاوتهای نژادی، جنسیتی و لهجهای را پنهان میکند که باعث میشود جمعیتهای خاصی از خدمات مدلها محروم بمانند. پژوهشها درباره نابرابریهای نژادی در ASR نشان دادهاند که سیستمهای تجاری برای گویندگان سیاهپوست تقریباً دو برابر ضعیفتر از گویندگان سفیدپوست عمل میکنند. مطالعات دیگر در زمینه کمیسازی سوگیری، تفاوتهای بیشتری را بر اساس سن، جنسیت و لهجه شناسایی کردهاند.
همانطور که در تحلیلهای پیشین ما درباره سوگیری در مدلهای زبانی اشاره کردیم، این پدیده «برازش بر روی بنچمارک» (Benchmark-fitting) اغلب به مدلهایی پاداش میدهد که صرفاً متنهای مرجع را بازتولید میکنند، نه مدلهایی که واقعاً سیگنالهای صوتی متنوع را درک میکنند. این چالش نشان میدهد که چرا تکیه بر معیارهای استاندارد کافی نیست و استفاده از محکهای داخلی برای ارزیابی دقیقتر مدلها در محیطهای عملیاتی به یک ضرورت تبدیل شده است. برای اینکه معیارها قابلاعتمادتر شوند، کارهای اخیر در Open ASR Leaderboard بر بخشهای خصوصی (held-out private splits)، تحلیل برازش بنچمارک و بستن شکافها در نرمالسازها (normalisers) متمرکز شده است تا اطمینان حاصل شود که گونههای صحیح متن جریمه نمیشوند. با این حال، خروجی نهایی همچنان یک عدد تکبعدی است.
برای شکستن این چرخه، ابتکار Monsoon دو مجموعه ارزیابی جدید معرفی کرده است: Monsoon en-IN (انگلیسی هندی) و Monsoon hi-IN (هندی). این نخستین بار است که یک زبان هندی به بخش چندزبانه Open ASR Leaderboard اضافه میشود؛ بخشی که پیش از این تنها زبانهای اروپایی را پوشش میداد.
معماری واریانس
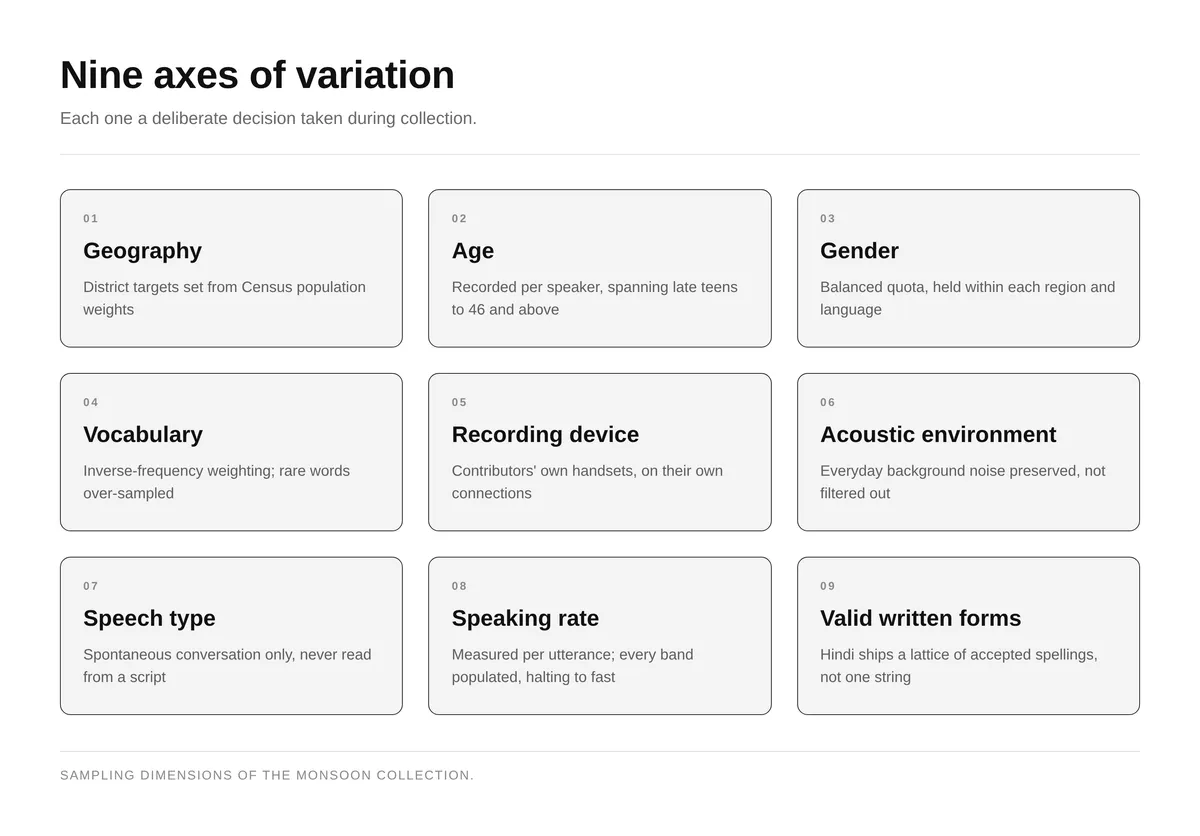
برخلاف مجموعهدادههای سنتی، Monsoon روی ۹ محور خاص مهندسی شده است تا نقاط شکست مدلها را آشکار کند. یک مجموعه تست تنها میتواند نقاط شکستی را فاش کند که در طول آنها تغییر (vary) داشته باشد؛ بنابراین، Monsoon بهگونهای ساخته شده است تا تضمین کند یک WER کلی نمیتواند در میانگین درست باشد اما برای یک جمعیت خاص اشتباه عمل کند:
- جغرافیا: جذب شرکتکنندگان از صدها منطقه مختلف بهجای ضبط جلسات طولانی در مکانهای کمتر، تا از بیشبرازش منطقهای جلوگیری شود.
- آکوستیک: مشارکتکنندگان از گوشیهای شخصی و اتصالات خود در محیطهای واقعی داخلی و خارجی استفاده کردند، بهجای استفاده از سختافزارهای تامینشده در یک اتاق ساکت.
- دموگرافی: ثبت و تایید دادههای سن و جنسیت برای هر گوینده.
- دینامیک گفتار: پرامپتها بر موضوعات روزمره متمرکز بودند—شامل سفر، مراقبتهای بهداشتی، کشاورزی، آموزش و خدمات دیجیتال—تا مشارکتکنندگان را به سمت بیان عقیده، مخالفت، روایت و یادآوری سوق دهند. این امر باعث تحریک عبارتبندیهای بدون تمرین و استفاده از موجودیتهای نامدار میشود.
- تنوع فنی: طیف گستردهای از مدلهای دستگاه و شرایط ضبط.
- واژگان: پرامپتها بهگونهای طراحی شدند تا اعداد و موجودیتهای نامدار خاص را استخراج کنند.
- سرعت گفتار: ایجاد تنوع در سرعت صحبت کردن گویندگان.
- نوع گفتار: تمرکز بر گفتار خودبهخودی و مکالمهای بهجای خواندن متن.
- اعتبار متن: پذیرش وجود چندین متن معتبر برای یک فایل صوتی واحد.
ترکیب و مقیاس دادهها
این مجموعه شامل چهار بخش (عمومی و خصوصی برای هر دو زبان) است که از مکالمات خودبهخودی دوکاناله و بدون متن (unscripted) استخراج شدهاند. کلیپها از یک کانال مجزا برش داده شدهاند تا هر کلیپ تنها شامل یک گوینده باشد.
- Monsoon en-IN (عمومی): ۵.۶۲ ساعت صوت از ۱٬۴۴۴ گوینده در ۴۲۸ منطقه در ۲۴ ایالت و ۶ قلمرو اتحادیه. میانگین طول کلیپ ۹.۶ ثانیه (میانه ۱۰.۴ ثانیه) است. توزیع جنسیتی ۵۰/۵۰ است و از ۵۵۶ دستگاه متمایز استفاده شده است. سبک آن مکالمهای و خودبهخودی است و متنهای نرمالشده شامل لغزشهای گفتاری (disfluencies) هستند.
- Monsoon en-IN (خصوصی): ۵.۵۸ ساعت صوت از ۱٬۴۰۵ گوینده در ۴۲۰ منطقه. توزیع جنسیتی ۴۵/۵۵ است و از ۵۶۰ دستگاه متمایز استفاده شده است. سبک آن مکالمهای و خودبهخودی با متنهای نرمالشده شامل لغزشهای گفتاری است.
- Monsoon hi-IN (عمومی): ۱.۳۳ ساعت صوت از ۴۶۸ گوینده در ۲۰۲ منطقه در ۱۱ ایالت و ۳ قلمرو اتحادیه. میانگین طول کلیپ ۶.۴ ثانیه (میانه ۵.۰ ثانیه) است. توزیع جنسیتی ۵۴/۴۶ است و از ۳۱۵ دستگاه متمایز استفاده شده است. سبک آن مکالمهای و خودبهخودی است که از شبکهای (lattice) از گونههای ارتوگرافیک پذیرفتهشده استفاده میکند.
- Monsoon hi-IN (خصوصی): ۴.۴۷ ساعت صوت از ۱٬۵۷۱ گوینده در ۲۹۵ منطقه در ۱۲ ایالت و ۳ قلمرو اتحادیه. میانگین طول کلیپ ۶.۶ ثانیه (میانه ۵.۳ ثانیه) است. توزیع جنسیتی ۵۵/۴۵ است و از ۵۸۲ دستگاه متمایز استفاده شده است. سبک آن مکالمهای و خودبهخودی با استفاده از شبکه گونههای ارتوگرافیک است.
برای جلوگیری از اثرگذاری بیش از حد چند گوینده پرکار بر نتایج، تیم یک سقف زمانی برای هر گوینده پیادهسازی کرد که با اندازه جمعیت و توزیع جغرافیایی تنظیم شده بود. در نتیجه، بیش از نیمی از گویندگان در این مجموعهها دقیقاً یک قطعه صوتی ارائه دادهاند. این تضمین میکند که نمره نهایی میانگین صدها صدای متمایز است، نه نتیجه چند ضبط طولانی. در مجموعه عمومی هندی، میانگین قطعات به ازای هر گوینده ۱.۶۱ و در مجموعه انگلیسی هندی ۱.۴۶ است.
متادیتای عمیق و پوشش گویندگان
هر قطعه صوتی در Monsoon دارای ۱۸ ستون داده است که ۱۲ مورد آن متادیتای دموگرافیک است. در حالی که بیشتر مجموعههای عمومی ASR تنها یک شناسه، متن و مدت زمان ارائه میدهند، Monsoon یک پروفایل دموگرافیک جامع برای هر کلیپ فراهم میکند:
- اطلاعات گوینده: شناسه (ID)، جنسیت و تاریخ تولد.
- پسزمینه: شغل، پیشینه تحصیلی، وضعیت تاهل و بازه درآمدی.
- جغرافیا: منطقه بومی، ایالت بومی، شهر فعلی و سالهای اقامت در منطقه فعلی.
- سختافزار ضبط: سازنده دستگاه و مدل دقیق دستگاه.
به عنوان مثال، در بخش عمومی انگلیسی هندی، پروفایلهای متنوعی دیده میشود: یک دانشجوی زن ۲۹ ساله از غرب تریپورا که از سامسونگ SM-G781B استفاده میکند، یک زن بیکار ۳۲ ساله از ساتنا در مادیا پرادش با سامسونگ SM-E146B، یک دانشجوی مرد ۲۲ ساله از روهتاس در بیهار با موتورولا Moto G54 5G، یک زن بیکار ۲۷ ساله از وارنگال در تلانگانا با ویوو V2247، و مردی ۵۷ ساله با شغل خصوصی از پودوچری که از شیائومی M2006C3LI استفاده میکند.
این تنوع تضمین میکند که هیچ عامل واحدی نمره را به تنهایی تعیین نکند. ده مشارکتکننده بزرگ تنها ۲.۸٪ تا ۶.۸٪ از کل مدت زمان را تشکیل میدهند. هیچ مدل دستگاهی بیش از ۲.۱٪ از قطعات را در هیچیک از زیرمجموعهها تشکیل نمیدهد تا از بیشبرازش مدل روی پاسخ میکروفون خاصی جلوگیری شود. مجموعه انگلیسی هندی تنها یک لهجه نیست، بلکه تمام ۶ منطقه هند را نمایندگی میکند. در مجموعه عمومی، ۳۵٪ قطعات از گویندگان جنوبی، ۱۸٪ از شرق، ۱۸٪ از مرکز، ۱۶٪ از شمال و ۱۱٪ از غرب هستند.
افشای توهم میانگین
به نقل از گزارش Hugging Face، این متادیتای غنی تحلیلی را ممکن میکند که پیش از این در جدولهای ردهبندی عمومی غیرممکن بود. در یک تست روی بخش عمومی انگلیسی هندی، ۸ مدل مختلف نمراتی بین ۴.۸۱ تا ۴.۹۹ در WER کسب کردند—تفاوتی تنها ۰.۱۸ امتیازی. در نگاه اول روی کل مجموعه، این مدلها یکسان به نظر میرسند.
اما وقتی دادهها بر اساس شوراهای منطقهای (گروهبندی ایالتهای هند توسط وزارت کشور) دستهبندی شدند، داستان تغییر کرد. مدل openai/whisper-large-v3-turbo تفاوت ۰.۴۶ امتیازی بین مناطق داشت. اما مدل mistralai/Voxtral-Mini-3B-2507، که در کل مجموعه تنها ۰.۱۴ امتیاز عقب بود، تفاوت شدیدی تا ۱.۶۸ امتیاز نشان داد؛ بهطوری که در منطقه مرکزی ۴.۳۸ و در شرق ۶.۰۶ بود.
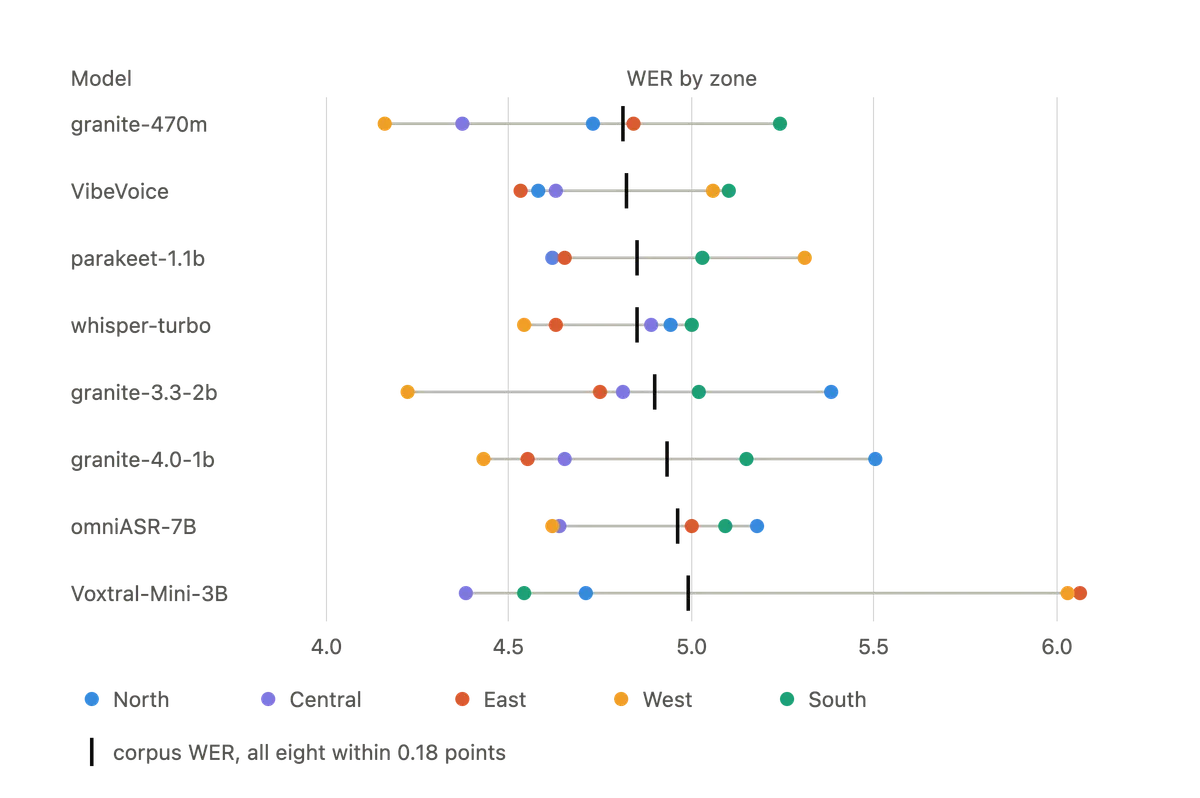
این دادهها ثابت میکنند دو سیستم که در یک بنچمارک استاندارد غیرقابل تشخیصاند، در نحوه برخورد با منشأ گوینده بنیاداً متفاوتاند. همچنین مشخص شد هیچ منطقهای بهطور مطلق «سخت» نیست، بلکه هر مدل در منطقه خاصی شکست میخورد. برای مثال، ibm-granite/granite-speech-3.3-2b در شمال ضعیفترین عملکرد را داشت، در حالی که microsoft/VibeVoice-ASR-HF در جنوب بیشترین مشکل را داشت.
حل چالش رسمالخط هندی
تفاوتهای املایی در انگلیسی نسبتاً محدود است (مثلاً بریتانیایی در مقابل آمریکایی) و میتوان آن را با یک نرمالساز مدیریت کرد. اما زبان هندی متفاوت است؛ این زبان بهشدت با انگلیسی ترکیب شده (Code-mixed) و کلمات با منشأ انگلیسی اغلب هیچ املای تثبیتشدهای در رسمالخط دیواناگری ندارند. فرمهای ترکیبی ممکن است بر اساس ترجیح نویسنده بهصورت متصل یا جدا نوشته شوند. یک عبارت واحد میتواند ۱۰ یا بیشتر شکل نوشتاری معتبر داشته باشد.
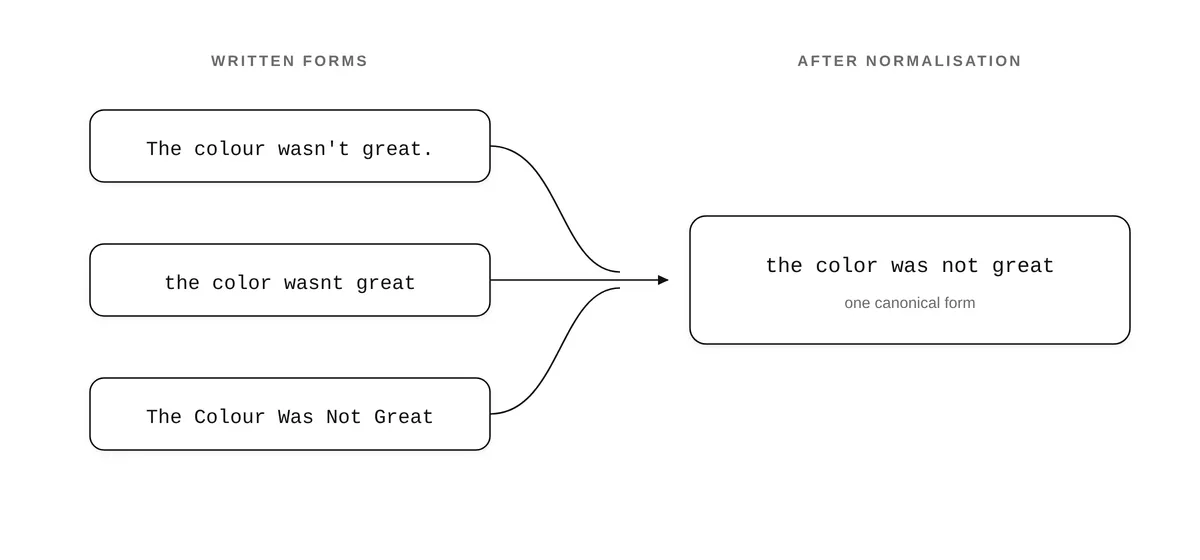
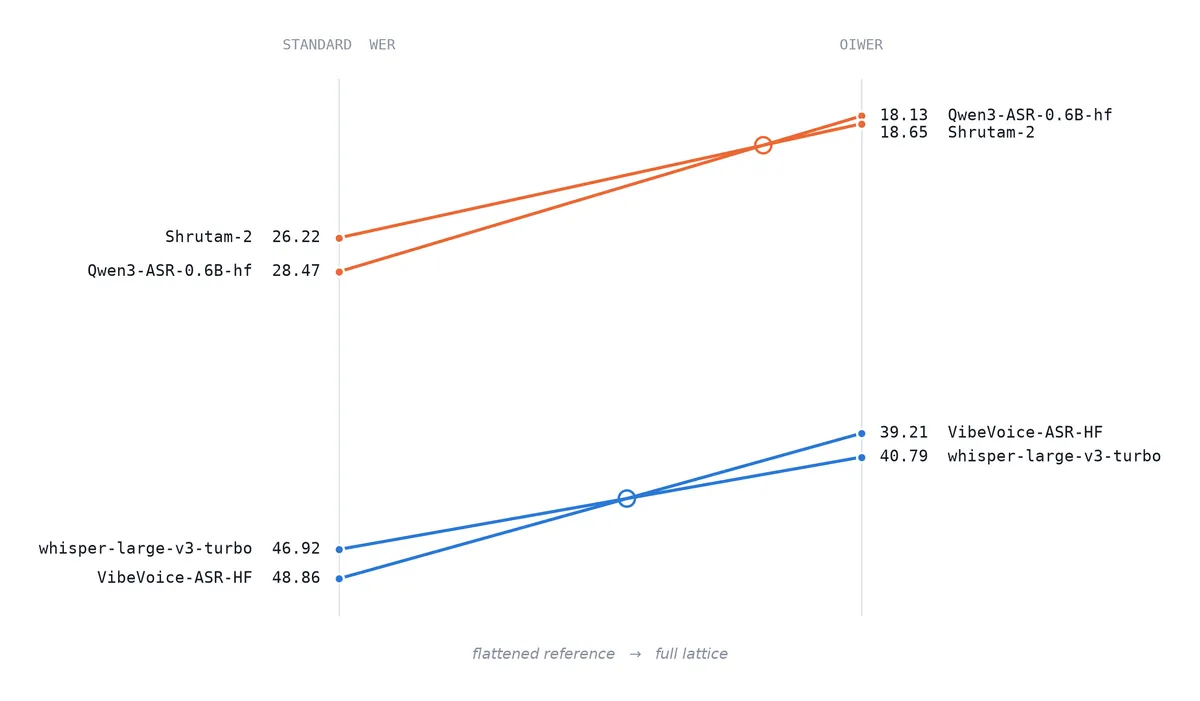
برای حل این مشکل، تیم Monsoon از متدهای رشتههای تکگانه فاصله گرفت و یک «شبکه» (Lattice) معرفی کرد؛ لیستی از تمام گونههای ارتوگرافیک پذیرفتهشده برای هر بخش از متن. این کار اجازه میدهد از معیار OIWER (نرخ خطای کلمه آگاه از رسمالخط) استفاده شود که توسط AI4Bharat معرفی شده است و خطاهای واقعی بازشناسی را جریمه میکند، نه انتخاب گوینده برای یک املای خاص.
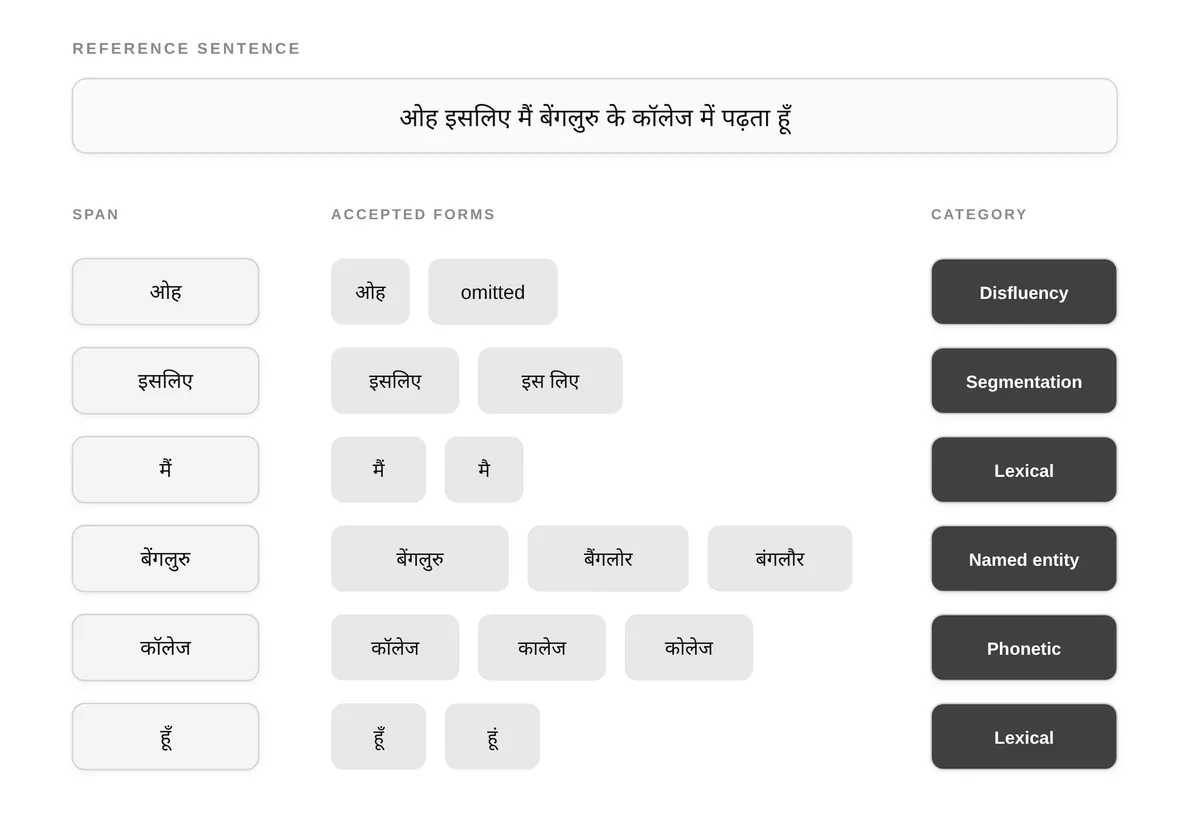
ساخت این شبکهها نیازمند کار دستی بود: گونههای کاندید از چندین متن ASR استخراج، توسط مدلهای زبانی بزرگ (LLMs) گسترش و سپس توسط زبانشناسان بومی پالایش شدند. وقتی این شبکهها به یک متن واحد تبدیل میشوند، نرخ خطا برای همه سیستمها بالا میرود و رتبهبندیها تغییر میکنند. این تایید میکند که بنچمارکهای سنتی اغلب به مدلهایی پاداش میدهند که املای انتخابی یک برچسبگذار انسانی را حدس میزنند، نه آنکه گفتار را درست تشخیص دهند. تیم برای اطمینان از بازتولید نتایج، پیادهسازی این ابزار را تحت نام voi-oiwer بهصورت متنباز منتشر کرده است.
کنترل کیفیت و خط لوله داده
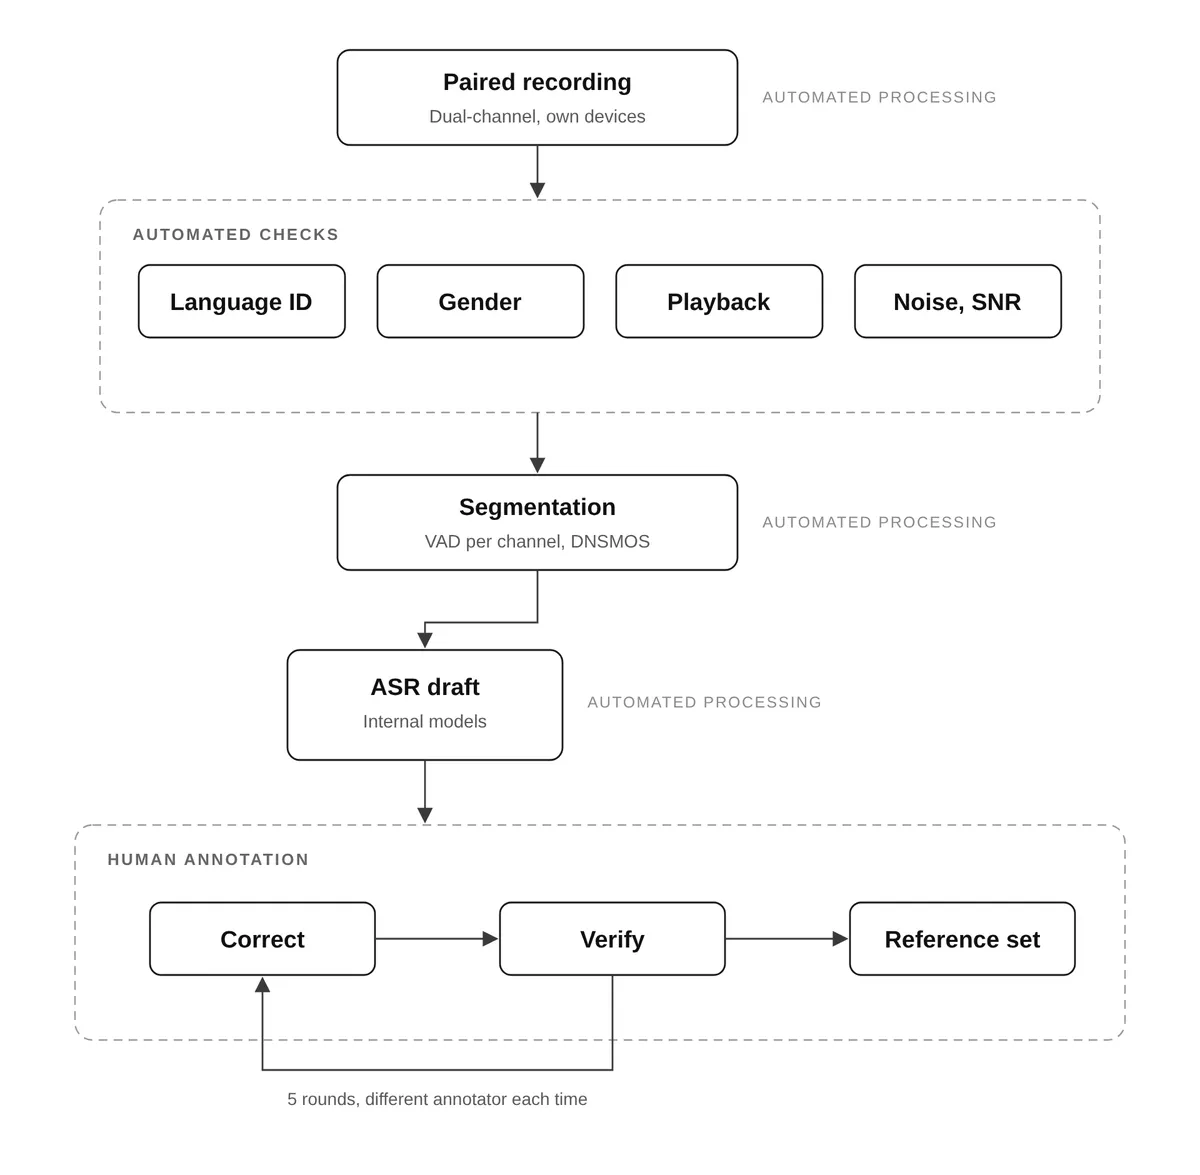
برای تضمین دقت دادههای مرجع (ground-truth)، یک پروتکل پنجسطحی اجرا شد. ابتدا مدلهای ASR داخلی پیشنویسها را تولید کردند. این مدلها روی دادههای درون-دامنه آموزش دیده بودند و در هیچ جدول ردهبندی عمومی ظاهر نمیشوند تا تضمین شود هیچ سیستمی بر اساس مراجع خودش ارزیابی نمیشود.
هر مرحله بعدی توسط زبانشناسان بومی انجام شد. هر دور اصلاح با یک دور تایید مستقل توسط یک برچسبگذار متفاوت دنبال شد تا از خود-بازرسی (self-auditing) جلوگیری شود. این چرخه باعث حل ابهامات در تحققهای آوایی، مرزهای تغییر زبان (code-switching) و موجودیتهای نامدار شد. اعداد بهصورت کلمه نوشته شدند تا مستقیماً با صوت مطابقت داشته باشند. رفتار برچسبگذاران بهطور خودکار برای شناسایی تکرارهای غیرطبیعی یا تعداد ویرایشهای غیرعادی نظارت شد.
برای حفظ واقعگرایی «در محیط واقعی» (in-the-wild)، تیم چندین گیت کنترلی را به کار گرفت:
- جذب: مشارکتکنندگان از طریق جامعه Voice Arena جذب شدند تا به مناطق روستایی و نیمهشهری دسترسی پیدا کنند. جفتهای مکالمه از طریق یک رابط peer-to-peer و با استفاده از گوشیها و اتصالات خودشان، از جمله دستگاههای ارزانقیمت با پهنای باند ناپایدار، ضبط کردند.
- تحریک گفتار: مکالمات با سرنخهای روایتی باز و سوالات تکمیلی درباره سفر، سلامت، کشاورزی، آموزش و خدمات دیجیتال شروع شدند. موضوعات توسط LLMها تولید و توسط زبانشناسان بومیسازی شدند.
- شناسایی زبان: زبان گفتهشده در مقابل برچسبهای تخصیصیافته با استفاده از مدلهای آموزشدیده روی بیش از ۳۰ زبان تایید شد.
- تایید جنسیت: یک طبقهبندیکننده اختصاصی برچسبهای جنسیت خوداظهاری را تایید کرد.
- ضد-تقلب: مدلی برای تشخیص مکالمات واقعی و خودبهخودی از صداهای پیشضبطشده یا پخششده به کار گرفته شد.
- فیلتر آکوستیک: تخمین نسبت سیگنال به نویز (SNR) صداهای غیرقابل فهم را حذف کرد، اما نویزهای طبیعی محیط حفظ شدند. تمام قطعات تست DNSMOS P.808 را پاس کردند. ضبطها در صورت وجود دو ثانیه سکوت یا رسیدن به سقف ۱۵ ثانیه، برش داده شدند.
تحلیل: تغییر پارادایم بنچمارکها
برای جامعه یادگیری ماشین، این یک چرخش از ارزیابی «حجممحور» به «واریانسمحور» است. سالها هدف تنها افزایش ساعتهای صوتی بود، اما Monsoon استدلال میکند ۵ ساعت صوت از ۱٬۵۰۰ گوینده متنوع، برای استواری (robustness) مدل بسیار ارزشمندتر از ۵۰۰ ساعت صوت از ۱۰ گوینده است.
با انتشار این متاداتا، Hugging Face توسعهدهندگان را مجبور میکند از معیار «میانگین WER» فراتر بروند. تحلیلهای پیشین روی بنچمارکهای بسته در ASR هندی نشان داده بود که نرخ خطای سطح منطقه از ۴٪ تا ۴۴٪ متغیر است و مناطق کمتر دیدهشده بهشدت از کلانشهرها و کمربند هندی عقب بودند. Monsoon این کلاس از تحلیل را روی یک جدول ردهبندی عمومی ممکن میکند. اثر ثانویه این اقدام، حرکت به سمت «بنچمارکهای انصاف» (Fairness Benchmarking) است؛ جایی که قابلیت یک مدل بر اساس بدترین عملکردش در یک بخش دموگرافیک سنجیده میشود، نه میانگین کلی.
گام بعدی شما
توسعهدهندگان اکنون میتوانند مدلهای خود را از طریق GitHub به Open ASR Leaderboard ارسال کنند تا روی بخشهای خصوصی Monsoon تست شوند. این فرآیند شامل باز کردن یک pull request، تکمیل چکلیست مدل و گزارش نتایج روی مجموعههای داده عمومی برای تایید است.
انگلیسی-هندی به عنوان Voice Arena Monsoon به جدول ردهبندی اصلی اضافه شده و در میانگین WER نهایی نقش دارد. بخش خصوصی به ستون تجمیعی Private (conversational) در کنار دادههای Appen و DataoceanAI تغذیه میشود. زبان هندی در تب Multilingual برای مقایسه مستقیم ظاهر شده است یا میتوان آن را از منوی کشویی "Language dataset breakdown" انتخاب کرد. این چهار مجموعه بخشی از Monsoon، ابتکار گستردهتر Voice Arena برای دادههای جنوب جهانی (Global South) هستند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو