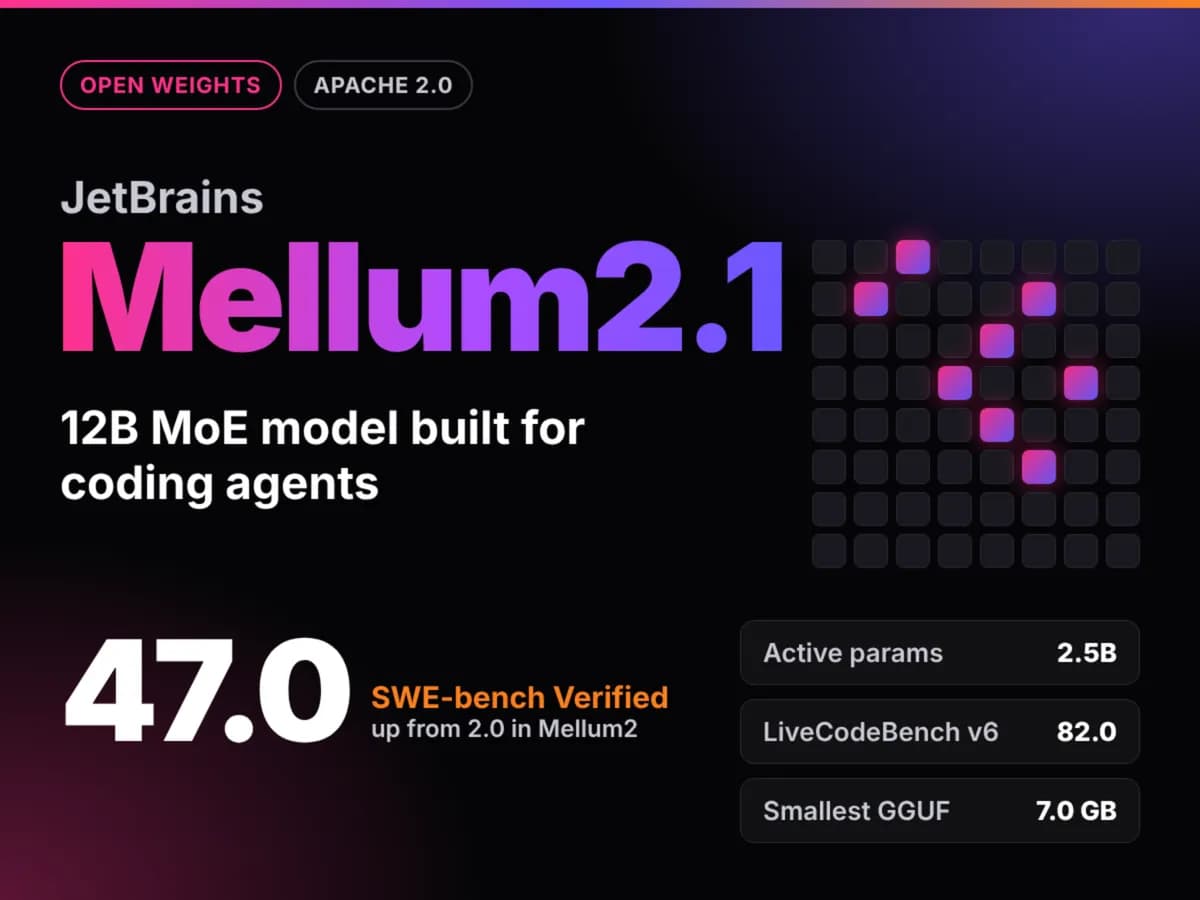
یک مدل ۱۲ میلیارد پارامتری اکنون میتواند با استقلالی غافلگیرکننده در مخازن پیچیده نرمافزاری پیمایش کند. در ۸ اکتبر ۲۰۲۶، شرکت JetBrains مدل Mellum2.1 را منتشر کرد؛ یک مدل استدلالی با وزنهای باز (Open Weights) که بهطور اختصاصی برای عاملهای (Agents) کدنویس و زیر-عاملهای سریع طراحی شده است.
این عرضه در حالی رخ میدهد که صنعت از مدلهای زبانی بزرگ عمومی به سمت مدلهای تخصصی «متفکر» حرکت میکند که پیش از پاسخ، یک زنجیره تفکر (Chain-of-Thought) تولید میکنند. این مدلها به جای پاسخ سریع، ابتدا مراحل استدلال خود را باز میکنند. همانطور که در تحلیل قبلی ما دربارهی ابزارهایی مانند roc و ایزولهسازی عاملهای هوش مصنوعی در کانتینرهای یکبارمصرف اشاره کردیم، Mellum2.1 لایهی هوشمندی لازم برای عملیات موثر در این محیطهای ایزوله (Sandboxes) را فراهم میکند تا عاملها بتوانند بدون آسیب به سیستم اصلی، کدها را اجرا و تست کنند.
به نقل از گزارش marktechpost.com، معماری این مدل از نوع ترکیب خبرهها (Mixture-of-Experts یا MoE) با ۶۴ خبره است، اما در هر توکن تنها ۲.۵ میلیارد پارامتر فعال هستند. این طراحی به مدل اجازه میدهد تا در عین داشتن ظرفیت بالا، سرعت پردازش زیادی داشته باشد. این ساختار باعث افزایش توان عملیاتی (Throughput) شده و امکان میزبانی محلی روی سختافزارهای مصرفکننده را فراهم میکند، به طوری که توسعهدهندگان نیازی به سرورهای عظیم ابری برای اجرای مدل ندارند. این تلاش برای بهینهسازی سرعت در لبهی شبکه، یادآور پیشرفتهای اخیر در کاهش تأخیر است، مشابه آنچه در پروژهی Ollaya برای رساندن تأخیر استنتاج مدلهای تصمیمگیر به ۸.۹ میلیثانیه مشاهده کردیم.
زمینه و موارد کاربرد
JetBrains نسخهی پیشین یعنی Mellum2 Thinking را در ژوئن ۲۰۲۶ عرضه کرده بود. نسخهی فعلی که یک نقطه بازرسی (Checkpoint) پیشرفتهتر است، رسماً با نام Mellum2.1-12B-A2.5B-Thinking شناخته میشود.
این شرکت سه مورد کاربرد اصلی را برای این مدل هدف قرار داده است: اول به عنوان یک کارگر-عامل (Agent Worker) برای انجام وظایف کدنویسی خودکار، دوم به عنوان یک دستیار استدلال عمومی برای حل مسائل پیچیده، و سوم برای استقرارهای خصوصی و میزبانی شخصی در محیطهای سازمانی. از آنجا که این مدل تحت مجوز Apache 2.0 در Hugging Face منتشر شده، دسترسی به آن برای همه فراهم است و ادغام آن در زیرساختهای سازمانی بسیار ساده و بدون محدودیتهای سختگیرانه است.
مشخصات فنی
- کل پارامترها: ۱۲ میلیارد (۲.۵ میلیارد فعال از طریق ۸ خبره در هر توکن)
- پنجره زمینه (Context Window): ۱۳۱,۰۷۲ توکن
- واژگان (Vocabulary): ۹۸,۳۰۴ توکن
- معماری: ۲۸ لایه؛ توجه پرسوجوی گروهبندی شده (Grouped-query attention) با ۳۲ سر پرسوجو و ۴ سر KV
- بهینهسازی حافظه: ۳ لایه از هر ۴ لایه از یک پنجره لغزان (Sliding Window) ۱,۰۲۴ توکنی استفاده میکنند تا مصرف حافظه بهینه شود
- وزنها: ارائه شده در قالب bfloat16
- مجوز: Apache 2.0
- استقرار: سازگار با vLLM، SGLang و GGUF (حجم فایلها از ۷ گیگابایت شروع میشود)
پیشرفت در یادگیری تقویتی
مهمترین تغییر در Mellum2.1 نه در معماری، بلکه در مرحله پسآموزش (Post-training) است. به بر اساس مستندات JetBrains، یادگیری تقویتی (RL) از یک مرحله صیقلدهندهی نهایی که معمولاً در انتهای آموزش قرار دارد، به هستهی اصلی فرآیند آموزش منتقل شده است.
JetBrains وظایف RL را در چندین دامنه مختلف اضافه کرد، از جمله ریاضیات، علوم، برنامهنویسی رقابتی، استفاده از ابزارها و مهندسی نرمافزار. برای تضمین کیفیت دادهها، آنها مجموعهدادههای RL باز را به دقت فیلتر کردند تا تستهای خراب، پاسخهای غیرقابل تأیید و وظایفی که یا بیش از حد ساده بودند یا غیرممکن، کاملاً حذف شوند.
در بخش مهندسی نرمافزار بهطور خاص، مدل در مخازن (Repositories) واقعی آموزش میبیند. در این محیط، مدل به شل (Shell) و ابزارهای ویرایش فایل دسترسی دارد. نکته کلیدی این است که مدل تنها زمانی پاداش میگیرد که تستهای نوشته شده برای کد، با موفقیت پاس شوند. این فرآیند آموزشی منجر به راهاندازی میلیونها محیط ایزوله (Sandbox) در هزاران محیط مختلف شد تا مدل با تنوع بالایی از خطاهای نرمافزاری آشنا شود.
این رویکرد جهشی عظیم در عملکرد عاملمحور کدنویسی ایجاد کرد. برای ارزیابی، از هارنس متنباز Pi v0.73.1 با پنجره متنی ۱۱۴ هزار توکنی استفاده شد و نتایج تکاندهنده بود. در محک SWE-bench Verified، امتیاز Mellum2.1 از مقدار ناچیز ۲.۰ به ۴۷.۰ رسید که نشاندهنده توانایی مدل در حل واقعی باگهای نرمافزاری است. همچنین در SWE-bench Pro (از ۰.۰ به ۲۸.۰) و Terminal-Bench 2.1 (از ۰.۶ به ۱۷.۴) رشد چشمگیری داشت.
محکهای عملکردی
در تستهای رودررو با استفاده از یک خط لوله مشترک در حالت تفکر (Thinking Mode)، Mellum2.1 در وظایف خاص کدنویسی از چندین رقیب پیشی گرفت:
- LiveCodeBench v6: امتیاز ۸۲.۰ (برتر از Qwen3.5-9B با ۷۵.۴ و Gemma 4 E4B با ۶۹.۴)
- HumanEval+: ۹۱.۵
- MBPP+: ۷۹.۴
- BFCL v4: ۶۲.۳
با این حال، این مدل همچنان در وظایف سخت مهندسی نرمافزار و دانش عمومی از Qwen3.5-9B عقبتر است. مدل Qwen در معیارهای SWE-bench Verified (۵۰.۰)، SWE-bench Pro (۳۸.۰)، AIME 25/26 (۸۶.۷) و GPQA Diamond (۷۷.۸) پیشتاز است. همچنین در Terminal-Bench 2.1 امتیاز Mellum2.1 برابر با ۱۷.۴ در مقابل ۲۱.۷ برای Qwen بود که نشان میدهد Qwen در تعامل با ترمینال کمی قویتر است.
ایمنی مدل نیز ارتقا یافته و امتیاز HarmBench از ۲۱.۵ به ۸.۵ کاهش یافته است (که در این معیار، عدد کمتر به معنای ایمنی بیشتر و کاهش پاسخهای مضر است).
سرعت و اجرای محلی
به دلیل عدم تغییر در معماری نسبت به Mellum2، سرعت ثابت مانده است. روی یک کارت گرافیک NVIDIA H200 تحت بار زیاد، Mellum2.1 تقریباً ۲ برابر توکنهای Qwen3.5-9B را سرو میکند. برای درخواستهای تکگانه، قابلیت پیشبینی چند-توکنی (MTP) سرعت را حدود ۱.۶ برابر افزایش میدهد، هرچند سر MTP برای رمزگشایی گمانهزنانه (Speculative Decoding) در vLLM بهزودی اضافه خواهد شد.
برای کاربران محلی، نسخههای GGUF گزینههای متعددی را بر اساس دقت و حجم ارائه میدهند:
- MXFP4_MOE: حجم ۷ گیگابایت (تطابق ۸۵.۶٪ توکن برتر)
- Q4_K_M: حجم ۸.۱ گیگابایت (تطابق ۸۸.۰٪، نسخه توصیه شده)
- Q6_K: حجم ۱۰.۹ گیگابایت (تطابق ۹۳.۹٪)
- Q8_0: حجم ۱۲.۹ گیگابایت (تطابق ۹۶.۱٪)
- BF16: حجم ۲۴.۳ گیگابایت (نسخه مرجع)
تحلیل تحریریه
برای جامعه فنی، Mellum2.1 ثابت میکند که یادگیری تقویتی (RL) در محیطهای با دقت بالا (High-fidelity)، بسیار ارزشمندتر از افزایش ساده تعداد پارامترها است. این واقعیت که مدلی با تنها ۲.۵ میلیارد پارامتر فعال میتواند در LiveCodeBench با مدلهای متراکم بزرگتر رقابت کند، نشان میدهد که «زمان تفکر» و پاداشهای مبتنی بر محیط (Environment-grounded rewards) اهرمهای اصلی جدید برای هوشمندی در کدنویسی هستند.
این تغییر باعث میشود عاملهای کدنویسی محلی و خصوصی کاربردی شوند. با نسخههای GGUF که تا ۷ گیگابایت کوچک میشوند، توسعهدهندگان اکنون میتوانند یک عامل با قابلیت استدلال را روی یک GPU واحد اجرا کنند، بدون اینکه نیاز باشد کدهای حساس و اختصاصی خود را به یک ارائهدهنده ابری ارسال کنند.
گام بعدی شما
- وزنهای مدل را از Hugging Face دریافت کرده و با فلگ
--reasoning-parser qwen3در vLLM مستقر کنید. - برای فعالسازی فراخوانی ابزار (Tool Calling)، از پارامترهای
--enable-auto-tool-choice --tool-call-parser hermesاستفاده کنید. - تنظیمات پیشنهادی JetBrains را اعمال کنید: Temperature 0.6، top_p 0.95 و top_k 20.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو