اگر برای اتوماسیون تصمیمات حساس خود به قطعیت مدلهای هوش مصنوعی تکیه کردهاید، باید بدانید که ترافیک سرور میتواند منطق مدل شما را تغییر دهد. در محیط عملیاتی، یک مدل که در آزمایشگاه کاملاً پیشبینیپذیر است، ممکن است تنها به دلیل حضور کاربران دیگر در همان لحظه، پاسخ متفاوتی به شما بدهد.
طبق گزارش منتشر شده در سپتامبر ۲۰۲۶ توسط Autom8ly، مدل Kev-4B در حالت تکدرخواست کاملاً ثابت است، اما به محض اینکه درخواستها برای افزایش سرعت در دستههای بزرگتر قرار میگیرند، خاصیت قطعیت (Determinism) آن از بین میرود. این کشف ثابت میکند که بار پردازشی در محیط تولید میتواند بهطور بنیادی خروجی مدلی را که در حالت ایزوله پایدار به نظر میرسید، تغییر دهد.
بسیاری از توسعهدهندگان تصور میکنند اگر مدلی روی میز تست ثابت باشد، در محیط تولید نیز همینطور خواهد بود. اما واقعیت محاسبات واحد پردازش گرافیکی (GPU) — که شبیه به یک آشپزخانه صنعتی است و هرچه دستور پختها سنگینتر شوند، ترتیب انجام کارها برای سرعت بیشتر تغییر میکند — بسیار پر هرجومرجتر است. وقتی درخواستها برای افزایش توان عملیاتی (Throughput) در دستههای بزرگتر (Batch) قرار میگیرند، ترتیب عملیات ریاضی تغییر میکند و این منجر به انحرافهای جزئی در امتیازات احتمالی میشود. این احتمالاً به این دلیل است که محاسبات GPU دقیقاً خاصیت شرکتپذیری (Associative) ندارند؛ دستههای بزرگتر میتوانند به ترتیبهای متفاوتی تقسیم و جمع شوند و سرور ممکن است با دستههای بزرگتر به شکل متفاوتی برخورد کند.
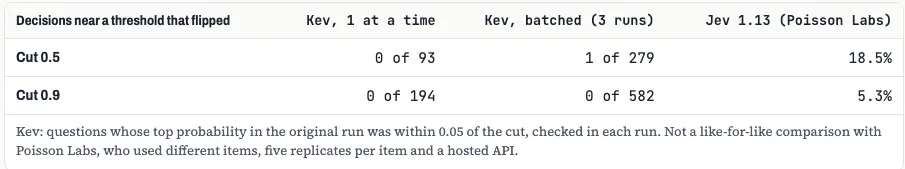
همانطور که در تحلیلهای پیشین ما دربارهی پایداری مدلهای استدلالی اشاره کردیم، این مشکل دقیقاً در زمانی رخ میدهد که صنعت به سمت «مدلهای تصمیمگیر» حرکت میکند؛ مدلهایی که برای اتوماسیون انتخابهای حساس با اطمینان بالا طراحی شدهاند. اگر پاسخ یک مدل صرفاً به این دلیل تغییر کند که کاربران دیگری همزمان در حال استفاده از سرور هستند، کل زنجیره اتوماسیون غیرقابل اعتماد میشود. این یافتهها با گزارشهای Poisson Labs همسو است؛ تیلور کولاسینسکی، بنیانگذار این آزمایشگاه، اشاره کرده بود که در مدل استاندارد Jev، حدود ۱۸.۵٪ از تصمیمات در نقاط برش ۰.۵ یا ۰.۶، و ۵.۳٪ از تصمیمات در نقطه برش ۰.۹، تنها به دلیل ارسال مجدد درخواست، تغییر میکنند.
نقطه شکست در دستهبندی
در ۲۸ سپتامبر ۲۰۲۶، پژوهشگران ۸۶۶ پرسش یکسان را به نسخه کوانتیده ۴-بیتی Kev-4B که روی یک کارت NVIDIA RTX 4060 (۸ گیگابایت) اجرا میشد، ارسال کردند. برای اطمینان از صحت نتایج و اینکه نتایج جعلی نباشند، آنها تأیید کردند که درگاه (Gateway) هیچ حافظه موقتی (Cache) ندارد و سرور تنها چهار ورودی اخیر را ذخیره میکند. از آنجا که بین تکرارها ۸۶۶ ورودی متفاوت ارسال شده بود، هر پاسخ از ابتدا محاسبه شد. در این آزمایش، API احتمالات را تا چهار رقم اعشار گرد میکند و همین معیار به عنوان تعریف «یکسان بودن» در نظر گرفته شد.
نتایج تفاوت شدیدی را بر اساس میزان همزمانی نشان داد:
- دستههای تک یا کوچک: درخواستهایی که بهتنهایی یا در دستههای حداکثر سه تایی اجرا شدند، در تمام تکرارها ۱۰۰٪ یکسان بودند. بهطور مشخص، ۲,۰۱۵ درخواست در این دسته کاملاً یکسان باقی ماندند.
- دستههای بزرگ: در دستههای ۵ تایی یا بیشتر، ۱,۲۲۳ مورد از ۲,۳۱۵ درخواست، خروجیهای احتمالی متفاوتی داشتند.
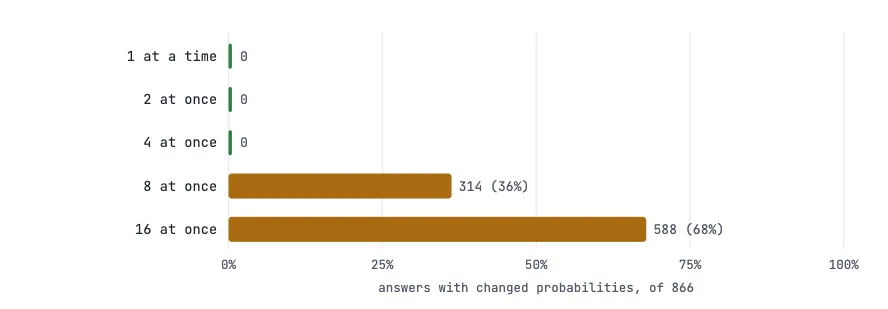
وقتی سرور درخواستها را در دستههای ۸ تایی پردازش کرد، دو اجرای مجزا در ۴۰۳ مورد از ۸۶۶ پرسش با هم اختلاف داشتند. این اتفاق میافتد چون ترکیب خاص هر دسته به زمان دقیق ورود ترافیک بستگی دارد و در نتیجه، خروجی بهجای منطق، تابع شانس میشود.
تأثیر بر صحت تصمیمات
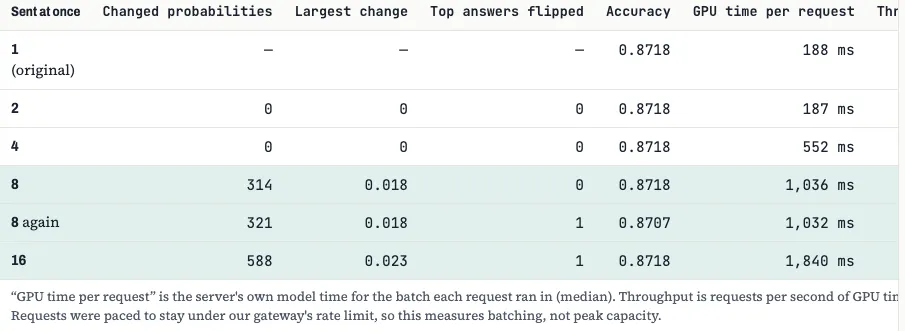
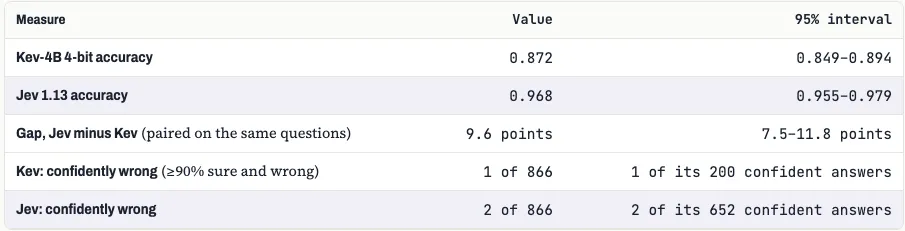
با وجود انحراف در اعداد احتمالی، تصمیمات نهایی عمدتاً پایدار ماندند. از ۲,۵۹۸ پاسخ دستهبندی شده، تنها دو مورد تغییر جهت دادند (Top choice تغییر کرد). یکی از این تغییرات، یک پاسخ درست را به غلط تبدیل کرد و امتیاز مدل را از ۰.۸۷۲ به ۰.۸۷۰۷ کاهش داد. نکته مهم این است که هیچ پاسخی در هیچ کجای آزمایش از خط اطمینان ۰.۹ عبور نکرد.
این تغییرات صرفاً در موارد «تقریباً برابر» (Near-ties) رخ داد؛ یعنی جایی که دو گزینه تنها با کسری از یک درصد تفاوت داشتند. برای مثال، در یک پرسش گرامری، دو گزینه برتر از ۰.۳۰۱۳ و ۰.۳۰۴۲ به ۰.۳۰۴۳ و ۰.۳۰۴۰ تغییر یافتند.
موازنه توان عملیاتی و دقت
دستهبندی (Batching) — که شبیه به جمع کردن چندین سفارش در یک سفر پیک برای کاهش هزینه است — معمولاً برای بهینهسازی GPU استفاده میشود. اما برای Kev-4B روی کارت ۸ گیگابایتی، این سود ناچیز بود. ارسال ۱۶ درخواست همزمان، توان عملیاتی را ۴۵٪ افزایش داد، اما زمان انتظار برای هر درخواست را تقریباً ۱۰ برابر کرد. در این سختافزار خاص، مدل حتی در پردازش تکدرخواستی نیز از GPU بهطور بهینه استفاده میکند.
بازنگری در آستانههای اطمینان
این مطالعه همچنین نحوه اندازهگیری تصمیمات «قابل اتوماسیون» را به چالش کشید. پیش از این ادعا شده بود که با بودجه خطای ۵٪، نرخ اتوماسیون ۷۵٪ است. اما این معیار «قابل اتوماسیون در خطای ۵٪» از یک آستانه ثابت ۹۰٪ استفاده نمیکند. در عوض، پاسخها را از مطمئنترین به کماطمینانترین مرتب کرده و تا جایی که خطا زیر ۵٪ بماند، آنها را میپذیرد.
کولاسینسکی معتقد بود انتخاب این آستانه روی همان ۸۶۶ پرسشِ امتیازدهی، باعث خوشبینانه جلوه دادن مدل میشود. برای تست واقعی، پژوهشگران از تقسیم تصادفی ۵۰/۵۰ در ۲,۰۰۰ تکرار استفاده کردند. در حالی که پوشش مدل ثابت ماند، نرخ خطای واقعی در نمونه جدیدی از حدود ۴۳۰ تصمیم، بین ۲٪ تا ۸.۷٪ نوسان داشت.
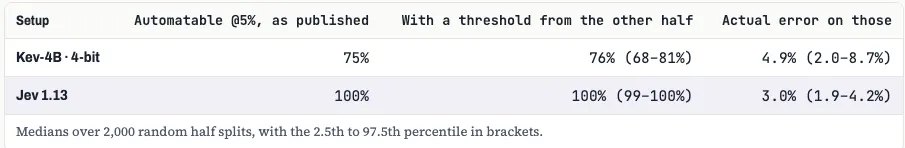
این نشان میدهد که یک عدد واحد برای صحت، اغلب بیش از حد خوشبینانه است. برای حفظ سقف خطای سختگیرانه ۵٪، توسعهدهندگان باید بودجهای محافظهکارانهتر بر اساس دادههای برچسبگذاریشده خود تنظیم کنند، نه اینکه به بنچمارکهای کلی تکیه کنند.
شکست مدل Julia-1
در این گزارش، مدل Julia-1 محصول Supersonic Labs (منتشر شده در ۲۶ سپتامبر ۲۰۲۶) نیز مورد آزمایش قرار گرفت. این مدل با ۱۴۴ میلیون پارامتر، بر پایه یک انکودر ModernBERT چندزبانه و با لایسنس Apache-2.0 ساخته شده است و آنقدر کوچک است که روی CPU لپتاپ اجرا شود. سازندگانش ادعا کرده بودند که در بنچمارک داخلی خود (Typed-decision) از مدل Jev پیشی گرفته است (۷۳.۲٪ در برابر ۷۲.۷٪).
اما در محیط تست مستقل با ۸۶۶ پرسش در ۴۹ وظیفه مختلف، Julia-1 تنها امتیاز ۰.۴۵۰ را کسب کرد. با وجود تأیید صحت فایل وزنها با چکسام (Checksum) و بررسی درست بودن مثالهای README، مدل در تستهای شبیهساز محیط تولید بهشدت شکست خورد.
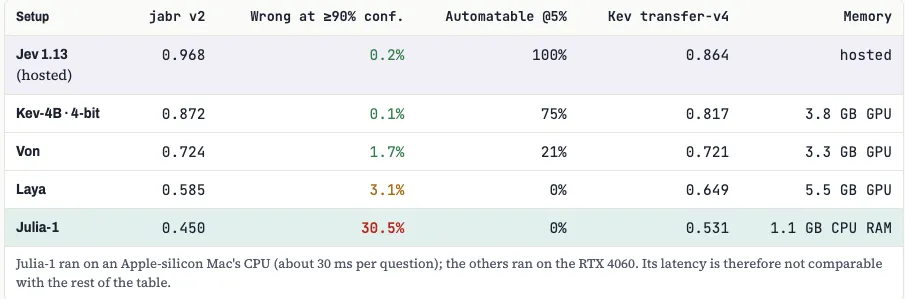
مدل Julia-1 مشکلات جدی در زمینه اطمینان و حساسیت به کلمات داشت:
- اعتماد به نفس کاذب: ۳۰٪ از پاسخهای غلط مدل، در حالی صادر شد که مدل حداقل ۹۰٪ مطمئن بود.
- عدم تفکیک: مدل نتوانست پاسخهای «بله» و «خیر» را بهدرستی جدا کند؛ میانگین احتمال بله در موارد درست ۰.۳۶ و در موارد غلط ۰.۳۷ بود.
- حساسیت به عبارتبندی: در یک پرسش مربوط به استرداد وجه، احتمال بله برای پرسش ساده ۰.۰۰۵ بود، اما با افزودن توضیحات ساده بله/خیر، به ۰.۹۹۷ رسید. افزودن این توضیحات به کل مجموعه، ۱۰۱ پاسخ را تغییر داد اما صحت کلی را در ۰.۴۴۹ ثابت نگه داشت.
جزئیات فنی و متدولوژی
برای تضمین اعتبار یافتهها، از چارچوب سختگیرانهای استفاده شد:
- تست همزمانی: درخواستهای همزمان در دستههای N با سرعت تقریبی ۵۵ درخواست در دقیقه ارسال شدند. اندازه دسته از طریق مقایسه زمان مدل در سرور برای درخواستهای موجود در یک Burst استخراج شد.
- تحلیل آستانه: «تغییرات» (Flips) برای پرسشهایی ردیابی شد که احتمال برتر آنها در اجرای اول در بازههای [۰.۴۵، ۰.۵۵) یا [۰.۸۵، ۰.۹۵) قرار داشت.
- اعتبارسنجی آماری: از بوتاسترپهای صدک ۹۵٪ روی موارد برای تعیین بازهها و ۲,۰۰۰ تقسیم تصادفی ۵۰/۵۰ برای تستهای پوشش استفاده شد.
- منطق آداپتور: برای مجموعه transfer-v4، جایی که برخی گزینهها فاقد توضیحات بودند، آداپتور Julia-1 از نام گزینهها استفاده کرد تا رفتاری مشابه مدل Jev داشته باشد.
درسهای مهندسی
قابلیت بازتولید (Replayability) ویژگیِ نحوه استقرار است، نه وزنهای مدل. اگر برای یک تصمیم به ردپای حسابرسی (Audit Trail) نیاز دارید، نمیتوانید به اجرای مجدد مدل تکیه کنید. شما یا باید دستهها را بسیار کوچک (۳ یا کمتر) نگه دارید یا دقیقاً همان احتمالات بازگشتی در لحظه تصمیم را ذخیره کنید.
همچنین نتایج Julia-1 هشداری است درباره اعتماد به بنچمارکهای داخلی. این مدل روی توزیع دادههای آموزشی خود تنظیم شده بود اما در مواجهه با وظایف مستقل فروپاشید. شکاف بین Kev-4B و Jev همچنان واقعی است و حتی در لبه بازه ۹۵٪، بیش از هفت امتیاز است. نرخ خطای مطمئن ۰.۱٪ در Kev، اگرچه پایین است، اما نشاندهنده یک اشتباه واحد است، به این معنی که نرخ واقعی میتواند چند برابر بیشتر باشد.
این تغییر دیدگاه به این معناست که «قطعیت» دیگر یک چکباکس صفر و یک نیست، بلکه متغیری است که با بار سرور، معماری GPU و منطق دستهبندی نوسان میکند. برای تضمین پایداری تولید، تیمها باید هر تصمیمی که در بازه باریکی از آستانه اطمینان قرار دارد را به عنوان نتیجه «نامطمئن» تلقی کرده و آن را به مداخله انسانی ارجاع دهند.
گام بعدی شما
- اگر از مدلهای تصمیمگیر در محیط Production استفاده میکنید، اندازه دسته (Batch Size) را به ۳ یا کمتر محدود کنید تا از تغییر پاسخها جلوگیری شود.
- بهجای ذخیره نهایی تصمیم، تمام احتمالات خروجی (Logits) را در لحظه استنتاج لاگ کنید تا امکان حسابرسی دقیق فراهم شود.
- بنچمارکهای داخلی سازندگان مدل را با دادههای مستقل و توزیعهای تصادفی (Random Split) به چالش بکشید.
اما تأثیر این نوسانات بر مدلهای بزرگتر و گرانقیمتتر حتی پیچیدهتر است — به تحلیل ما دربارهی بهینهسازی استنتاج در مدلهای Llama-3 مراجعه کنید.



گفتگو