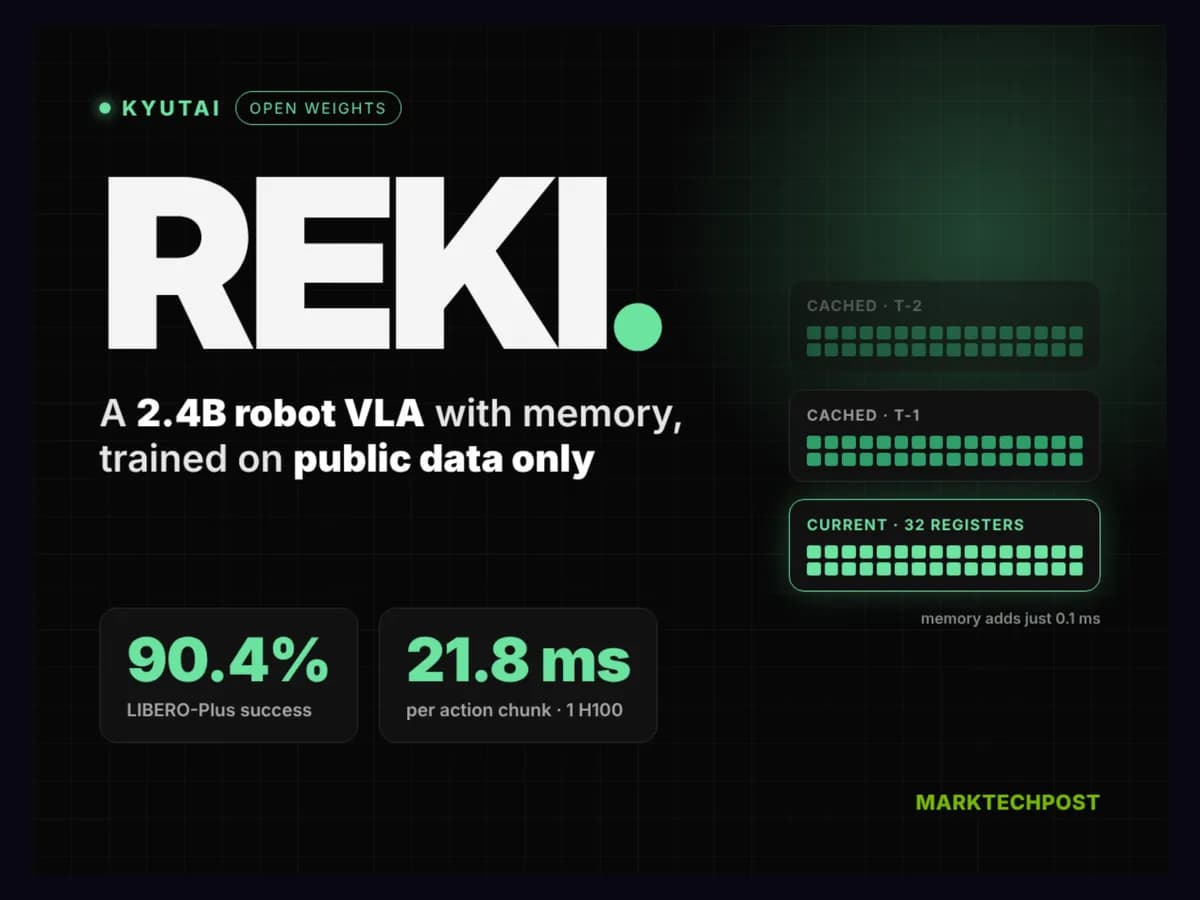
دقت ۹۰.۴ درصدی در محک LIBERO-Plus؛ این عدد تنها یک آمار نیست، بلکه اثباتی است بر اینکه مدلهای کوچکتر میتوانند در کنترل سختافزار، غولهای دنیای AI را به چالش بکشند. مدل REKI که در ۱۷ اکتبر ۲۰۲۶ معرفی شد، نشان میدهد که برای رسیدن به مهارتهای پیچیده در رباتیک، لزوماً به میلیاردها پارامتر نیاز نداریم. این مدل ۲.۴ میلیارد پارامتری توسط Kyutai با همکاری Inria و École des Ponts توسعه یافته است و طبق گزارش فنی پروژه، ثابت میکند که یک معماری کوچکتر اکنون میتواند با سیستمهایی که دو برابر آن اندازه هستند در زمینه دستورزی رباتیک رقابت کند.
این دستاورد در حالی رخ میدهد که صنعت به سمت مدلهای بنیادی با وزنهای باز (Open Weights) و کارآمدتر حرکت میکند. همانطور که در تحلیل قبلی ما دربارهی چارچوب OpenWAM استنفورد دیدیم که به صحت ۹۸.۶ درصدی در دستورزی رسیده بود، چالش اصلی اکنون دیگر فقط دقت نیست، بلکه «حافظه زمانی» است. اکثر مدلهای VLA فعلی تنها بر اساس یک فریم تصویری تصمیم میگیرند و همین موضوع باعث میشود بازوی ربات به دلیل پدیده «ابهام ادراکی» (Perceptual Aliasing)، بین دو وضعیت نوسان کند و دچار لرزش شود.
زمینه و معماری
به نقل از گزارش فنی پروژه، REKI نماهای دوربین و دستورات زبان طبیعی را مستقیماً به اقدامات ربات نگاشت میکند. این مدل از یک معماری ترکیبی استفاده میکند که یک ستون فقرات VLM مدل Qwen3.5-2B با ۲.۲ میلیارد پارامتر را با یک «خبرهٔ کنشی» (Action Expert) با ۲۰۰ میلیون پارامتر جفت میکند. این خبره، تکههای کنشی (Action Chunks) را از طریق مکانیزم Flow Matching تولید میکند که در ۱۰ گام اویلر (Euler steps) ادغام شدهاند. برای مدیریت ورودیهای متنوع، وضعیت ربات و زمان جریان (Flow Time) از طریق یک RMSNorm تطبیقی وارد سیستم میشوند و هر چیدمان وضعیت ربات، MLP وضعیت کوچک مخصوص به خود را دریافت میکند.
برای حل مشکل پایداری، Kyutai یک سیستم «حافظه ارزان» را مستقیماً در بخش خبرهٔ کنشی ادغام کرده است. بهجای اینکه فریمهای قبلی را دوباره به مدل VLM بفرستد — که هزینه محاسباتی را بهشدت بالا میبرد — REKI از ۳۲ توکن ثبتکننده (Register Tokens) یادگرفتهشده استفاده میکند که به صورت خود-توجهی (Self-attend) به ثبتکنندههای فریمهای قبلی متصل میشوند. این ثبتکنندهها به پرامپت کدگذاریشده و نماهای فعلی توجه متقاطع (Cross-attend) دارند، اما هرگز توکنهای کنشی را نمیخوانند؛ این امر تضمین میکند که حافظه فقط به مشاهدات وابسته باشد. این پنجرهٔ لغزان، سه فریم اخیر را که با فاصله یک ثانیه از هم هستند، پوشش میدهد.
جزئیات فنی
بر اساس مستندات فنی، مشخصات دقیق این مدل به شرح زیر است:
- معماری: ترکیب مدل ۲.۲ میلیارد پارامتری Qwen3.5-2B با یک خبره کنشی ۰.۲ میلیارد پارامتری مبتنی بر Flow-matching. وزنها در قالب BF16 عرضه شدهاند.
- عملکرد: تأخیر ۲۱.۸ میلیثانیه برای هر تکه کنشی روی یک GPU مدل NVIDIA H100 (نسخه کامپایلشده)، با استفاده از دو دوربین با رزولوشن ۲۵۶×۲۵۶. خواندن حافظه تنها ۰.۱ میلیثانیه سربار اضافه میکند.
- بهرهوری حافظه: حافظه پنهان (Cache) برای هر فریم گذشته تقریباً ۲ مگابایت از حافظه GPU را اشغال میکند. در هنگام آموزش، یک پنجره ۳ فریم در یک پاس دستهای (Batched pass) بستهبندی میشود.
- دادههای آموزش: ترکیبی از ۱ میلیارد فریم و ۱۲.۲ میلیون نمونه بینایی-زبانی. این مجموعه شامل ۶۳۹.۸ میلیون فریم تلهاپریشن ربات واقعی، ۱۹۳.۹ میلیون فریم شبیهسازی و ۱۷۰.۹ میلیون فریم ویدئویی انسانی از دید اول (Egocentric) از منابعی مانند DROID، BridgeData V2، AgiBot World، EgoDex و EgoVerse است. این رویکرد یادگیری از دادههای متنوع، یادآور استراتژی Reka AI در توسعه مدل Rho-1 است که برای حذف دادههای گرانقیمت رباتیک بر ویدئوهای وب تکیه کرده بود.
- محاسبات: پیشآموزش (Pretraining) طی ۲۰۰ هزار گام روی ۳۲ عدد H100 انجام شده است. Kyutai بهجای بازنگاری در اقدامات، قراردادهای کنترلی بومی هر مجموعهداده را حفظ کرده است.
عملکرد در بنچمارکها
تأثیر این سیستم حافظه در پایداری ربات خیرهکننده است. در محک RoboTwin، نرخ نوسان بازوی ربات در اپیزودها با فعال کردن حافظه از ۱۸.۶٪ به ۴.۱٪ کاهش یافت. همچنین حافظه باعث افزایش دقت خام ۱.۵ امتیازی در LIBERO-Plus و ۵.۴ امتیازی در RoboCasa365 شد.
از نظر دقت خام، REKI با کسب امتیاز ۹۰.۴٪ در LIBERO-Plus، مدلهای Qwen-RobotManip (۸۹.۰٪) و π0.5 (۸۵.۷٪) را شکست داد. این مدل به دقت ۹۷.۶٪ در چهار مجموعه LIBERO و ۸۵.۹٪ / ۸۴.۶٪ در نسخههای آسان و سخت RoboTwin 2.0 دست یافت. در تست RoboTwin Clean2Rand، امتیاز آن ۶۵.۸٪ بود و تنها از Qwen-RobotManip (۶۸.۵٪) عقب ماند. ضعیفترین نقطه آن RoboCasa365 با ۳۸.۴٪ بود که اگرچه از RLDX-1 (۳۶.۰٪) جلوتر است، اما بهطور قابلتوجهی پشت سر Xiaomi-Robotics-1 (۵۷.۴٪) قرار دارد.
پیشآموزش برای عملکرد در توزیعهای خارج از محدوده (Out-of-distribution) حیاتی بود و ۱۳.۸ امتیاز به Clean2Rand و ۳۰.۳ امتیاز در شرایط شلوغ (Clutter) اضافه کرد.
از منظر فنی، REKI این فرض را میشکند که برای دستورزی سطح بالا، حتماً به مجموعهدادههای عظیم و اختصاصی نیاز است. Kyutai ثابت کرد که با استفاده از دادههای عمومی و یک مکانیزم حافظه بهینه، میتوان کمبود دادههای تلهمتری خصوصی را جبران کرد. این رویکرد راه را برای استقرار مدلهای VLA روی سختافزارهای لبه (Edge Hardware) باز میکند، بدون اینکه زمینه زمانی لازم برای کارهای پیچیده از دست برود. استفاده از Flow-matching برای تکههای کنشی، انتقال از بینایی سطح بالا به کنترل موتور سطح پایین را بیش از پیش بهینه میکند. در حالی که REKI بر بینایی و حافظه متمرکز است، برخی سیستمها مانند Neuron AI با افزودن حس لامسه و شنوایی، ابعاد جدیدی از ادراک فیزیکی را به رباتهای صنعتی آوردهاند.
توسعهدهندگان اکنون میتوانند به ۶ نقطه بازرسی (Checkpoint) مختلف در Hugging Face دسترسی داشته باشند، شامل مدل پایه پیشآموزشدیده و نسخههای تنظیمشده برای LIBERO، RoboTwin (دو مدل)، RoboCasa365 و RoboCasa-GR1. استقرار مدل از طریق پروتکل gRPC در LeRobot async-inference پشتیبانی میشود. برای مثال، روی بازوی UR5، مدل REKI تنها با ۳ هزار گام تنظیم دقیق (۱ ساعت) و ۵۰ نمایش (Demonstration) برای هر تسک، بهینه شد.
باید منتظر ماند و دید جامعه توسعهدهندگان چگونه این توکنهای حافظه مبتنی بر ثبتکننده را با ستونهای فقرات VLM بزرگتر تطبیق میدهند، که میتواند فاصله بین مدلهای دادهعمومی و سیستمهای رباتیک اختصاصی را بیش از پیش کاهش دهد.
گام بعدی شما
- بررسی نقاط بازرسی مدل در Hugging Face برای تست روی شبیهسازهای رباتیک.
- مطالعه پروتکل LeRobot برای پیادهسازی استنتاج غیرهمزمان (Async-inference).
- آزمایش اثر توکنهای ثبتکننده بر روی مدلهای VLM بزرگتر برای کاهش لرزش در تسکهای صنعتی.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو