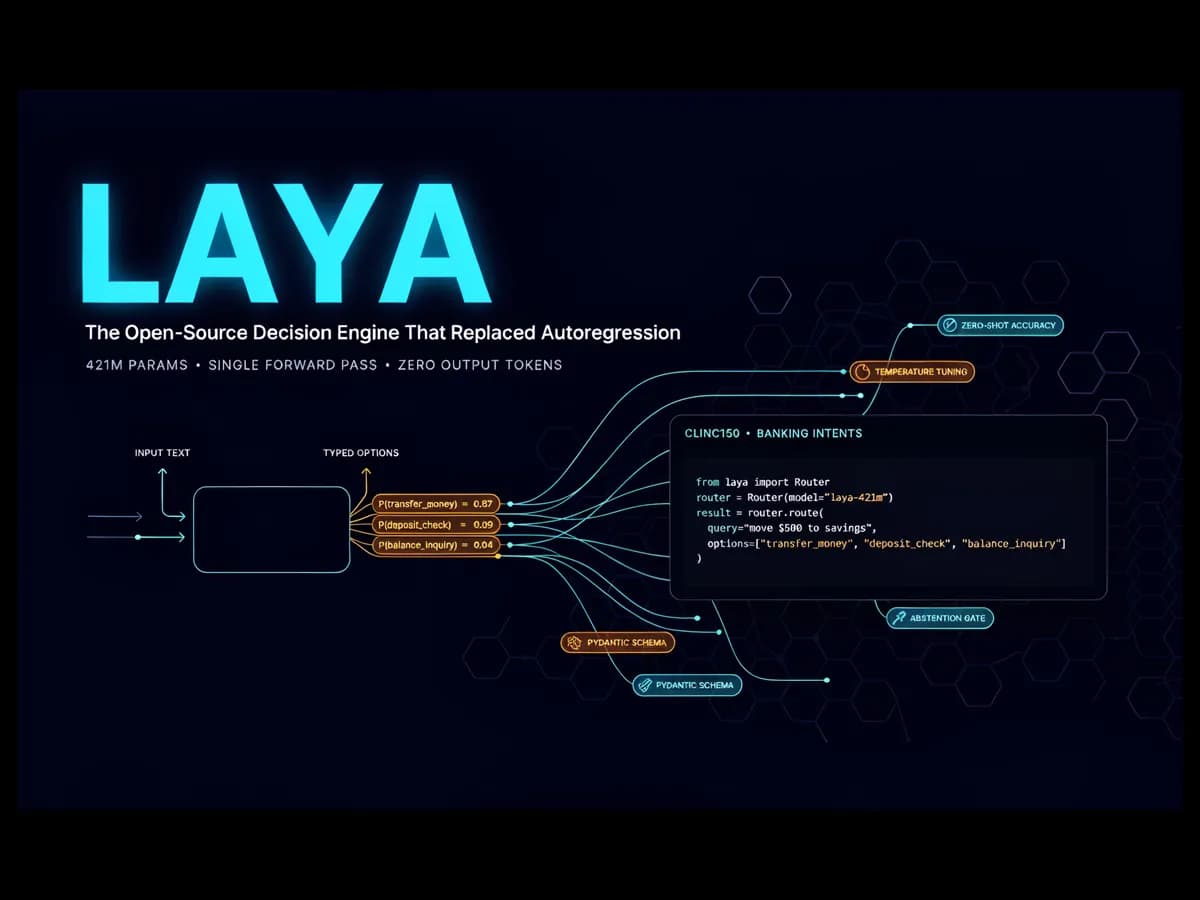
تصور کنید یک سیستم پشتیبانی مشتریان بتواند بدون حتی یک نمونه آموزشی، تیکتهای پیچیده را با دقت ۸۷.۸٪ به بخشهای مربوطه ارجاع دهد. این ادعای جسورانه متعلق به Laya است؛ موتور تصمیمگیری جدیدی که فرآیند کند تولید توکن را بهطور کامل حذف کرده است.
بسیاری از مسیریابهای فعلی بر پایه مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — کار میکنند. این مدلها برای پاسخ دادن باید متن تولید کنند که باعث ایجاد تأخیر (Latency) و عدم قطعیت در فرمت خروجی میشود. اما Laya که توسط Convai Innovations توسعه یافته، مانند یک «سیستم ۱» عمل میکند؛ یعنی بهجای نوشتن پاسخ، از یک رمزگذار (Encoder) با ۴۲۱ میلیون پارامتر استفاده میکند تا احتمال مربوط به هر برچسب را بهصورت ریاضی و آنی محاسبه کند. این رویکرد، Laya را به جایگزینی متنباز برای Jev شرکت TypeSafe تبدیل کرده است که در مقایسههای پیشین، جایگزینی بهینه برای APIهای بسته و گرانقیمت معرفی شد.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی استنتاج در مدلهای کوچک اشاره کردیم، حذف لایههای تولیدی، سرعت را بهشدت افزایش میدهد. طبق مستندات فنی Laya، این مدل هر پرسش را بهعنوان یک ردیف جفتشده با وضعیت ورودی میبیند. در یک فراخوانی ساده از دستور predict ،این موتور میتواند چندین سؤال مختلف — مثلاً تعیین بخش مربوطه، امتیاز فوریت و احتمال ریزش کاربر — را تنها در یک گذر پیشرو (Forward Pass) پاسخ دهد. این تمرکز بر سرعت استنتاج، یادآور رویکرد مدلهای Jeff در رسیدن به زمان پاسخدهی ۲۲ میلیثانیهای در طبقهبندی صفر-شات است.
بر اساس بررسیهای عملکردی، یک نکته کلیدی در طراحی Laya وجود دارد: سؤالات چندگزینهای بهمراتب ارزانتر از مجموعهای از سؤالات بله/خیر هستند. به نقل از تیم توسعهدهنده، پردازش ۱۶ سؤال بله/خیر روی CPU حدود ۸ برابر بیشتر از یک سؤال چندگزینهای زمان میبرد، حتی اگر آن سؤال ۴۰ گزینه داشته باشد.
برای تضمین بازتولید نتایج، این کتابخانه امکان تثبیت نقطه بازرسی (Checkpoint) را از طریق laya.PINNED_REVISIONS فراهم میکند تا مدل از تغییرات احتمالی در شاخه اصلی Hugging Face اثر نپذیرد. همچنین در محیطهای CUDA، مدل بهطور خودکار از دقت ترکیبی (Mixed Precision) استفاده میکند، اما توسعهدهندگان برای تطبیق دقیق اعداد CPU میتوانند agent.amp_enabled = False را فعال کنند تا محاسبات در حالت fp32 باقی بماند.
در یک محک عملی روی مجموعه داده CLINC150 در حوزه بانکی، Laya با ۱۵ قصد (Intent) مختلف مورد آزمایش قرار گرفت. نتایج بهدستآمده، ضرورت استفاده از مجموعههای داده عظیم برچسبدار را به چالش میکشد:
- عملکرد Zero-shot: مدل تنها با استفاده از توصیفات تکخطی برای هر قصد، به صحت ۸۰.۴٪ رسید.
- بهینهسازی: با جایگزینی توصیفات با نامهای ساده قصدها، صحت به ۸۷.۸٪ افزایش و زمان پردازش نصف شد.
- مقایسه: یک طبقهبندیکننده سنتی (TF-IDF و رگرسیون لجستیک) برای رسیدن به صحت ۸۴.۸٪ به ۱۰ نمونه برچسبدار برای هر قصد نیاز داشت، در حالی که Laya بدون هیچ نمونهای در این سطح عمل کرد.
با این حال، تستها نشان داد که ترتیب قرارگیری نامها تأثیرگذار است؛ تغییر ترتیب گزینهها باعث تغییر ۴.۲٪ در پاسخها شد که نشان میدهد ترتیب استقرار باید دقیقاً مشابه ترتیب تست باشد.
یک هشدار حیاتی در مورد احتمالات خروجی Laya وجود دارد. در نسخه ۰.۳.۲۷، تنظیمات دمای (Temperature) — که مثل پیچ تنظیم میزان ریسکپذیری مدل در انتخاب جواب است — بهگونهای است که مدل را بیش از حد مطمئن جلوه میدهد. در بررسی ۴۵۰ پرسش، ۹۲٪ پاسخها با اطمینان بالای ۰.۹ ارائه شدند، اما در واقعیت تنها ۹۱.۱٪ آنها درست بودند. این خطای کالیبراسیون (ECE) را به ۰. IMDb.۱۰۲ رساند. برای رفع این مشکل، توسعهدهندگان باید از تابع agent.fit_temperatures() روی دادههای اعتبارسنجی استفاده کنند تا احتمال خروجی با صحت واقعی مدل همراستا شود. این اهمیت کالیبراسیون را میتوان در تجربیات تنظیم دقیق Laya مشاهده کرد که صحت طبقهبندی تیکتها را از ۱۱٪ به ۸۵٪ رساند.
در محیطهای عملیاتی، ایجاد یک «دروازه امتناع» (Abstention Gate) توصیه میشود تا مدل در صورت پایین بودن اطمینان، پاسخ «نمیدانم» بدهد. برای مثال، با تعیین آستانه 0.602، سیستم توانست ۸۹.۳٪ از درخواستهای خارج از حوزه بانکی را بهدرستی شناسایی و رد کند، هرچند ۷.۸٪ از درخواستهای معتبر بانکی را بهاشتباه رد کرد.
در نهایت، Laya از طریق طرحهای Pydantic با کدهای برنامهنویسی ادغام میشود. این یعنی خروجیهای ریاضی مدل مستقیماً به اشیاء معتبر پایتون تبدیل میشوند. اگر اطمینان مدل پایین باشد، فیلد مربوطه مقدار None میگیرد که سیگنالی برای ارجاع درخواست به اپراتور انسانی است.
گام بعدی شما
- اگر از LLMهای گرانقیمت برای مسیریابی تیکتها استفاده میکنید، Laya را با نامهای ساده (Bare Names) بهجای توصیفات طولانی تست کنید.
- برای جلوگیری از اعتماد کاذب به مدل، حتماً تابع
fit_temperaturesرا روی دادههای اعتبارسنجی خود اجرا کنید. - از
laya[serve]برای راهاندازی سریع یک سرور HTTP جهت تست اولیه استفاده کنید.
اما این تنها بخشی از تغییر پارادایم در استنتاج است؛ برای درک اینکه چگونه مدلهای کوچکتر در حال بلعیدن سهم بازار مدلهای غولپیکر میشوند، تحلیل ما درباره مدلهای SLM را بخوانید.



گفتگو