تصور کنید دستیاری دارید که نهتنها کد مینویسد، بلکه با دیدن یک ضبط صفحه از باگ نرمافزار و شنیدن یادداشت صوتی شما، کل پروژه را تحلیل کرده و خطا را برطرف میکند. این همان وعدهٔ مدل جدید متا است که مرز بین «پیشنهاد کد» و «مدیریت پروژه» را از بین میبرد. مدل Muse Spark Open به توسعهدهندگان اجازه میدهد تا عیبیابی را با تغذیه همزمان یک یادداشت صوتی، یک ضبط صفحه از باگ و کل کدبیس (Codebase) بهطور خودکار انجام دهند.
متا (Meta) در ۱۵ اکتبر ۲۰۲۶، مدل Muse Spark Open را معرفی کرد؛ یک مدل پیشرو با وزنهای باز (Open Weights) — شبیه به دستور پخت غذایی که علناً منتشر شده تا هر کسی بتواند آن را در آشپزخانهٔ خود بپزد — که بهطور خاص برای کدنویسی عاملمحور (Agentic) و جریانهای کاری چندمرحلهای بهینهسازی شده است. این مدل دارای ۸۱۶ میلیارد پارامتر است.
این عرضه نشاندهنده بازگشت تهاجمی متا به رقابت مدلهای باز است تا مستقیماً با رقبایی چون Qwen، GLM و Kimi مقابله کند. همانطور که در تحلیل قبلی ما دربارهی نگرانیهای حریم خصوصی در عاملهای Muse اشاره کردیم، تمرکز متا اکنون از دسترسی به دادههای کاربر به نمایش قدرت خام معماری مدل تغییر کرده است. هدف نهایی Muse Spark Open ایجاد دستیاری است که نهتنها یک خط کد پیشنهاد دهد، بلکه یک بازسازی (Refactor) چندفایلی را برنامهریزی کند، نتیجه را از طریق اسکرینشات مشاهده نماید و بر اساس خطای کامپایلر، خود را اصلاح کند. این حرکت در حالی صورت میگیرد که اپلیکیشن Muse متا پیش از این با استقبال گستردهای در بازار آمریکا و کانادا روبرو شده بود و اکنون با مدلهای باز، گام در مسیر توسعهدهندگان حرفهای برمیدارد.
معماری و مقیاس
طبق مستندات فنی، Muse Spark Open یک مدل ترکیب خبرهها (Mixture of Experts یا MoE) — شبیه به تیمی از متخصصان که برای هر سؤال فقط باهوشترین فرد تیم فراخوانده میشود — با مجموع ۸۱۶ میلیارد پارامتر است. با وجود این حجم عظیم، در هر توکن تنها ۴۲ میلیارد پارامتر فعال میشوند تا سرعت مدل حفظ شود و در عین حال دانش یک مدل غولپیکر را به همراه داشته باشد.
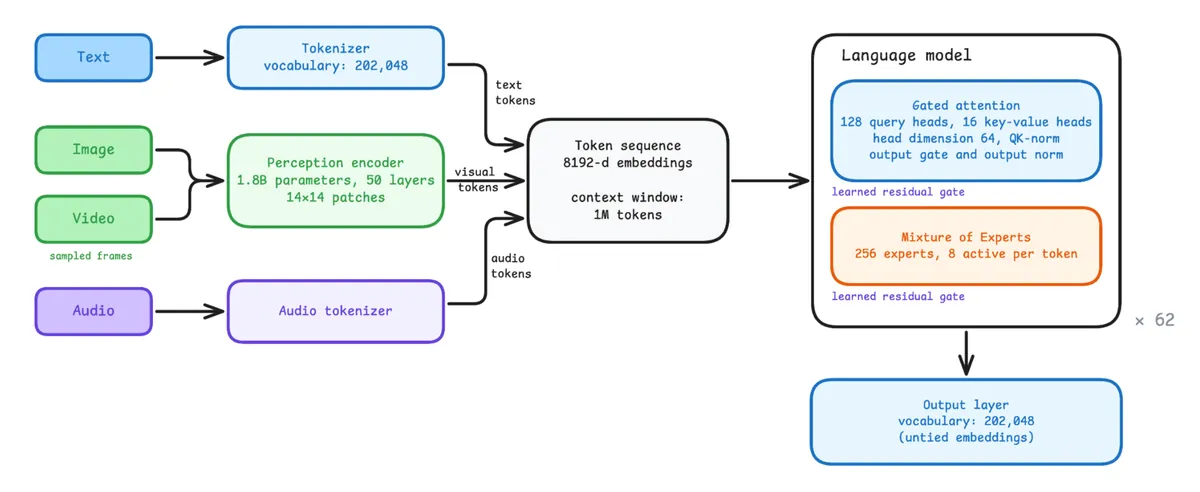
این مدل دارای ۶۲ لایه و بُعد پنهان ۸۱۹۲ است. هر بلوک MoE شامل ۲۵۶ خبره است که یک مسیریر (Router) برای هر توکن، ۸ خبره را انتخاب میکند. حدود ۹۷٪ از کل پارامترهای مدل در همین بخش خبرهها قرار دارند.
مشخصات فنی بلوک توجه (Attention Block) شامل ۱۲۸ سر پرسوجو (Query Heads) و ۱۶ سر کلید-مقدار (Key-Value Heads) است که از مکانیزم Grouped-Query Attention استفاده میکنند. هر سر دارای ۶۴ بُعد است. این بلوک از یک گیت خروجی، یک لایه نرمالسازی خروجی و QK-norm (نرمالسازی اعمال شده بر پرسوجوها و کلیدها) بهره میبرد. برخلاف جمعهای ساده، هر بلوک ورودی و خروجی را از طریق یک گیت باقیمانده (Residual Gate) یادگرفتهشده ترکیب میکند.
در سلسلهمراتب مدلهای Muse، نسخه Spark Open مدل کامل است و مدل کوچکتر Muse Glimmer که در اوت منتشر شد، یک مدل متراکم (Dense) کوچک است که برای اجراهای محلی ایدهآل است. هر دو مدل از یک توکنساز (Tokenizer) — شبیه به قیچیای که متن را به تکههای کوچک و قابلفهم برای مدل میبرد — و واژگان مشترک هستند، هرچند Spark Open از یک قالب چت بر پایه Glimmer با افزودنیهایی برای مودالیتههای جدید استفاده میکند. در Spark Open، ماتریسهای جاسازی ورودی (Input Embedding) و لایه خروجی جدا هستند و هر کدام حدود ۱.۶۶ میلیارد پارامتر دارند.
برای مدیریت دادههای حجیم، متا پنجره متنی (Context Window) — مثل میز کاری که تعیین میکند مدل در هر لحظه چه مقدار اطلاعات را پیش روی خود دارد — یک میلیون توکنی را پیاده کرده است. این فضا بین متن، تصویر، صوت و ویدیو مشترک است، به این معنی که توکنهای تمام این مودالیتهها در یک فضای حافظه همزیستی میکنند. پیکربندی مدل، مقدار max_position_embeddings را روی ۱,۰۴۸,۵۷۶ تنظیم کرده است. استفاده از Grouped-Query Attention باعث میشود حافظه KV Cache قابل مدیریت بماند؛ هر توکن ۱۲۶,۹۷۶ مقدار به حافظه اضافه میکند که در مجموع حدود ۲۵۰ کیلوبایت برای هر توکن و ۲۶۶ گیگابایت برای یک کانتکست کامل یک میلیون توکنی در فرمت BF16 است.
ادراک چندوجهی
این مدل از یک رمزگذار ادراکی (Perception Encoder) اختصاصی با ۱.۸ میلیارد پارامتر برای پردازش دادههای بصری استفاده میکند. این رمزگذار تصاویر را به قطعات (Patches) ۱۴ در ۱۴ تقسیم کرده و ویژگیهای ۴۰۹۶ بُعدی تولید میکند و در ۵۰ لایه خود از ترکیبی از توجه کامل (Full Attention) و توجه پراکنده (Sparse Attention) استفاده میکند. این رمزگذار دارای بُعد پنهان ۱۵۳۶ و ۱۶ سر توجه است و در شبکههای پیشخور (Feed-forward) خود از LayerNorm و GELU بهره میبرد. اطلاعات موقعیتی از طریق 2D RoPE و جاسازیهای مطلق یادگرفتهشده مدیریت میشوند.
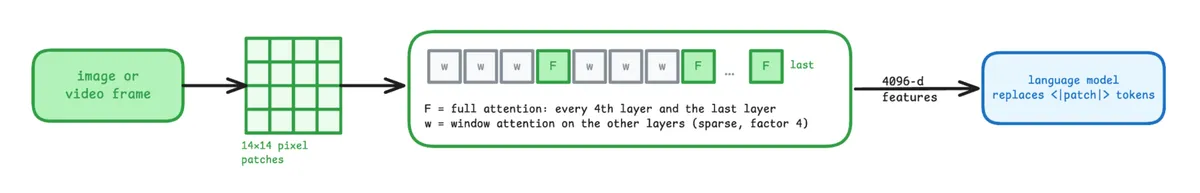
در این معماری، هر لایه چهارم و لایه نهایی رمزگذار ادراکی از توجه کامل استفاده میکنند، در حالی که سایر لایهها از توجه پراکنده بهره میبرند. این طراحی از کارهای قبلی متا در زمینه Perception Encoder پیروی میکند و همان معماری است که در مدل Muse Glimmer 30B به کار رفته است.
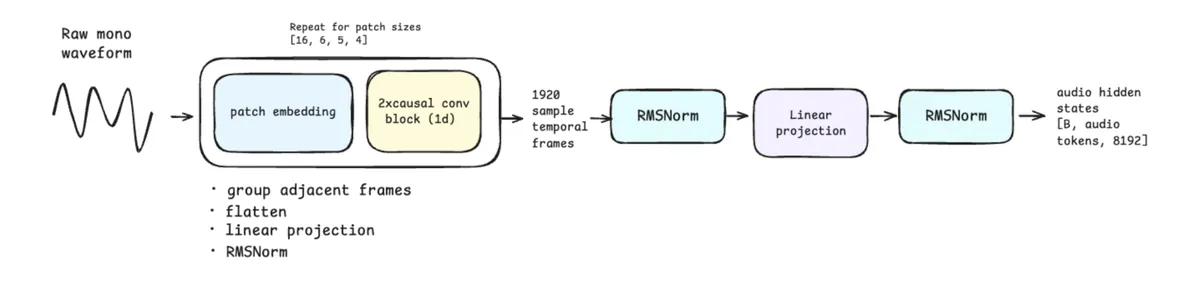
در مورد صوت، یک رمزگذار هرمی کانولوشنال (Convolutional Pyramid Encoder) استفاده شده که موجهای صوتی خام را با نرخ ۱۲.۵ توکن در ثانیه (یک توکن هر ۸۰ میلیثانیه) تبدیل میکند. برای مثال، یک کلیپ ۱۰ ثانیهای به ۱۲۵ توکن ورودی تبدیل میشود. این رمزگذار شامل مراحلی با جاسازیهای قطعهای (Patch Embedders) در اندازههای [۱۶، ۶، ۵، ۴] و دو بلوک کانولوشنال با هستههای یکبعدی (اندازه ۷، گام ۱) است. مرحله نهایی از توالی RMSNorm $\rightarrow$ تصویرسازی خطی $\rightarrow$ RMSNorm استفاده میکند.
ورودیهای ویدئویی نیز به صورت توالیهایی از فریمهای تصویری با استفاده از همان رمزگذار تصاویر پردازش میشوند. بهطور پیشفرض، پردازشگر ویدیوها را با نرخ ۲ فریم در ثانیه (FPS) نمونهبرداری میکند و سقف آن ۹۶ فریم است، هرچند توسعهدهندگان میتوانند این نرخ را برای دقت بیشتر افزایش دهند، هرچند این کار باعث افزایش تأخیر (Latency) و مصرف حافظه میشود. فریمها با برچسبهای زمانی متنی (مثلاً "Time: 3.5s") در هم تنیده میشوند.
استقرار و سختافزار
اجرای مدلی در این مقیاس به سختافزار قدرتمندی نیاز دارد. نقطه بازرسی (Checkpoint) در فرمت BF16 و قالب safetensors حدود ۱.۵ ترابایت حجم دارد. در یک تنظیمات استاندارد Transformers، این مدل به ۴ گره شامل ۸ پردازنده GPU H200 با استفاده از موازیسازی تنسور (TP=32) نیاز دارد.
برای کاربران تراشههای NVIDIA Blackwell، متا نسخه NVFP4 را ارائه داده است. این نسخه با دقت ۴ بیتی اجازه میدهد مدل روی یک گره B200 با افت دقت ناچیز اجرا شود. مخازن این نقاط بازرسی با نامهای Muse-Spark-Open-816B-A42B و Muse-Spark-Open-816B-A42B-NVFP4 نامگذاری شدهاند.
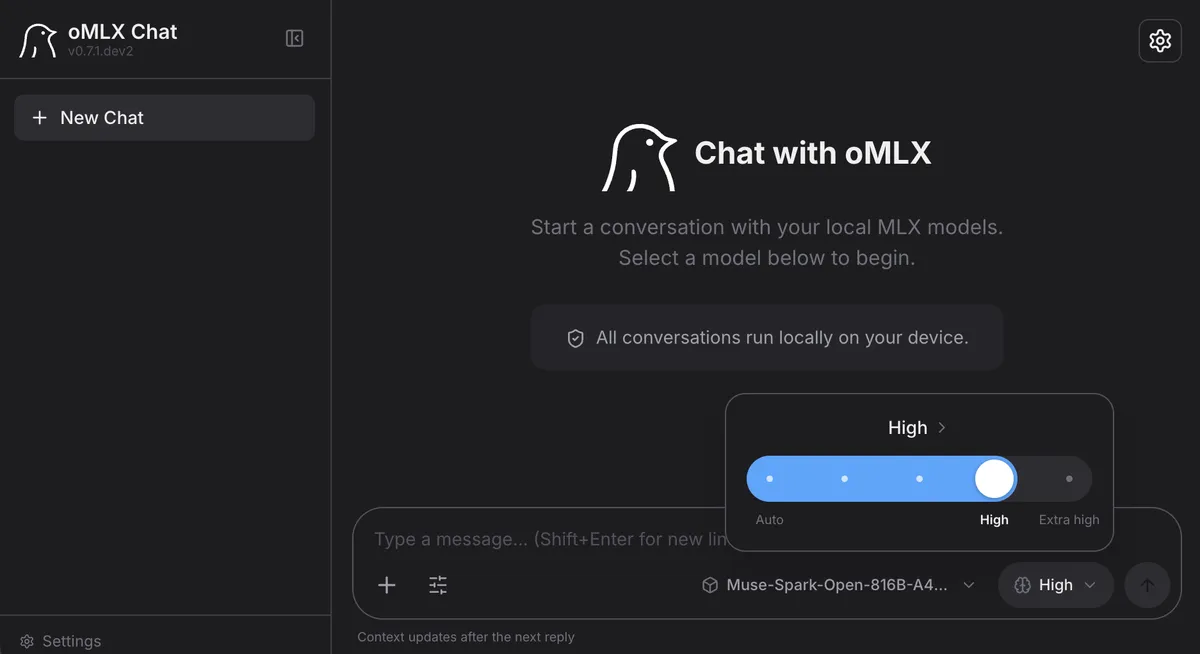
استقرار محلی از طریق لاماسیپلاسپلاس (llama.cpp) نیز ممکن است. بر اساس گزارشهای فنی، روی یک مک M3 Ultra با ۵۱۲ گیگابایت رم، نسخه کوانتیده ۲ بیتی با سرعت ۱۸ توکن در ثانیه اجرا میشود و ۳۰۴ گیگابایت از حافظه را اشغال میکند. به همین ترتیب، oMLX از کوانتهای ۳ بیتی و ۴ بیتی پشتیبانی میکند. نسخه oQ3e حدود ۳۴۴ گیگابایت رم مصرف کرده و برای یک پرامپت ۱۰۲۴ توکنی و تولید ۱۲۸ توکن، به سرعت پیشخوانی (Prefill) ۲۲۵ توکن بر ثانیه و سرعت تولید ۲۱ توکن بر ثانیه دست مییابد.
چارچوبهای استنتاج و پشتیبانی
متا مسیرهای مختلفی را برای سرویسدهی مدل فراهم کرده است:
- SGLang: پشتیبانی کامل از متن، تصویر، صوت و ویدیو. پیکربندی مرجع NVFP4 روی چهار GPU GB300 اجرا میشود. این چارچوب از یک قالب چت خاص (
muse_spark_1_2_oss.jinja) استفاده کرده و ردپای استدلال را درreasoning_contentاز پاسخ نهایی درcontentجدا میکند. - vLLM: پشتیبانی از متن و تصویر با استفاده از نقطه بازرسی NVFP4 روی پردازندههای Blackwell. یک پیکربندی مرجع، کانتکست سرویسدهی را روی ۱۲۸ هزار توکن (
max-model-len 131072) تنظیم کرده و از پلاگین تخصصیmusespark1x_modelsبرای پیادهسازی مدل و تجزیهکننده استدلال استفاده میکند. - Hugging Face Inference Endpoints: ارائه دستورالعملهای پیشتأیید شده SGLang. کاربران میتوانند ۸ عدد NVIDIA RTX Pro 6000 (با ۹۸ گیگابایت حافظه) را برای کانتکست ۱۲۸ هزار توکنی، یا ۸ عدد NVIDIA H200 (با ۱۴۱ گیگابایت حافظه) را برای کانتکست کامل ۱,۰۴۸,۵۷۶ توکنی انتخاب کنند.
- Transformers: استفاده از کلاس
MuseSparkForConditionalGenerationبرای تولید محتوا وMuseSparkProcessorبرای آمادهسازی گفتگوها. این پردازشگر، توکنساز، پردازشگرهای تصویر/ویدیو و استخراجکننده ویژگیهای صوتی را با هم ترکیب میکند.
قابلیتهای عاملمحور و استفاده از ابزار
این مدل برای «کدنویسی عاملمحور» آموزش دیده است؛ یعنی میتواند کدها را بخواند، توابع بنویسد و ابزارهای خارجی را فراخوانی کند. متا از قالب چت مبتنی بر کانال به نام Harmony استفاده کرده که زنجیره تفکر (Chain-of-Thought) — شبیه به دانشآموزی که مراحل حل مسئله ریاضی را بلندبلند میگوید تا به جواب برسد — را از پاسخ نهایی جدا میکند.
مدل هنگام استدلال، پیامها را به کانال to=self میفرستد تا قبل از پاسخ به کاربر، روی مسئله فکر کند. این فرآیند استدلال را نمیتوان خاموش کرد، اما «میزان تلاش» (Effort) را میتوان از low تا xhigh تنظیم کرد. این سطوح نمادین به اعداد ۱۶ (low)، ۶۴ (medium)، ۲۵۶ (high) و ۵۱۲ (xhigh) نگاشت میشوند. کاربران همچنین میتوانند شدت استدلال را از طریق پرامپت سیستم (مثلاً "Reasoning strength: 1") تعیین کنند.
فراخوانی ابزارها از طریق مسیریابیهای خاص انجام میشود. برای مثال، فراخوانی ابزار آبوهوا به صورت <|start|>assistant to=weather.get<|message|><atem:function_calls><atem:invoke name="weather.get"><atem:parameter name="city">San Francisco</atem:parameter></atem:invoke></atem:function_calls><|eot|> تجزیه میشود. این سیستم هم از فراخوانی ابزارهای متنی و هم از ابزارهای چندوجهی پشتیبانی میکند.
تنظیم دقیق و عملکرد
توسعهدهندگان میتوانند مدل را با استفاده از SFTTrainer در کتابخانه TRL تنظیم دقیق (Fine-tuning) — مثل وقتی که به یک پزشک عمومی، تخصص پوست میدهیم تا در یک حوزه خاص خبره شود — کنند. متا در یک تست روی ۶۴ پردازنده H100 (۸ گره ۸ تایی)، آداپتورهای لورا (LoRA) را روی لایههای توجه (q_proj, k_proj, v_proj, o_proj) آموزش داد در حالی که بخش خبرهها ثابت (Frozen) ماند.
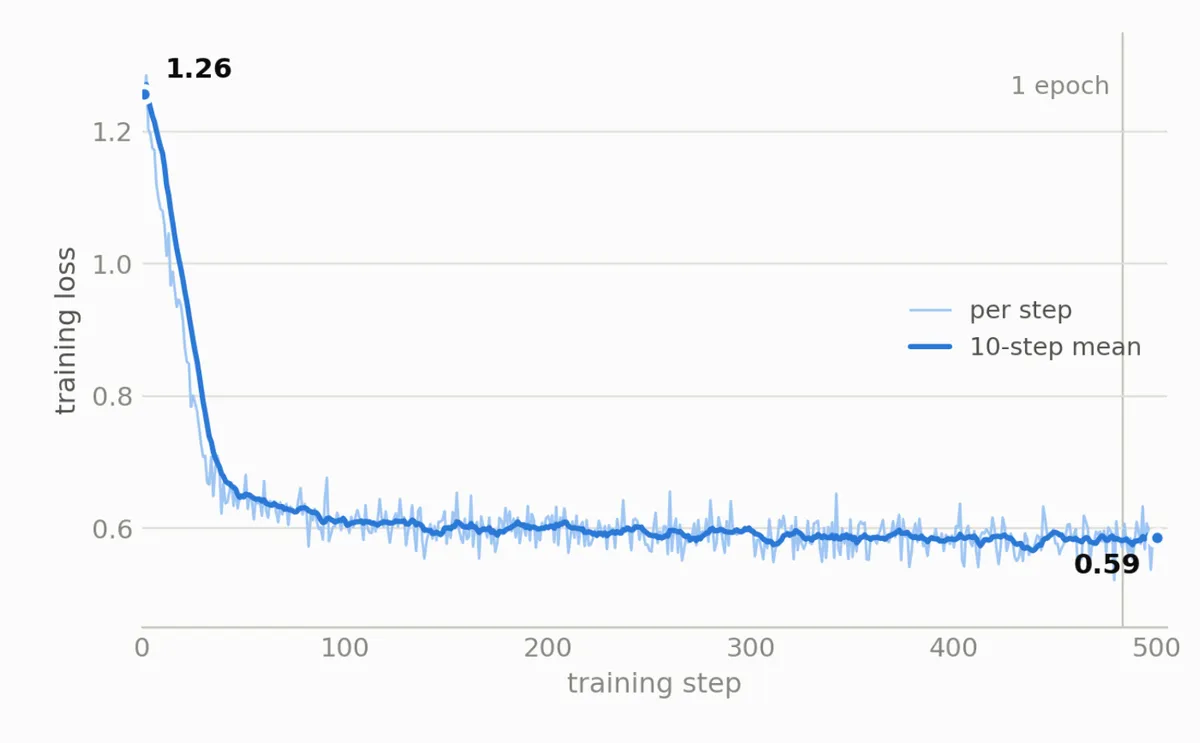
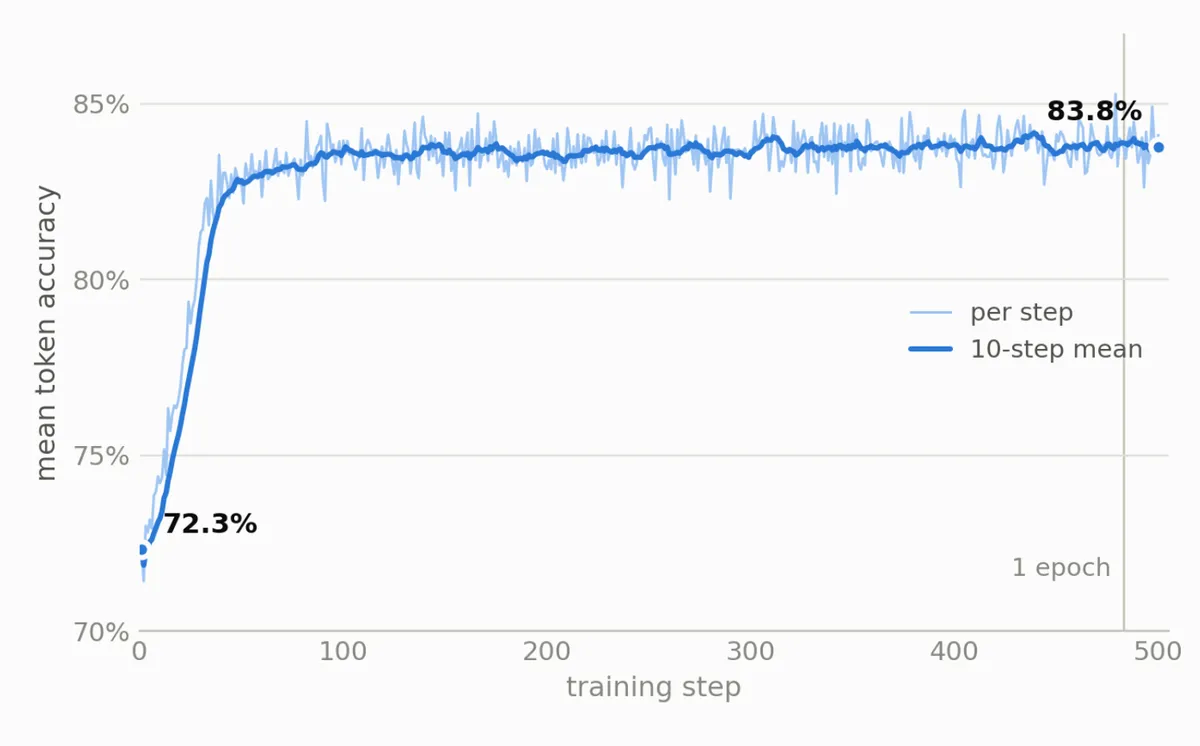
این فرآیند آموزش تنها دو ساعت زمان برد و توانست ۸,۰۰۰ توکن را در ثانیه پردازش کند. در این تنظیمات از fsdp_size=64 برای تکهتکه کردن مدل و ep_size=8 برای تقسیم ۲۵۶ خبره به ۸ گروه استفاده شد. نتایج نشان داد که صحت میانگین توکنها از ۷۲٪ به ۸۴٪ افزایش یافت و تابع زیان (Loss) از ۱.۲۶ به ۰.۵۷ کاهش یافت.
دموهای دنیای واقعی
متا قدرت این مدل را در سه کاربرد عملی نشان داد:
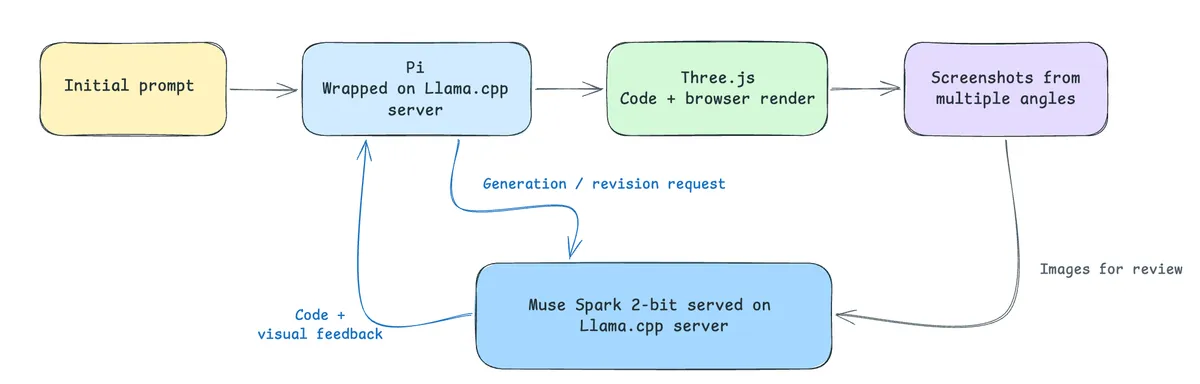
- تولیدکننده داراییهای سهبعدی: در ترکیب با عامل کدنویسی Pi، مدل کدهای Three.js را مینویسد، آنها را در مرورگر رندر میکند، از زوایای مختلف اسکرینشات میگیرد و بر اساس بازخورد بصری، دارایی را بهطور تکرار شونده اصلاح میکند. این دمو روی مک Ultra با سرعت ۱۸ توکن در ثانیه اجرا میشود.
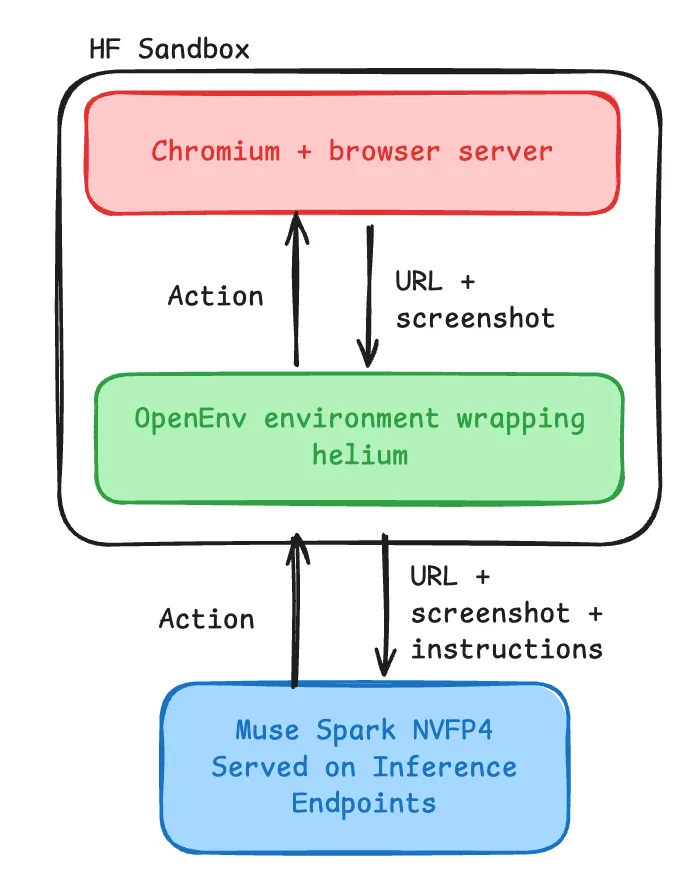
- عامل مرورگر: با استفاده از OpenEnv و سندباکسهای Hugging Face، مدل میتواند تنها با دیدن اسکرینشاتها (بدون دسترسی به کد HTML/DOM) در وب گشتوگذار کند. مدل در یک حلقه عمل میکند که در آن اقدامات قبلی، پرامپت سیستم، URL و یک اسکرینشات را میبیند تا اقدام بعدی را انجام دهد. این دمو از Helium و Selenium برای عملیاتی مثل کلیک، تایپ و اسکرول استفاده میکند.
- عامل خرید چندوجهی: فضایی که صوت، تصویر و ویژگیهای عاملمحور را ترکیب میکند. مدل ورودی صوتی را میگیرد، درباره توصیف محصول استدلال میکند، در آمازون جستوجو کرده و بر اساس معیارهای بصری، بهترین گزینه را انتخاب میکند.
چشمانداز رقابتی
به گزارش وبسایت the-decoder.com، متا ادعا میکند Muse Spark Open در محکهای JobBench و ZeroBench از مدلهای Qwen 3.8، GLM 5.3 و Kimi K3 پیشی گرفته است، هرچند هنوز از مدلهای بسته و پیشرو خود متا ضعیفتر است. در دنیای مدلهای باز، تلاش برای بهینهسازی هزینهها ادامه دارد و ابزارهایی مانند Together Link اکنون امکان کاهش چشمگیر هزینههای مدلهای کدنویسی را فراهم کردهاند تا دسترسی به این قدرت محاسباتی تسهیل شود.
این عرضه نشاندهنده چرخش اکوسیستم مدلهای باز از «چتباتهای عمومی» به سمت «عاملهای چندوجهی متخصص» است که میتوانند عملاً یک کامپیوتر را کنترل کنند. برای کاربر نهایی، این بدان معناست که مانع ساخت یک عامل محلی سفارشی که بتواند جریان کاری شما را «ببیند» و «بشنود»، بهشدت کاهش یافته است، به شرطی که سختافزار لازم را داشته باشید.
گام بعدی شما
- اگر سختافزار لازم را دارید، نسخه NVFP4 را از طریق Hugging Face Inference Endpoints (با ۸ عدد RTX Pro 6000 برای کانتکست ۱۲۸ هزار یا ۸ عدد H200 برای کانتکست ۱ میلیون) مستقر کنید.
- برای تستهای محلی روی مک، نسخههای GGUF را از طریق llama.cpp دانلود کنید.
- قابلیتهای Harmony را برای جداسازی تفکر مدل از پاسخ نهایی در جریانهای کاری کدنویسی خود پیاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو