اگر در حال ساخت عاملهای هوش مصنوعی هستید، احتمالاً با مشکل فراموشی جزئیات در گفتگوهای طولانی دستوپنجه نرم میکنید. موتور حافظه NylonME با رسیدن به نرخ بازیابی پاسخ نهایی ۸۴.۶٪ در محک LoCoMo، ثابت کرد که برای داشتن حافظهای دقیق، نیازی به مدلهای بزرگتر نیست و تنها یک معماری منظم کفیت میکند. این نتیجه نشان میدهد که شکاف بین بازیابی دادههای خام و حافظه کاربردی برای یک عامل هوشمند را میتوان از طریق انضباط معماری پر کرد، نه صرفاً با افزایش اندازه مدلها.
این دستاورد بر اساس ارزیابیهای تکرارپذیر روی ۱,۵۳۶ جفت پرسشوپاسخ با استفاده از بازیابی ترکیبی لکسیکال و برداری (lexical+vector fused retrieval) و معیار recall@10 به دست آمده است. همانطور که در پوشش پیشین ما از Muninn Memory Engine دیدیم، تمرکز آن پروژه بر کاهش تأخیر در حالی بود که دقت حفظ شود، اما NylonME مستقیماً روی «صحت بازیابی شواهد» متمرکز شده است تا هیچ جزئیاتی در مسیر تبدیل دادهها گم نشود. در حالی که Muninn سرعت حلقه حافظه را بهینه میکرد، NylonME بر یکپارچگی ساختاری نحوه نوشتن و بازیابی خاطرات تمرکز دارد. این رویکرد در واقع پاسخی به چالشهای مشابهی است که در مقایسه معماریهای حافظه Mem0، Zep و Letta بررسی کردیم تا مشخص شود کدام ساختار در دنیای واقعی کارآمدتر است.
برای اکثر توسعهدهندگان، حافظه در عاملهای هوش مصنوعی — شبیه به یک دفترچه یادداشت نامرتب است که مدل مدام بخشهای مهم آن را فراموش میکند — یک چالش دائمی است. NylonME این مشکل را با تبدیل مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — به یک «کامپایلر» حل میکند؛ یعنی مدل حافظهها را در لحظه نوشتن سازماندهی میکند، نه اینکه سعی کند در مرحله پرسش و کوئری، معنای آنها را کشف کند.
مسیر رسیدن به ۸۴.۶٪
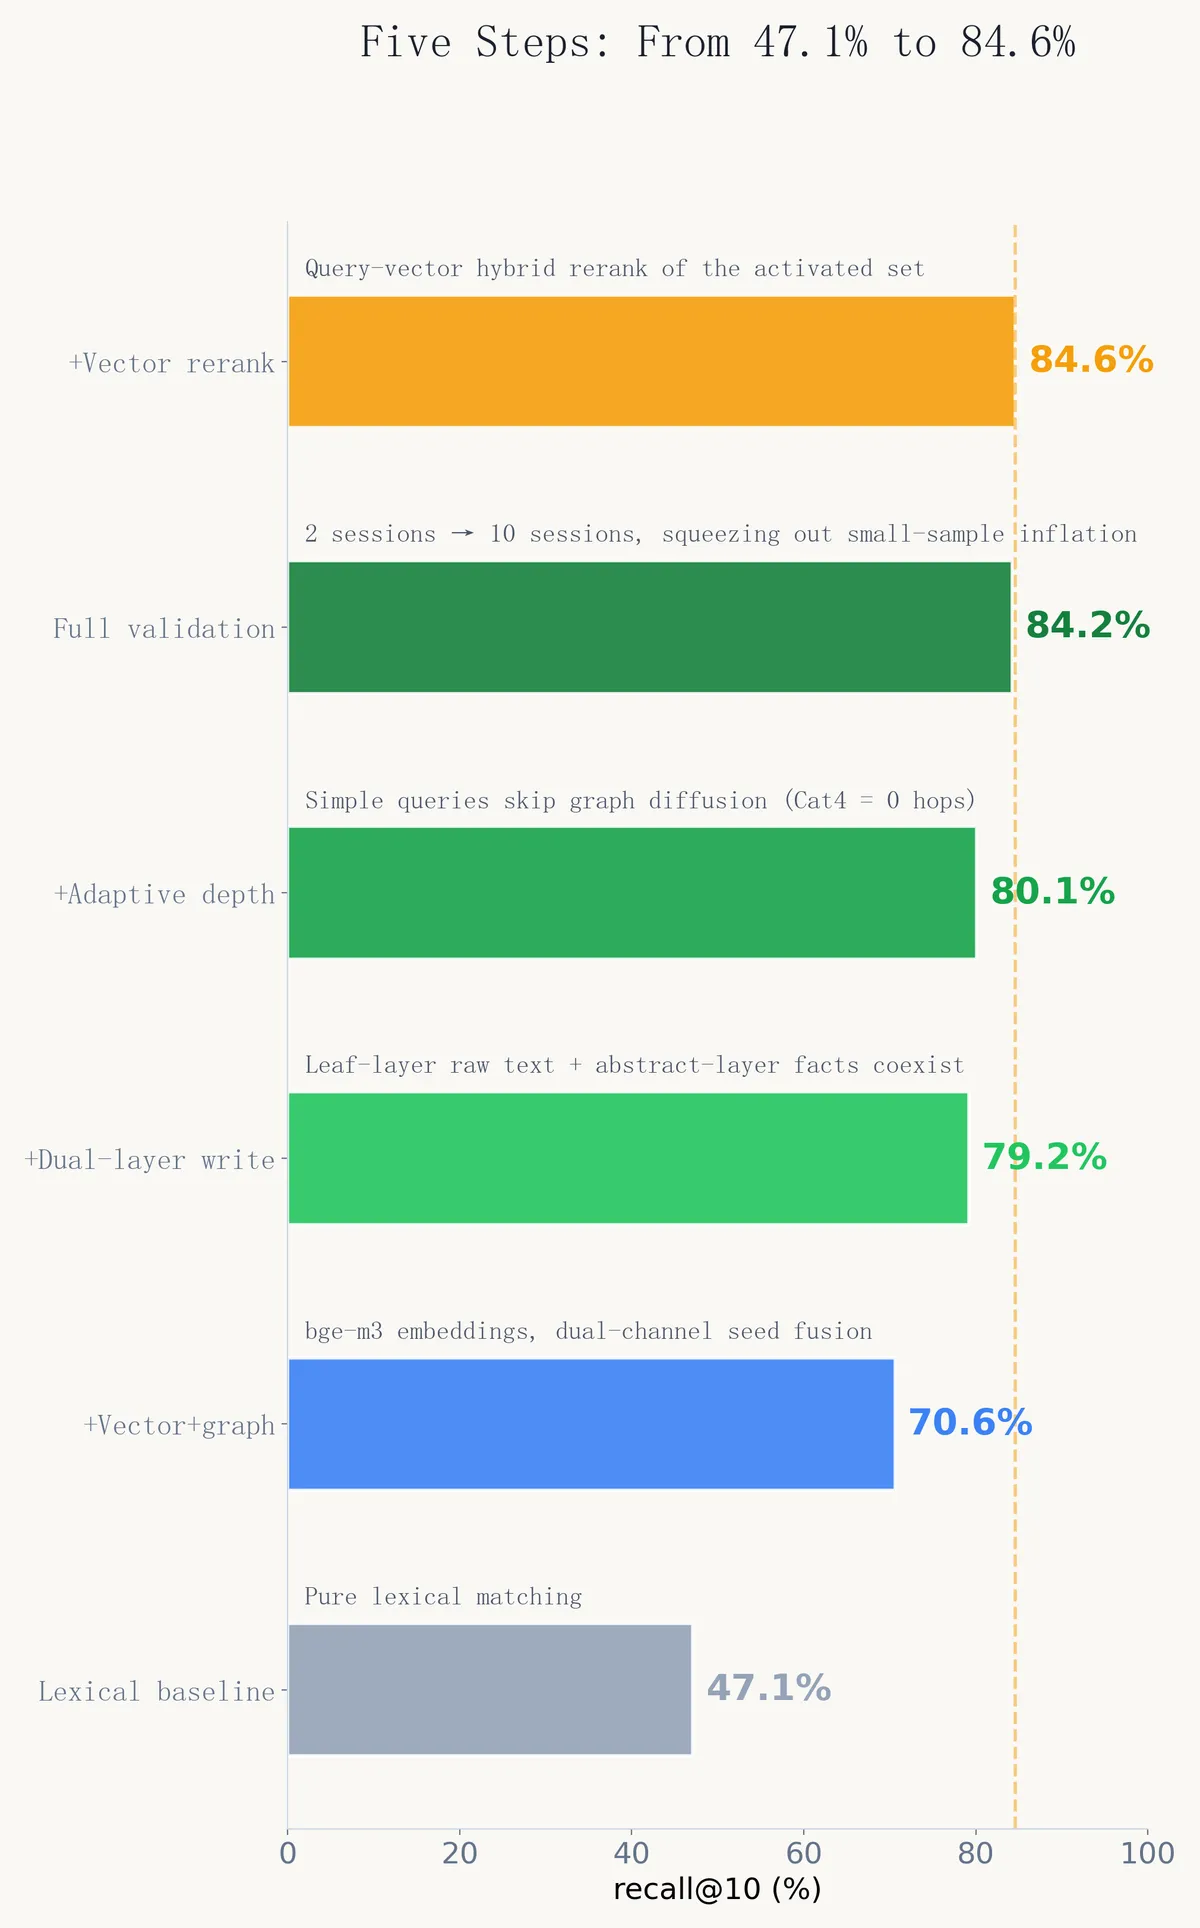
به نقل از گزارش فنی این پروژه، تیم توسعه یک فرآیند بهینهسازی پنجمرحلهای را طی کرد تا از پلههای این محک بالا برود. شروع کار با یک سیستم ساده تطبیق لغوی (pure lexical-matching) بود که فقط کلمات دقیق را جستوجو میکرد. در این حالت، اگر کاربر میپرسید «چه زمانی پرواز را رزرو کردم؟»، سیستم فقط دنبال همین کلمات میگشت و اگر حقایق با عبارات متفاوتی بیان شده بود، آنها را نادیده میگرفت. نتیجه این رویکرد، نرخ بازیابی ضعیف ۴۷.۱٪ بود.
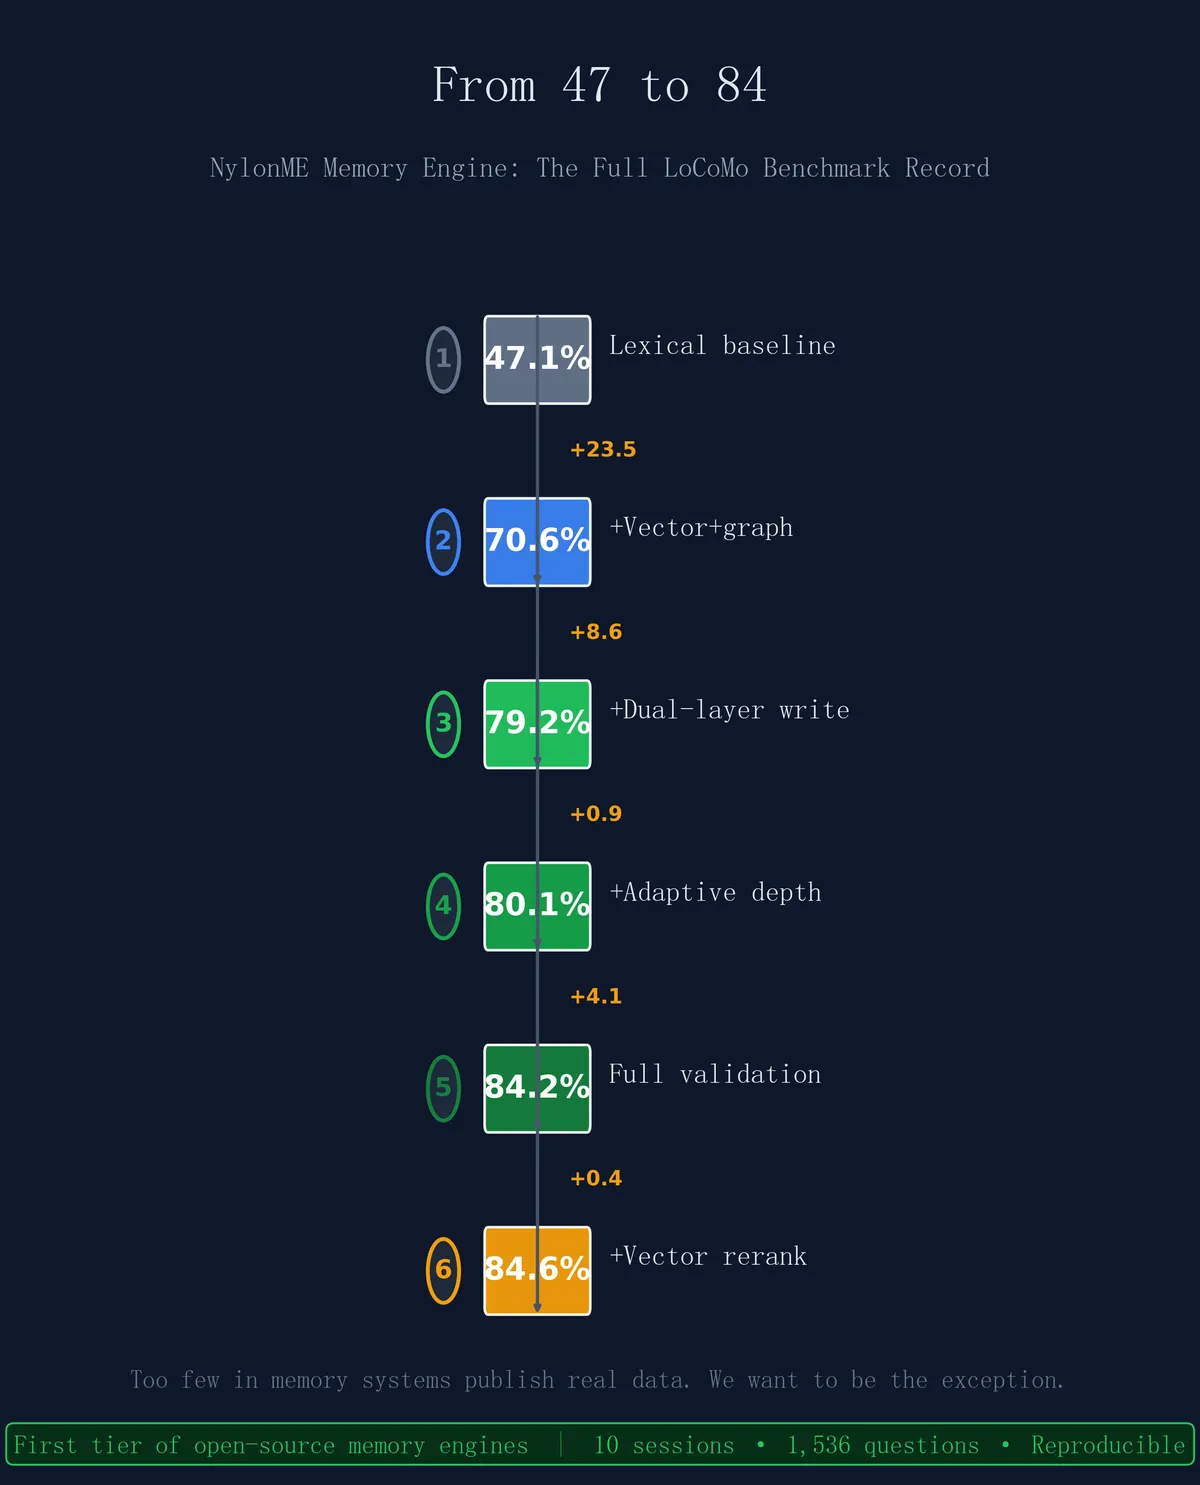
در گام اول، آنها بردار معنایی (Embedding) مدل bge-m3 را با ۱۰۲۴ بُعد، که روی Ollama در یک سیستم اوبونتو در شبکه محلی (LAN) اجرا میشد، پیاده کردند. با ایجاد یک سیستم دوکاناله، جایی که کانال لکسیکال مسئول موجودیتهای دقیق مثل نامها، مکانها و اعداد بود و کانال برداری مسئول تقریبهای معنایی (مثلاً تطبیق «رزرو پرواز» با «خرید بلیط هواپیما به شانگهای») بود، نرخ بازیابی به ۷۰.۶٪ رسید. برای اینکه بذور لکسیکال بر سیستم غالب نشوند، یک سهمیه رزرو شده ۸ جایگاهی برای کانال برداری در نظر گرفته شد.
جهش معماری ذخیرهسازی دو لایه
بحرانیترین تغییر زمانی رخ داد که تیم «نوشتار دو لایه» (dual-layer writes) را اجرا کرد. پیش از این، سیستم صرفاً به حقایق تقطیر شده توسط LLM تکیه میکرد، اما تستهای حذف (ablation tests) نشان داد که این کار در واقع امتیازات را از ۷۹.۲٪ به ۶۷.۳٪ کاهش میدهد؛ زیرا فرآیند distillation (تقطیر داده) ذاتاً باعث حذف اطلاعات میشود.
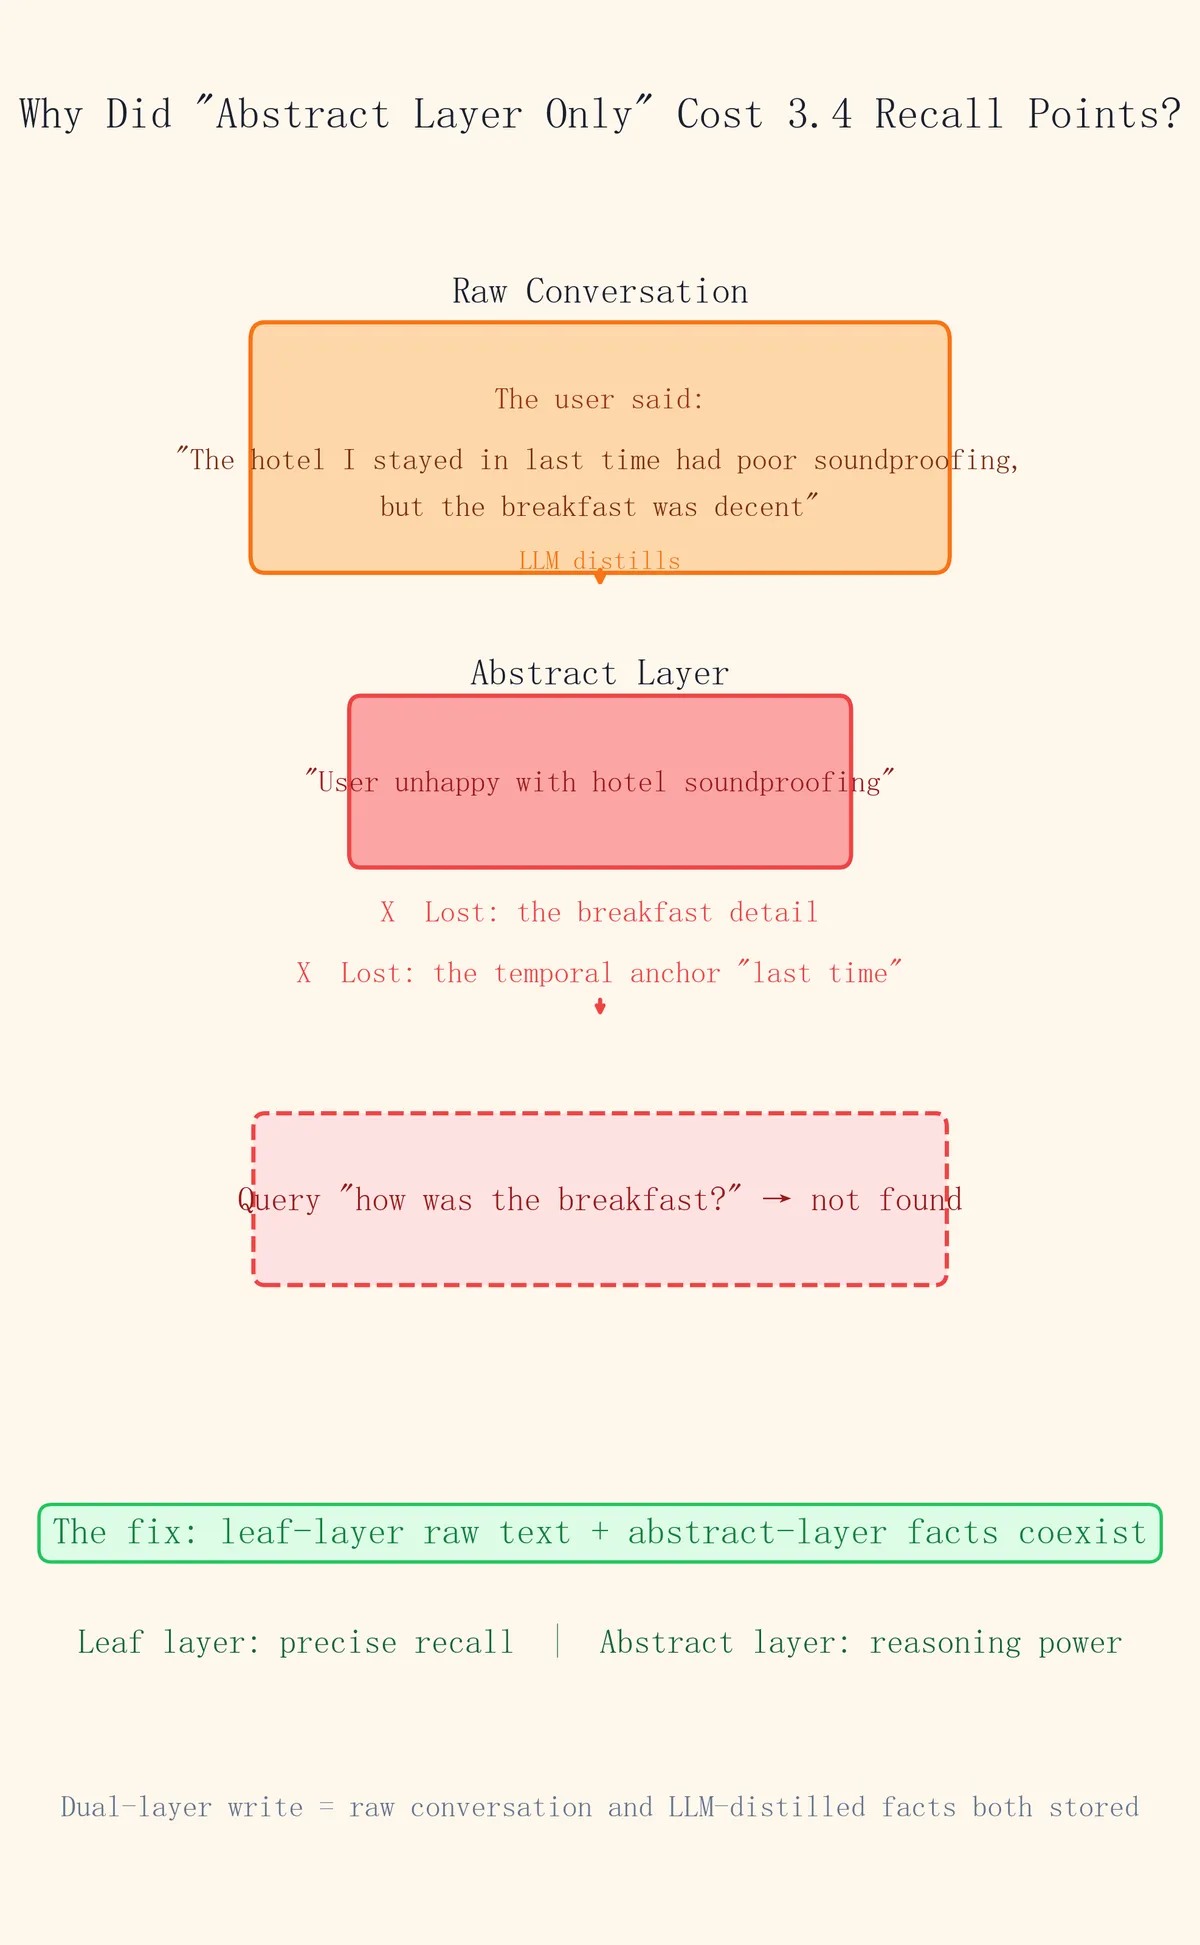
برای مثال، اگر کاربر بگوید «هتلی که دفعه پیش در آن بودم عایق صوتی بدی داشت اما صبحانهاش خوب بود»، یک مدل زبانی ممکن است آن را به «کاربر از عایق صوتی هتل ناراضی بود» تقطیر کند. در این فرآیند، جزئیات مربوط به صبحانه و لنگر زمانی «دفعه پیش» حذف میشوند و هرگونه پرسش بعدی درباره صبحانه نمیتواند پاسخی در لایه انتزاعی پیدا کند.
برای حل این مشکل، NylonME اکنون از دو لایه ذخیرهسازی همزمان استفاده میکند:
- لایه برگ (Leaf Layer): متن خام هر نوبت گفتگو را عیناً و کلمه به کلمه ذخیره میکند. این لایه بازیابی دقیق را حفظ کرده و به عنوان پایه برای سوالات دسته ۲ (زمانی) و دسته ۴ (تکمرحلهای) عمل میکند. این تمرکز بر بازیابی قطعی، یادآور رویکرد سیستم Engrava در مدیریت حافظه است که برای جلوگیری از توهمات مدل، بر لایههای بازیابی قطعی تأکید داشت.
- لایه انتزاعی (Abstract Layer): در پایان هر جلسه، مدل زبانی حقایق ساختاریافته را استخراج کرده و برچسبهای رابطهای (relation tags) را به آنها میچسباند. این لایه قدرت استدلال را برای سوالات دسته ۱ (چندمرحلهای) و دسته ۳ (عقل سلیم) حفظ میکند.
این معماری یک اصل طراحی جدید را تثبیت میکند: لایه درک باید در سمت «نوشتن» باشد، نه «خواندن». در زمان پرسش، هیچ مدل زبانی درگیر نیست و سیستم فقط دادهها را بازیابی میکند؛ در واقع LLM در زمان نوشتن نقش کامپایلر حافظه را ایفا میکند.
رزونانس تطبیقی و مسیریابی
سیستم NylonME از مکانیزمی به نام «رزونانس متنی» (contextual resonance) برای پخش اطلاعات در یک گراف رابطهای استفاده میکند. این فرآیند از گرههای بذر شروع شده، به صورت چندمرحلهای در گراف رابطهای پخش میشود و با افزایش فاصله (تنش)، شدت آن کاهش مییابد. در حالی که این روش برای استدلالهای چندمرحلهای (مثلاً «چیزی که A ذکر کرد چه ارتباطی به کاری دارد که B بعداً انجام داد؟») ضروری است، اما دادهها نشان داد که این یک بهینهسازی منفی برای کوئریهای تکمرحلهای است.
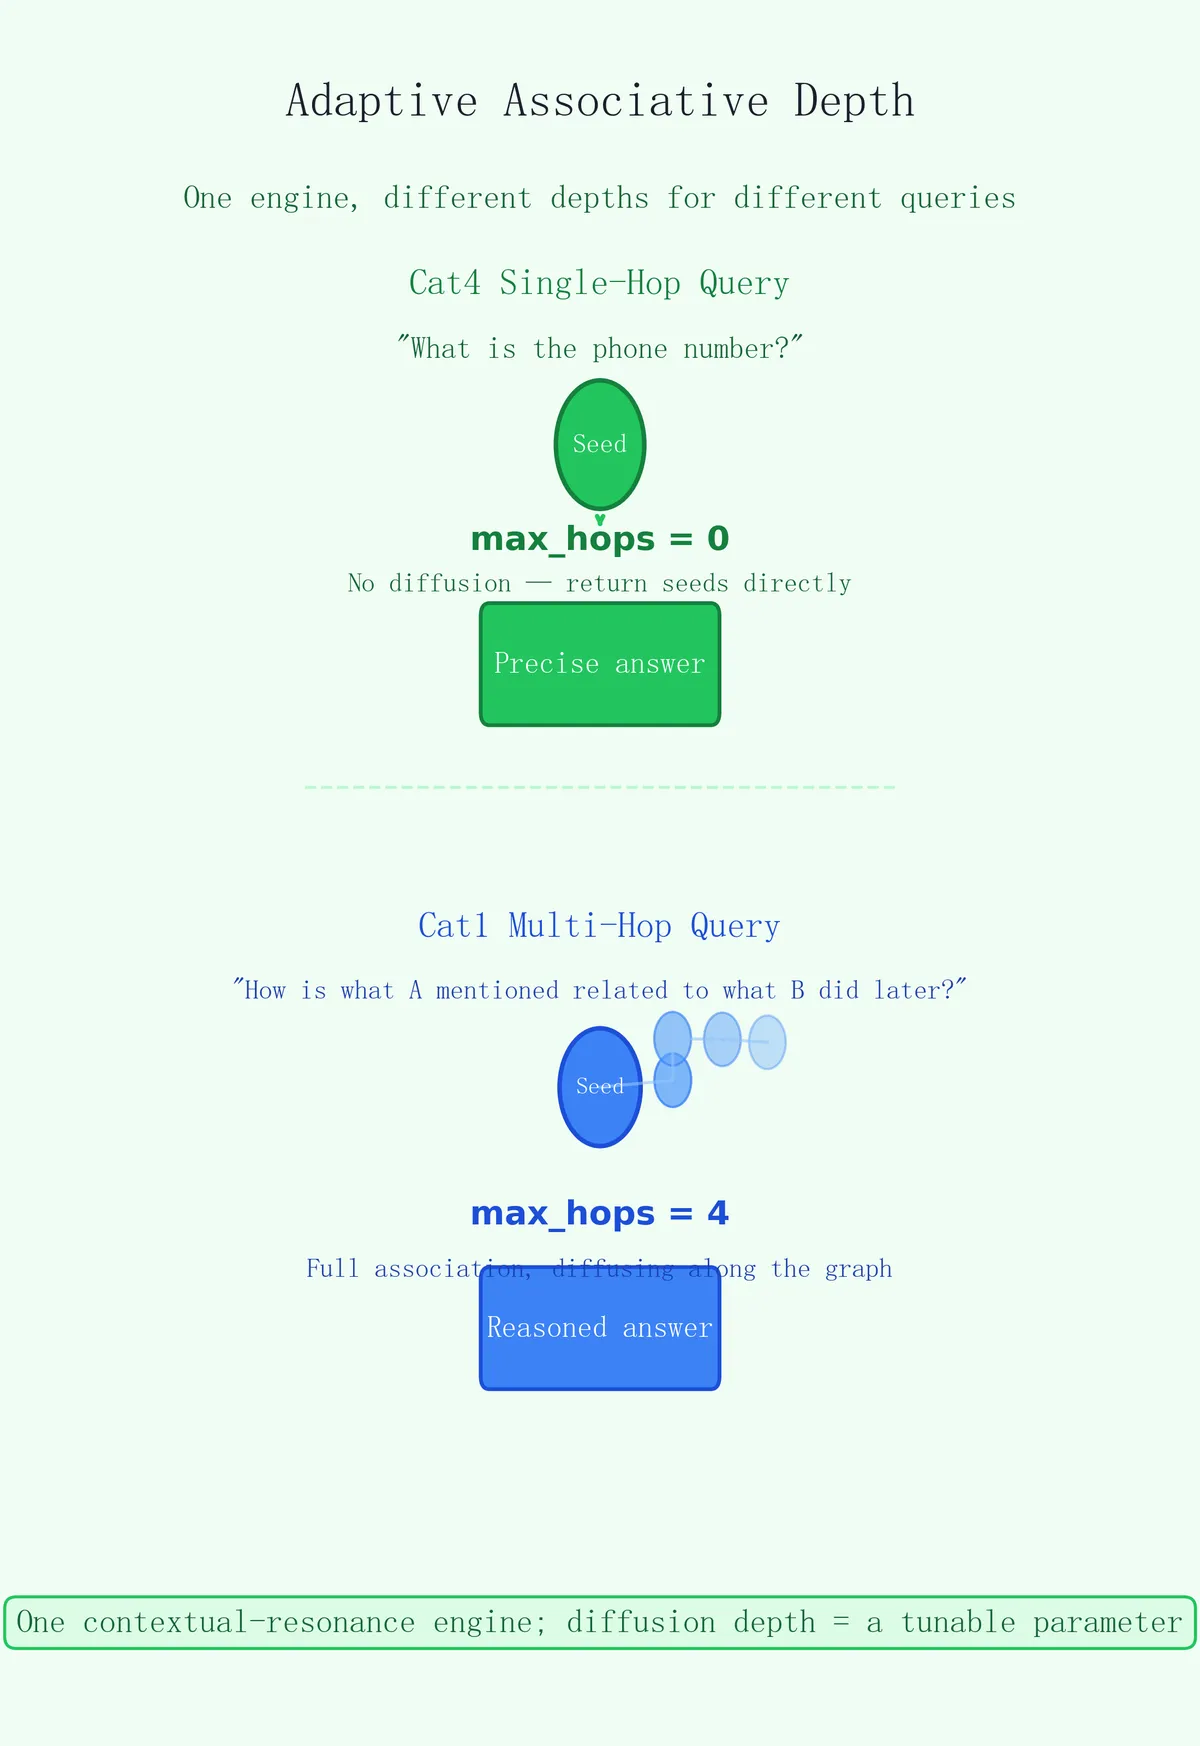
برای سوالی مثل «شماره تلفنی که کاربر در جلسه سوم گفت چه بود؟»، پاسخ از پیش در گره بذر موجود است. پخش اطلاعات در گراف صرفاً باعث میشود همسایگان نامرتبط وارد لیست ۱۰ نتیجه برتر شوند و پاسخ درست را به بیرون برانند. به همین دلیل، امتیازات دسته ۴ (تکمرحلهای) برای مدتی روی ۶۰ امتیاز متوقف شده بود.
آنها این مشکل را با افزودن مسیریابی داخلی به موتور رزونانس حل کردند تا عمق تداعی را به صورت تطبیقی تنظیم کند:
- پرسشهای سبک دسته ۴: مقدار
max_hopsروی ۰ تنظیم میشود تا فقط بذور برای بازیابی دقیق بازگردانده شوند. - پرسشهای سبک دسته ۱: مقدار
max_hopsروی ۴ تنظیم میشود تا تداعی کامل صورت گیرد.
این تنظیمات، نرخ بازیابی را از ۷۹.۲٪ به ۸۰.۱٪ رساند.
اعتبارسنجی در مقیاس واقعی
تیم توسعه برای جلوگیری از «حباب نمونههای کوچک»، تستها را از ۲ جلسه (۲۳۱ سوال) به یک اجرای کامل ۱۰ جلسهای شامل ۱,۵۳۶ جفت سوال ارتقا داد. این اجرای کامل که حدود یک ساعت زمان برد، توزیع دادهها را در هر دسته به شدت تغییر داد:
- دسته ۱ (چندمرحلهای): از ۶۷.۴٪ به ۸۰.۵٪ افزایش یافت
- دسته ۲ (زمانی): از ۹۳.۷٪ به ۸۶.۶٪ کاهش یافت
- دسته ۳ (عقل سلیم): از ۷۲.۷٪ به ۵۳.۳٪ کاهش یافت
- دسته ۴ (تکمرحلهای): از ۷۸.۱٪ به ۸۸.۰٪ افزایش یافت
سقوط شدید در دسته ۳ (که تنها ۹۲ سوال داشت) ثابت کرد که نمونههای کوچک میتوانند گمراهکننده باشند؛ چرا که تغییر در تنها ۱۱ سوال میتواند نتایج را به شدت منحرف کند. نتیجه نهایی در اجرای کامل، ۸۴.۲٪ شد.
نبرد رتبهبندی
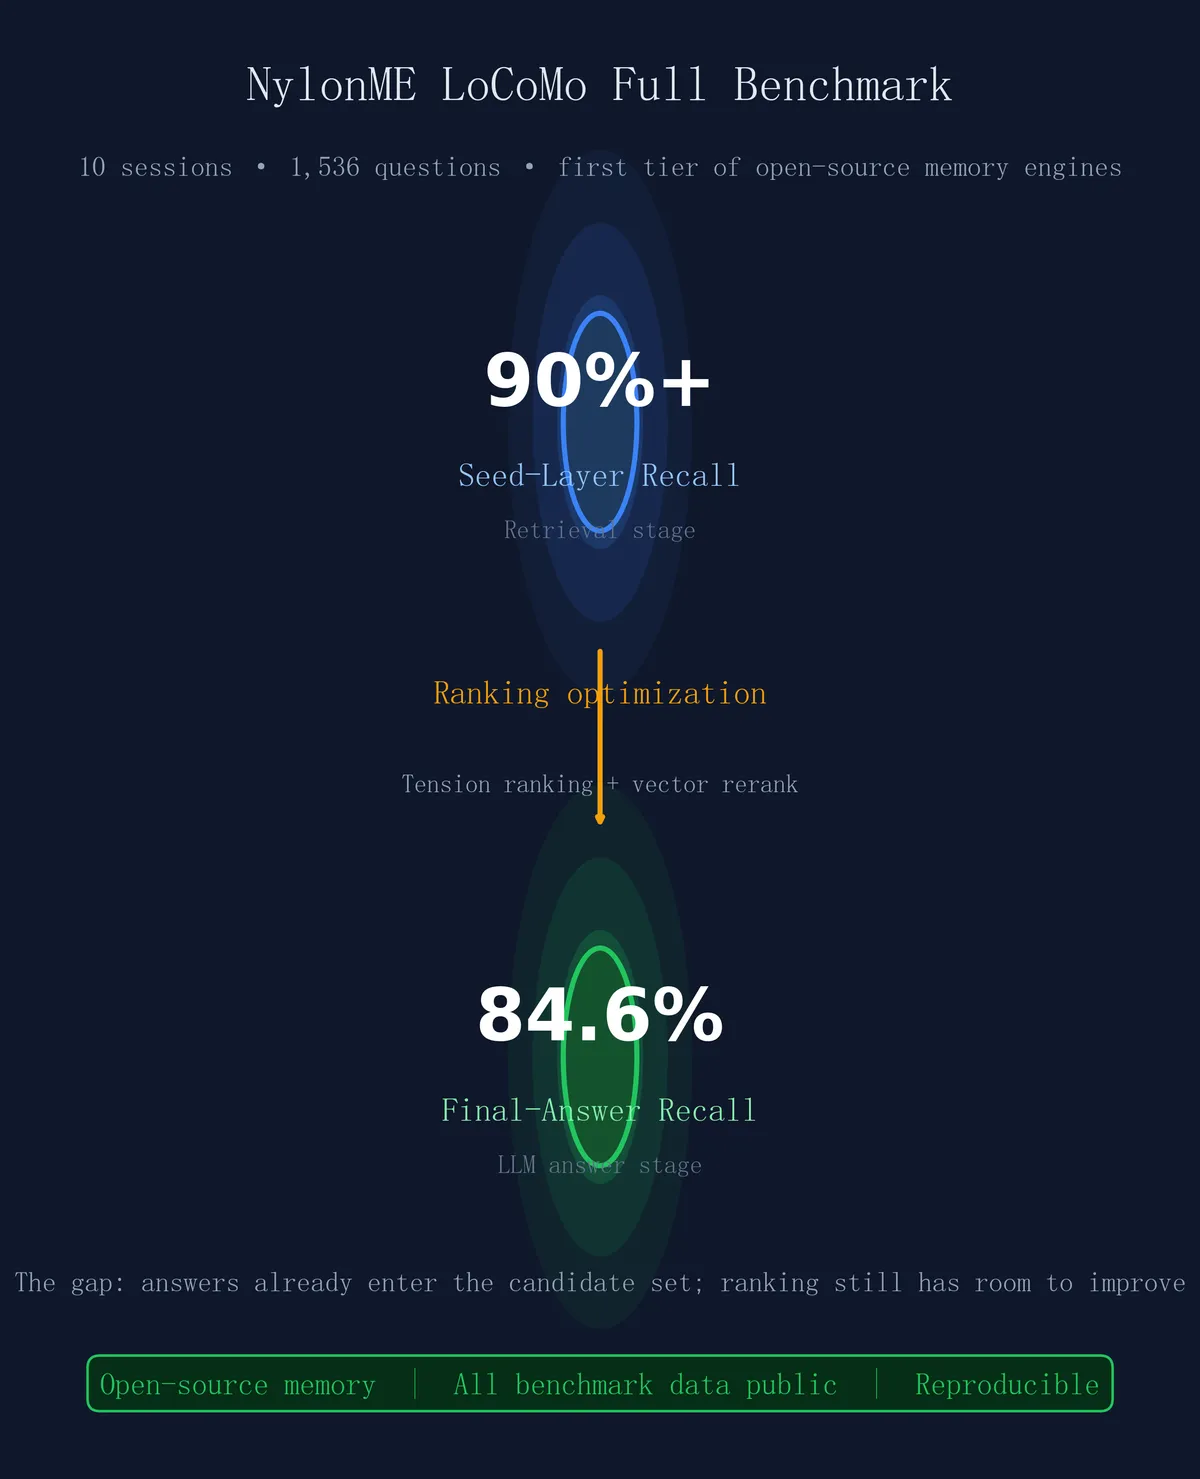
با وجود اینکه بازیابی لایه بذر بالای ۹۰٪ بود، اما بازیابی پاسخ نهایی روی ۸۴.۶٪ متوقف شد. این نشان داد که سیستم اطلاعات درست را پیدا میکرد اما در رتبهبندی آن در جایگاه اول شکست میخورد. برای سوالات تکمرحلهای، بازیابی لایه بذر ۹۳.۲٪ است اما بازیابی نهایی ۸۸.۰٪ است؛ یک شکاف ۵.۲ درصدی که صرفاً ناشی از تلفات مرحله رتبهبندی است.
پس از چندین آزمایش ناموفق، تیم با استفاده از بازرتبهبندی برداری (vector reranking) به موفقیت رسید. آنها شباهت کسینوسی (Cosine Similarity) بین بردار پرسش و تمام گرههای فعال را محاسبه کرده و سپس با یک ترکیب وزنی ۰.۵ با امتیاز رزونانس، رتبهبندی را مجدداً انجام دادند. این کار ۲.۵ امتیاز به دسته ۱ (۸۰.۵ $ \rightarrow $ ۸۳.۰) و ۰.۴ امتیاز به کل نمره اضافه کرد.
آزمایشهای شکستخورده
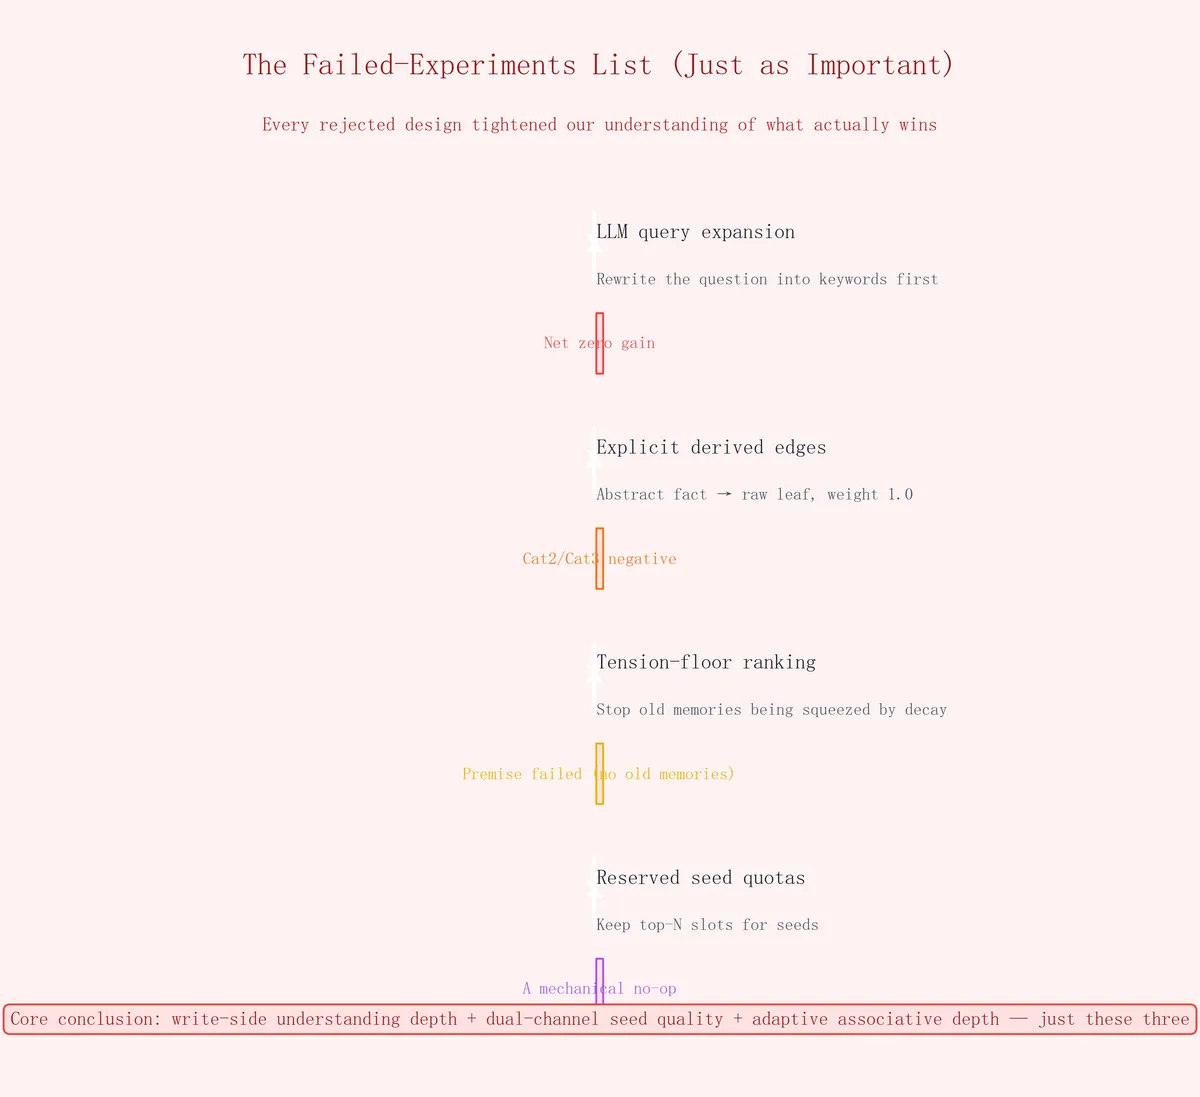
تیم NylonME برای جلوگیری از پیچیدگی بیهوده و پر کردن سیستم با الگوهای بلااستفاده، چندین متد رایج هوش مصنوعی را صراحتاً رد کرد:
- گسترش پرسش توسط LLM: بازنویسی سوالات به کلمات کلیدی پیش از بازیابی، هیچ سود خالصى نداشت زیرا درک سیستم در سمت «نوشتن» قبلاً این کار را انجام داده بود.
- کف تنش (Tension Floor): تلاش برای جلوگیری از حذف خاطرات قدیمی توسط زوال (decay) هیچ اثری نداشت، زیرا تمام گرههای محک تازه نوشته شده بودند و تنش آنها نزدیک به ۱ بود.
- سهمیه رزرو بذر: اختصاص جایگاههای برتر به بذور یک عملیات بیاثر (no-op) بود، زیرا ۲۸ بذر موجود، تقریباً تمام بودجه فعالسازی ۳۲ تایی را پر میکردند.
- لبههای مشتقشده صریح بین لایهها: لینک کردن دستی حقایق انتزاعی به برگهای خام (با وزن ۱.۰) اثر منفی روی دسته ۲ و ۳ داشت؛ در حالی که لبههای خودکار ضمنی (با وزن ۰.۵) کافی بودند.
استقرار در دنیای واقعی
فراتر از محکها، NylonME در حال حاضر روی یک سرور محلی (IP: 192.168.1.5, gRPC :50051) با استفاده از RocksDB روی دیسک مستقر شده است. توسعهدهندگان آن را به گردشکار خود از طریق یک پلاگین متصل کردهاند که در شروع هر تسک، تصمیمات تاریخی پروژه را رزونانس میکند.
آنها ۲۹ خاطره از تاریخچه پروژه، شامل نتایج معماری، دادههای محک و رکوردهای نقاط ضعف (pitfalls) را در سیستم گنجاندهاند. برای مثال، پرسشی مانند «نقاط ضعف مدل DeepSeek چیست؟» دقیقاً رکورد خطاهای ثبتشده در آن زمان را پیدا میکند و ثابت میکند سیستم در محیطی شبیه به تولید (production) کار میکند. این سطح از دقت در بازیابی، مشابه دستاوردهایی است که در سیستم InvMem برای رسیدن به رتبه اول در جدول AML از طریق مفهوم «حافظه کامل» مشاهده شد.
این تحول نشان میدهد آینده حافظه عاملها در بردارهای بهتر نیست، بلکه در درک پیشرفته در سمت «نوشتن» است. با کامپایل کردن حافظه در دو لایه در ابتدای کار، نیاز به پردازشهای گرانقیمت مدل زبانی در زمان بازیابی حذف میشود.
اگر در حال طراحی وضعیت بلندمدت برای عاملها هستید، مرز بعدی «مرحله رتبهبندی» است. همانطور که دادههای NylonME نشان میدهد، وقتی بازیابی به ۹۰٪ میرسد، تنها راه بهبود، استفاده از بازرتبهبندهای Cross-encoder یا مدلهای برداری برتری است که بتوانند بین موجودیتهای مشابه (مثلاً تفکیک دو گفتگوی سفر مختلف که هر دو از کلمه «پرواز» استفاده کردهاند) تفاوت قائل شوند.
کد این پروژه با مجوز Apache-2.0 در github.com/nylon-memory/NylonME در دسترس است.
گام بعدی شما
- اگر از RAG استفاده میکنید، استراتژی ذخیرهسازی خود را از «ذخیره ساده» به «ذخیره دو لایه» (خام + انتزاعی) تغییر دهید.
- برای بهبود دقت در نتایج نهایی، یک لایه بازرتبهبندی (Reranker) بر اساس شباهت کسینوسی به انتهای خط لوله بازیابی خود اضافه کنید.
- در طراحی حافظه، پردازشهای سنگین را به لحظه «نوشتن» منتقل کنید تا سرعت استنتاج در لحظه «خواندن» افزایش یابد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو