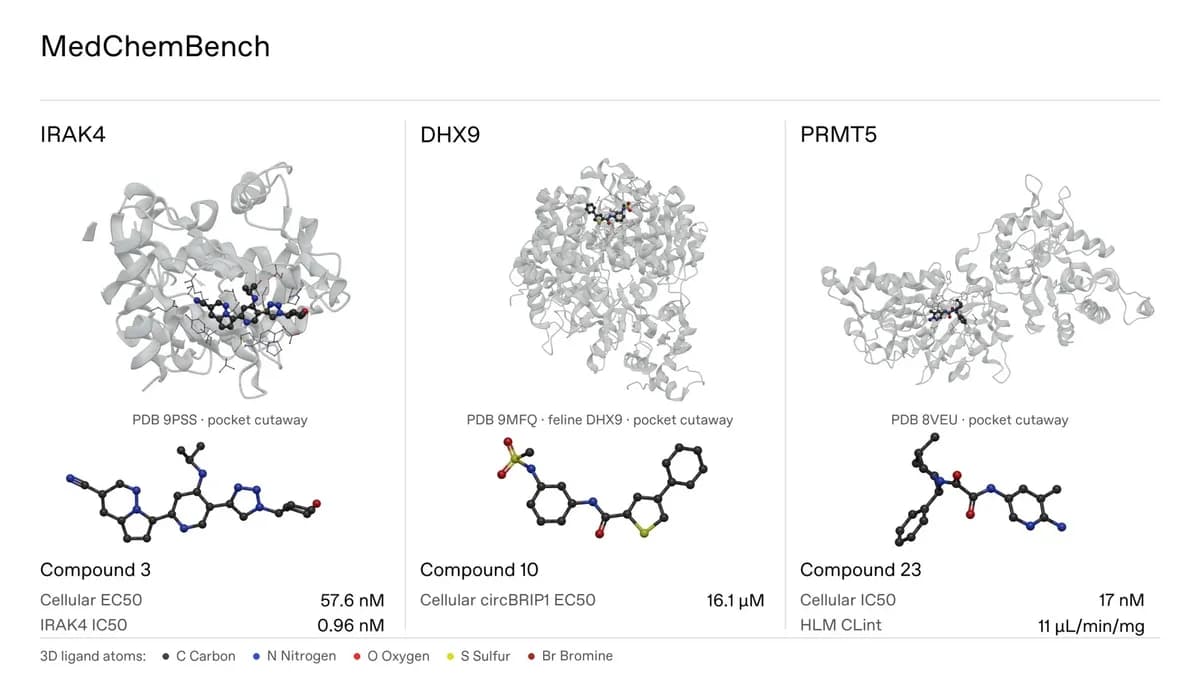
OpenAI روز ۲۰ نوامبر ۲۰۲۶ محک MedChemBench را منتشر کرد. GPT-6.2 Astra در بالاترین سطح تلاش استدلالی (xhigh) به ۸۴.۵٪ امتیاز رسید. این محک ۹۹ وظیفهٔ بازبینیشده را از ۱۱۷ مقاله و پتنت گردآوری کرده و ۷۶۱ ساختار مولکولی منحصربهفرد را پوشش میدهد. مشابه MedChemBench، OpenAI پیشتر نتایج GeneBench برای GPT-Rosalind-6 را منتشر کرده بود که ۳۷.۷٪ امتیاز گرفت. این پیشرفت در ایمنی مولکولی همصدا با نتایج عاملهای OpenAI در ۳۲۵ وظیفه زنده EHR که ۹۹٪ ایمنی بالینی ثبت کردند است.
ساختار محک و روش نمرهدهی
MedChemBench وظایف را در هفت دسته پیشبالینی سازماندهی کرده: انتخاب پیشنهاد یکپارچه (۴۸ وظیفه)، پیشبینی رابطه ساختار-فعالیت (۲۶)، ADME و انتقال، طراحی مولکولی، مسئولیتهای ایمنی، ریتروسنتز و بیولوژی آزمون. هشتاد و پنج وظیفه از چندین حوزه علمی عبور میکنند که تصمیمهای واقعی بهینهسازی پیشنهاد را بازتاب میدهند: قدرت، انتخابپذیری، متابولیسم و ایمنی باید همزمان سنجیده شوند.
نمرهدهی ترکیبی از بررسیهای قطعی و قاضی GPT-6 Astra در تلاش متوسط استدلال است. ساختار مولکولی ۳۷.۴۹٪، توجیه علمی ۳۵.۷۸٪، رتبهبندی و انتخاب کاندید ۱۷.۵۱٪ و پیشبینی عددی ۸.۹۲٪ اعتبار را تشکیل میدهند. ساختارها از طریق RDKit از SMILES ارسالشده قانونگذاری میشوند و استریوشیمی و ایزوتوپها حفظ میشوند. بهبودهای استدلالی GPT-6.2 Astra ادامهی پیشرفتهای سختافزاری و توکنی که در اسپرینت هفتهای OpenAI با GPT-6 Astra گزارش شده است میباشد.
نتایج مؤلفهها: شکاف بین درک و تصمیمگیری
در تلاش xhigh، GPT-6 Astra در بازسازی ساختار ۹۵.۳۷٪ و در توجیه علمی ۹۱.۰۵٪ کسب کرد، اما در رتبهبندی/انتخاب ۵۰.۴۲٪ و پیشبینی عددی ۴۷.۰۲٪ ماند. GPT-6.2 Astra نمره کلی را به ۸۴.۵٪ رساند، GPT-6.1 Sol به ۸۲.۰٪ رسید و GPT-5.6 Sol در ۵۸.۲٪ مانده. مقاله ۶۰۳۹۰ پاسخ نمرهدهیشده در ۱۱ مدل و ۶۱ شرط مدل-تلاش گزارش میدهد.
به صورت خلاصه، بازسازی ساختار ۹۵.۴٪، توجیه علمی ۹۱.۱٪، رتبهبندی/انتخاب ۵۰.۴٪ و پیشبینی عددی ۴۷.۰٪ بود؛ ساختار و توجیه ۷۳٪، رتبهبندی ۱۷.۵٪، پیشبینی ۸.۹٪ و توجیه ۳۵.۸٪ وزن داشتند.
خطاهای ساختاری عینی
یک وظیفهٔ بازسازی شامل مونتاژ یک ماکروسیکل ۱۸ اتمی از اسکافلد مرکزی و دو جانگزین بود. GPT-6 Astra در همه ده تلاش xhigh ساختار صحیح را تولید کرد؛ GPT-5.6 Sol یک حلقه ۱۵ اتمی ساخت و GPT-5.6 Luna قطعات جدا شده برگرداند. چنین خطاها هویت مولکول را قبل از هر استدلال ویژگیای تغییر میدهند.
مطالعه موردی PRMT5: تضاد چندویژگیای
یک مسئله متمرکز بر PRMT5 از مدلها خواسته بود سه ترکیب مرتبط را بازسازی کنند و قدرت سلولی، نفوذ، خروج فعال و خالصسازی میکروزومال انسانی را پیشبینی کنند. نتایج پنهانشده نشان داد ترکیب ۲۳ در سلول قدرتمندتر بود، در حالی که ترکیب ۲۴ راحتتر از سد سلولی عبور کرد و در آزمون آنزیم کبد کندتر تجزیه شد — نمونه دقیق تضاد چندویژگیای که محک هدف قرار داده است.
محدودیتها و مسیرهای پیشنهادی
OpenAI تأکید میکند نمرات اثبات نمیکنند مدلها میتوانند داروی نو کشف کنند یا تصمیمهای آزمایشگاه را بهبود بخشند. هر پاسخ تلاش تکی بود بدون ابزار، بازخورد یا آزمایش نو. یک بررسی آلودگی ابتکاری DOIها منبع را به پرامپتهای نه مدل در xhigh افزود؛ تغییرات میانگین نمره از ۰.۲۳- تا ۰.۸۰+ درصد بود و تمام فاصلههای اطمینان ۹۵٪ صفر را در بر میگرفتند.
OpenAI محک فعلی را نزدیک به اشباع توصیف میکند و یادآوری میکند نمرهدهی طراحی باز همچنان به پاسخهای مرجع وابسته است، که ممکن است جایگزینهای معقول را مجازات کند. توسعههای پیشنهادی شامل موارد پیشبینانه، داوری کارشناس پاسخهای جایگزین، پردازش صریح عدم قطعیت آزمون و مسیر مبتنی بر عامل است که بازیابی، محاسبه، تأیید ساختار و بازنگری چندمرحلهای را مجاز میدارد.
گفتگو