
امتیاز ۶۱.۷ اکنون معیار جدید تعالی در کدنویسی است. در ۱۴ اوت ۲۰۲۶، تیم Qwen از شرکت علیبابا (Alibaba)، مدل Qwen3.8-27B را تحت مجوز Apache-2.0 منتشر کرد تا با کسب بالاترین امتیاز در محک SWE-bench Pro، مدلهای ابری غولپیکر را به چالش بکشد.
این مدل محلی با ۲۷ میلیارد پارامتر توانست مدل Opus4.6 Max از شرکت آنتروپیک (Anthropic) را از صدر جدول پایین بکشد و از مدلهایی نظیر Muse Glimmer-30B و نسخههای پیشین Qwen پیشی بگیرد.
این عرضه در حالی رخ میدهد که صنعت هوش مصنوعی برای ایجاد تعادل میان هزینههای هنگفت محاسباتی در پنجرههای متنی بلند و نیاز به استدلال دقیق در تلاش است. همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی استنتاج در مدلهای بازمتن اشاره کردیم، کاهش فاصله میان مدلهای محلی و ابری در حال تسریع است. برای توسعهدهندگان و استارتاپها، امکان اجرای قابلیتهای عاملمحور (Agentic) در سطح مدلهای پیشرو روی یک واحد پردازش گرافیکی (GPU) قدرتمند، اقتصاد مهندسی نرمافزار خودکار را تغییر میدهد.
چرخش به سمت سامانههای عاملمحور
به نقل از مستندات رسمی این مدل، نسخه ۲۷ میلیاردی در مجموع از مدل بزرگتر Qwen3.7-Plus بهتر عمل میکند. این پیشرفتها بهطور مشخص در کارهای عاملمحور — یعنی برنامهریزی، واکنش به بازخوردهای محیطی و اجرای تکالیف چندمرحلهای — متمرکز شده است.
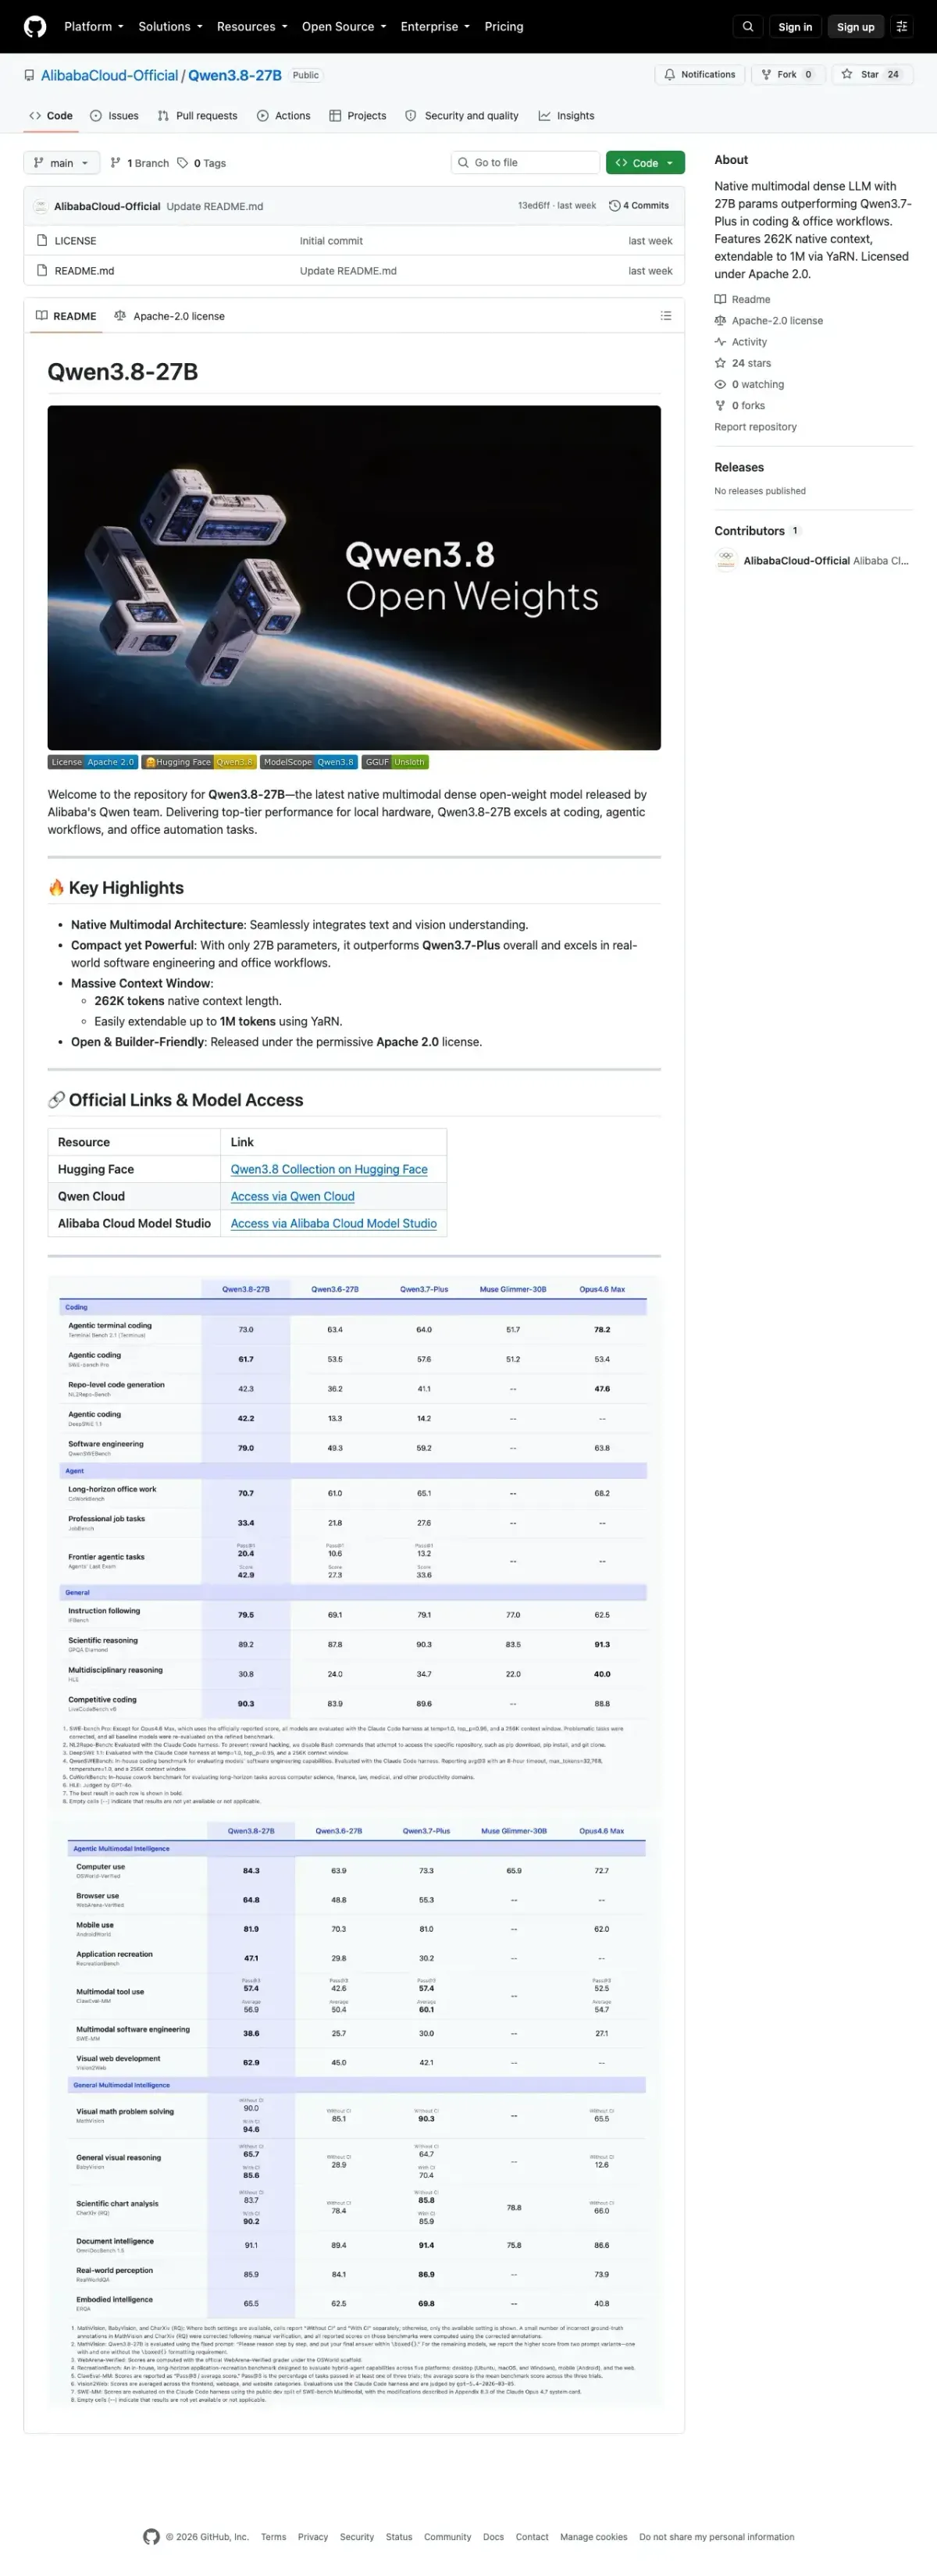
بر اساس مستندات منتشر شده، جهش قابلیتها در جریانهای کاری عاملمحور خیرهکننده است؛ بهطوری که در محک DeepSWE 1.1 (کدنویسی عاملمحور)، امتیاز مدل از ۱۳.۳ در نسخه Qwen3.6-27B به ۴۲.۲ در نسخه Qwen3.8-27B رسیده است که نشاندهنده رشد ۳ برابری در یک نسل است.
مشخصات فنی و بنچمارکها
- سلطه عاملمحور: کسب رتبه اول در OSWorld (۸۴.۳)، WebArena (۶۴.۸)، LiveCodeBench v6 (۹۰.۳) و CoWorkBench (۷۰.۷).
- قابلیتهای چندوجهی: کسب امتیاز ۸۱.۹ در AndroidWorld برای استفاده از موبایل و ۶۲.۹ در Vision2Web.
- محکهای استدلالی: در Agents' Last Exam، معیار Pass@1 از ۱۰.۶ به ۲۰.۴ رسید و امتیاز کلی با ۴۲.۹ رتبه اول را به دست آورد.
- پنجره زمینه: دارای ۲۶۲,۱۴۴ توکن بومی که از طریق YaRN تا ۱,۰۰۰,۰۰۰ توکن قابل گسترش است.
- بهینگی هزینه: نسخههای میزبانیشده قیمت ۰.۴۵ دلار برای هر میلیون توکن ورودی و ۳.۲۰ دلار برای خروجی دارند.
دستاورد معماری این مدل در نسبت توجه ترکیبی ۳:۱ نهفته است. مدل از ۶۴ لایه تشکیل شده که در بلوکهای چهارتایی گروهبندی شدهاند: سه لایه Gated DeltaNet (توجه خطی) به ازای یک لایه Gated Attention (توجه کامل). این ساختار نخستین بار در Qwen3.5 معرفی شد.
این معماری به مدل اجازه میدهد توالیهای بلند و توکنهای بصری را بهصورت ارزان از طریق توجه خطی جذب کند و توجه کامل را برای استدلالهای دشوار رزرو نماید تا از هزینه محاسباتی درجهدوم در هر بلوک جلوگیری شود. Qwen3.8 همچنین قابلیت پیشبینی چندتوکنی (MTP) را به این پایه اضافه کرده است.
برای سازندگان محصول، این مدل یک «حالت تفکر» قابل کنترل معرفی میکند. کاربران با تنظیم reasoning_effort (بسیار زیاد، متوسط، کم) یا غیرفعال کردن enable_thinking میتوانند بین پاسخهای مستقیم و استدلال عمیق انتخاب کنند. قابلیت preserve_thinking نیز تضمین میکند که در گفتگوهای چندمرحلهای، زمینه استدلالی مراحل قبل حفظ شود.
این تغییر سیگنالی است مبنی بر اینکه مدلهای متراکم کوچک اکنون بسیار فراتر از وزن خود عمل میکنند. با شکست دادن نسخه بزرگتر Qwen3.7-Plus، ثابت شد که کارایی معماری در تکالیف عاملمحور میتواند بر تعداد خام پارامترها غلبه کند.
با این حال، این مدل هنوز «قاتل کامل» مدلهای ابری نیست. در محک HumanEval (HLE) با امتیاز ۳۰.۸ در برابر ۴۰.۰ مدل Opus4.6 Max و همچنین در GPQA عقبتر است. وضعیت فعلی نشان میدهد مدلهای محلی در «بهرهبرداری» از رابطها (دسکتاپ، مرورگر و موبایل) به مدلهای پیشرو رسیدهاند، اما عمیقترین استدلالهای کلی همچنان در فضای ابری است.
استقرار این مدل از طریق vLLM، SGLang و Hugging Face امکانپذیر است. برای رایانش لبه، شرکت مدیاتک (MediaTek) انطباق روز اول را برای پلتفرم C-X1 و تراشههای پرچمدار موبایل فراهم کرده است. در پیکربندی ۶۴ هستهای XuanTie C950، سرعت رمزگشایی بیش از ۳۰ توکن بر ثانیه با زمان تا نخستین توکن ۱.۹ ثانیه است.
کاربران باید به دو نکته توجه کنند: ورودی ویدیوهای تمامقاب نیاز به تنظیمات خاص در vLLM دارد و در فراخوانیهای Qwen Cloud باید از enable_thinking: False استفاده شود.
گام بعدی شما
- اگر توسعهدهنده ابزارهای خودکار هستید، مدل را از طریق vLLM روی سختافزار محلی تست کنید تا کاهش هزینه استنتاج را بسنجید.
- قابلیت
reasoning_effortرا برای بهینهسازی تعادل میان سرعت پاسخ و دقت استدلال در اپلیکیشن خود تنظیم کنید. - ادغام این مدل در عاملهای کدنویسی خودکار را بررسی کنید، چرا که جهش ۳ برابری در DeepSWE استانداردهای جدیدی برای ابزارهای محلی ایجاد کرده است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو