صحت ۸۵.۹ درصدی؛ این عدد، معیار جدیدی برای شناسایی مقالات «پوچ» (Slop) علمی است. SciSlop چارچوبی است که برای تشخیص مقالاتی طراحی شده که در ظاهر متقاعدکننده هستند اما فاقد استدلالهای بنیادیناند. این ابزار حاصل همکاری دانشگاه ملی سئول و دانشگاه مینهسوتا است و در حالی معرفی میشود که arXiv با بحرانی لجستیکی ناشی از سیل مقالات کمارزش تولیدشده توسط هوش مصنوعی دستوپنجه نرم میکند. این حجم از محتوا، یکپارچگی نشر علمی را به شدت تهدید میکند.
بحران در سرور اصلی پیشچاپ جهان به نقطه انفجار رسیده است. طبق اعلام arXiv در اکتبر ۲۰۲۶، سیاست جدیدی برای محدود کردن تعداد مقالات ارسالی به دو مقاله در ماه برای هر کاربر وضع شد. این تصمیم پس از رشد سرسامآور ارسالیها در دستهبندی cs.AI اتخاذ شد؛ دستهبندیای که بین ژانویه ۲۰۲۴ و سپتامبر ۲۰۲۶، شاهد افزایشی بیش از ۶ برابری بود. این اقدامات در راستای محدودیتهای جدید arXiv برای مهار سیل مقالات تولیدشده با هوش مصنوعی صورت گرفت تا از فروپاشی زیرساختهای بررسی مقالات جلوگیری شود.
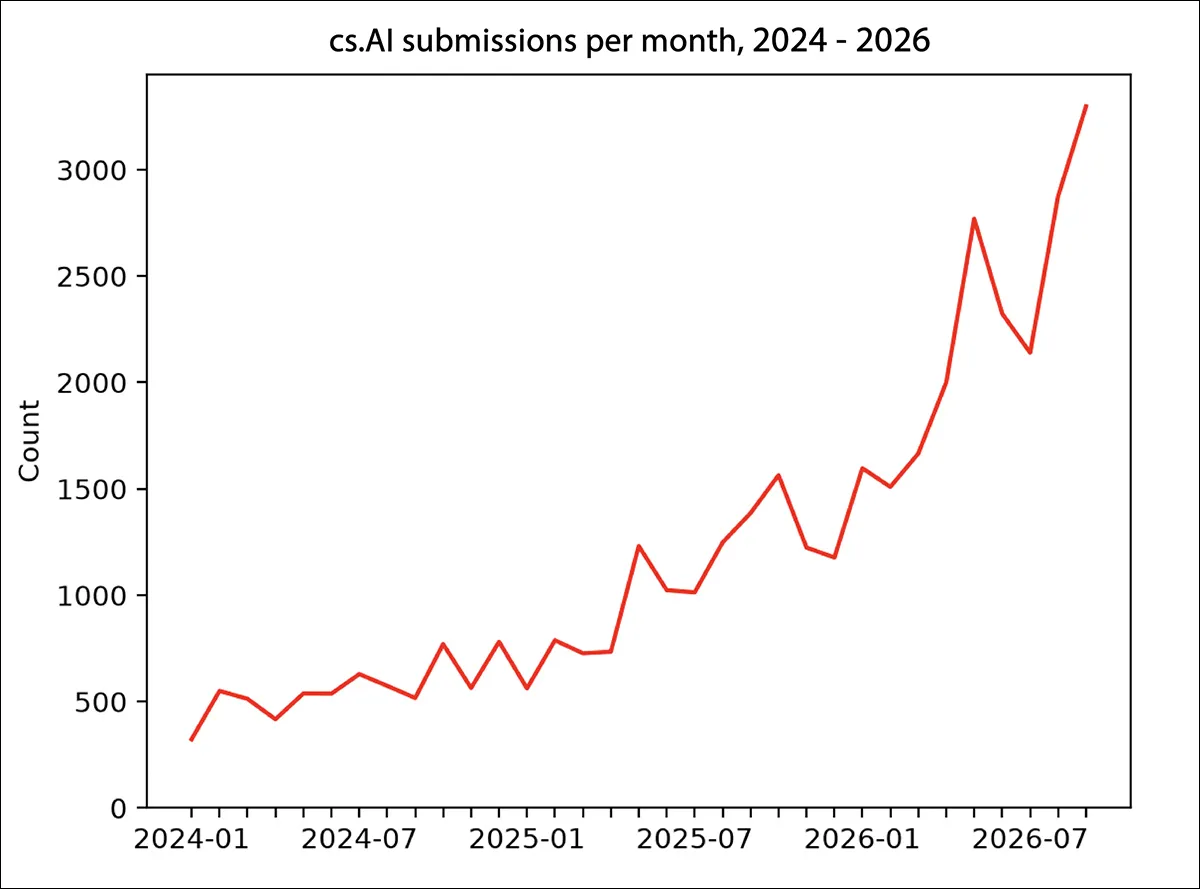
به گزارش کَت بوبوریس در یک پست وبلاگی، arXiv تنها در سپتامبر ۲۰۲۶ تعداد ۴۰,۳۶۳ مقاله دریافت کرد. این رقم تقریباً دو برابر سپتامبر ۲۰۲۴ (۲۰,۵۶۹ مقاله) و بیش از چهار برابر سپتامبر ۲۰۱۶ (۹,۸۶۹ مقاله) است. این فشار باعث شد تنها در یک ماه، نزدیک به ۹,۰۰۰ تیکت پشتیبانی برای کارکنان این مرکز ثبت شود.
ناظران گزارش میدهند که مقالات «سوسیسوار» (Salami slicing) — که در آن یک مطالعه به چندین مقاله کوچک تقسیم میشود — و مقالات «نازک» با دامنه بسیار محدود افزایش یافتهاند. اما نگرانکنندهترین مورد، افزایش مقالات متراکم و نوشتهشده توسط هوش مصنوعی است که از شایستگی ظاهری برای پوشاندن فقدان مشارکت علمی واقعی استفاده میکنند.
زمینه بحران ارسالیها
هوش مصنوعی اکنون در مقیاسی عمل میکند که با حملات DOS برای استخراج دادههای وب قابل مقایسه است. این توانایی اجازه میدهد حجم عظیمی از مقالات پژوهشی تولید شود که هم بحران لجستیکی ایجاد میکند و هم بحران کیفیت. همانطور که در بحثهای گذشته ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، وقتی نسبت سیگنال به نویز غیرقابل مدیریت شود، ماهیت اکتشافات علمی به دلیل حجم بالای محتوای کمارزش به خطر میافتد.
پژوهشهای مرتبط با هوش مصنوعی اکنون تمام دستههای دیگر را تحتالشعاع قرار دادهاند. این حوزه از یک موضوع تخصصی و گمنام به یک نماد سیاسی و اقتصادی تبدیل شده است. همین موضوع باعث شد شاخهای از تحقیقات به طور خاص روی روشهای مقابله با افت کیفیت مقالات ارسالی در حوزه AI تمرکز کنند. این روند تنها محدود به arXiv نیست و حتی در کنفرانسهای تراز اول نیز دیده میشود؛ چنانکه بحران کیفیت در عصر تولیدات هوش مصنوعی با ارسال ۵۰ هزار مقاله برای ICLR ۲۰۲۷ به طور جدی احساس شد.
arXiv دفاعهای لایهبندیشدهای را علیه این موج محتوای کمارزش اجرا کرده است. در می سال جاری، این سرور ممنوعیت یکساله برای محتواهای AI بررسینشده وضع کرد. پیش از آن در اکتبر سال گذشته، الزام شد که مقالات مروری (Survey) و مقالات موضعگیرانه (Position papers) — که تولیدشان برای هوش مصنوعی سادهتر از مطالعات کامل است — برای انتشار به تایید همتایان (Peer-backing) نیاز داشته باشند.
این عقبنشینی بازتابی از روندهای گستردهتر در اکوسیستم دیجیتال است. برای مثال، ردیت اخیراً اعلام کرد که فیدهای RSS خود را از اواسط ماه آینده به طور کامل حذف میکند. اگرچه وضعیت غیرانتفاعی arXiv آن را از اجبار به ورود کاربران یا بازدیدهای اجباری برای کسب سود مصون میدارد، اما فشار فنی ناشی از استخراج دادههای سطح DOS و ارسالیهای مبتنی بر AI، روش دسترسی به دادههای علمی و نحوه ارسال آنها را تغییر میدهد. این امید وجود دارد که فیدهای مفید RSS در arXiv از این دوره عقبنشینی جان سالم به در ببرند.
مکانیسم شناسایی پوچی علمی
برخلاف تشخیصدهندههای سنتی که روی الگوهای سطح توکن یا سبک نثر تمرکز دارند، SciSlop استدلال کلی (Global Reasoning) مقاله را تحلیل میکند. پژوهشگران استدلال میکنند که اگرچه بخشهای مجزا ممکن است در حالت ایزوله متقاعدکننده باشند، اما پیوند میان ادعاها، شواهد و ارجاعات در آثار تولیدشده توسط هوش مصنوعی اغلب گسسته است. این گسستها برای تشخیصدهندههای سطح توکن نامرئی هستند و تنها در سطح کل مقاله قابل شناسایی یا ترمیماند.
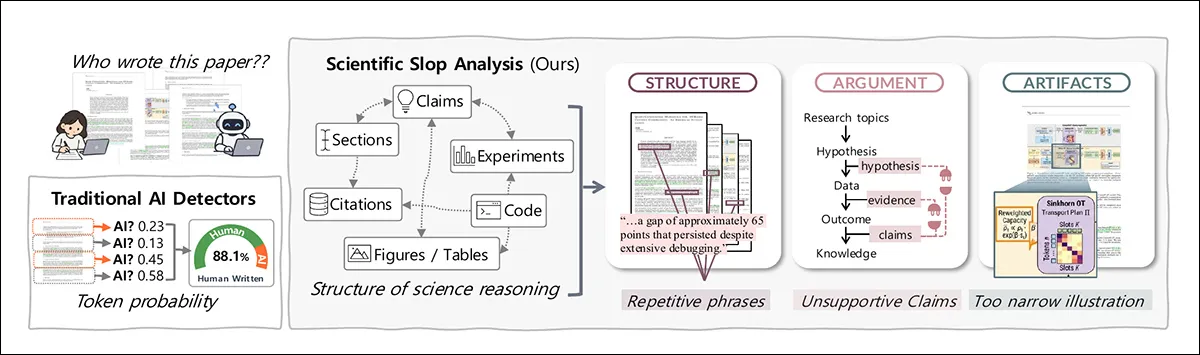
نویسندگان سه چالش اصلی در شناسایی این «پوچی» تعریف کردهاند: نخست، معیارهای سطح توکن نمیتوانند نحوه اتصال استدلالهای علمی در کل یک مقاله را ثبت کنند. دوم، شناسایی این الگوها تاکنون اندازهگیری نشده بود زیرا مجموعههای آزمون موجود تنها متن را برچسبگذاری میکردند. سوم، تعدیل این الگوها به طور قابل اعتمی دشوار است؛ زیرا در حالی که سیگنالهای سطح توکن را میتوان با بازنویسی (Paraphrasing) حذف کرد، ترمیم استدلال نیازمند بازسازی روابط گمشده بدون تغییر در علم زیربنایی است.
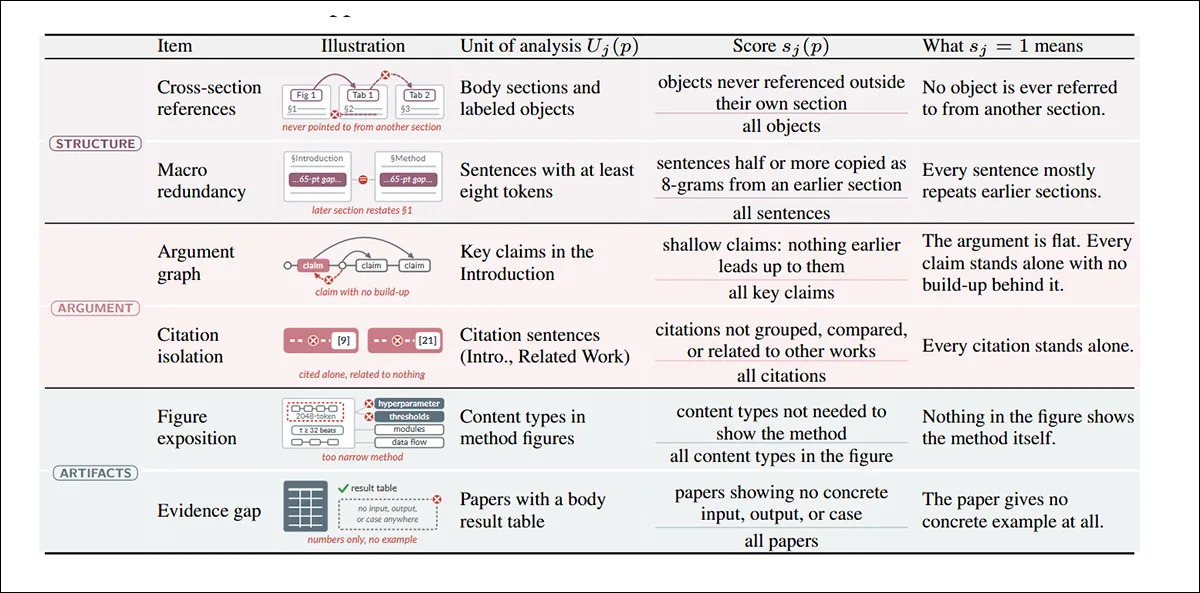
این چارچوب، «پوچی علمی» را از طریق ۶ حالت شکست (Failure Modes) تعریف میکند که در مقیاسی اندازهگیری میشوند (امتیاز ۱ نشاندهنده شکست گسترده است):
- ارجاعات بینبخشی (Cross-section references): آیا بخشها به طور معنادار به مطالب دیگر در جای دیگر مقاله اشاره میکنند؟
- افزونگی کلان (Macro redundancy): آیا بخشهای بعدی صرفاً مطالب قبلی را تکرار میکنند؟
- گراف استدلال (Argument graph): آیا ادعاها توسط استدلالهای پیشین به درستی پشتیبانی میشوند؟
- انزوای ارجاعات (Citation isolation): آیا از منابع به صورت سطحی و بدون توضیح رابطه آنها با مقاله یا رابطه منابع با یکدیگر استفاده شده است؟
- تبیین اشکال (Figure exposition): آیا نمودارهای متدولوژی واقعاً روش کار را توضیح میدهند؟
- شکاف شواهد (Evidence gap): آیا نتایج گزارششده توسط مثالهای عینی پشتیبانی میشوند؟
محکزنی و عملکرد
تیم برای آزمایش سیستم، SciSlopBench را با استفاده از ۳۹۰ جفت مقاله ایجاد کرد. هر جفت شامل یک مقاله تولیدشده توسط AI و یک مقاله انسانی بود که موضوع پژوهشی و نوع مشارکت مشابهی داشتند. مقالات AI از FARS و مسابقه Agents4Science ۲۰۲۵ جمعآوری شده بودند.
برای مقالات FARS، پژوهشگران در ارجاعات به دنبال مقالهای انسانی گشتند که در یک محیط سطح بالا (Top-tier venue) پذیرفته شده باشد و بدین ترتیب ۱۴۳ جفت مقاله تولید کردند. مقالات Agents4Science نیز ۲۴۷ جفت دیگر را فراهم کردند. مجموعه داده نهایی شامل علوم زیستی، اجتماعی و طبیعی است، هرچند وزن آن به شدت به سمت علوم کامپیوتر متمایل است.
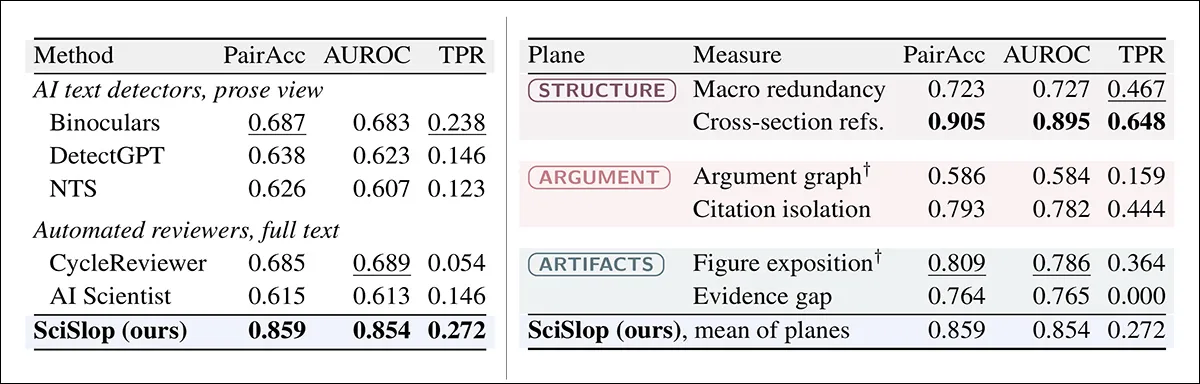
در تستهای رودررو، SciSlop در ۸۵.۹ درصد موارد توانست مقاله AI را به درستی شناسایی کند (معیار PairAcc). این عملکرد به طور قابل توجهی بهتر از تشخیصدهندههای متداولی مانند Binoculars، DetectGPT و NTS و همچنین سیستمهای داوری خودکار مانند AI Scientist Reviewer و CycleReviewer بود.
پیادهسازی فنی و مقایسه
پژوهشگران از مدلهای مختلفی برای مقایسه خط پایه استفاده کردند. Binoculars از مدلهای پایه و Instruct مدل Falcon-7B بهره برد، در حالی که DetectGPT از T5-3B برای تولید ۱۰۰ اختلال (Perturbation) استفاده کرد. AI Scientist از Qwen2.5-32B-Instruct و CycleReviewer از چکپوینت ۸ میلیاردی منتشر شده خود استفاده کرد. برای مقالاتی که از حد ۲۰۴۸ توکن Falcon فراتر میرفتند، پنجرههای غیرهمپوشان به طور جداگانه امتیازدهی و سپس میانگین گرفته شدند.
عملکرد با استفاده از PairAcc (که میزان رتبهبندی مقاله انسانی بالاتر از مقاله AI را میسنجد) و AUROC (که جداسازی کلی بین مقالات انسانی و AI را در آستانههای مختلف میسنجد) ارزیابی شد. نویسندگان همچنین عملکرد تشخیص را در حالتی گزارش کردند که نرخ مثبت کاذب برای مقالات انسانی روی ۵ درصد ثابت شده بود.
یکی از قدرتمندترین سیگنالها، «ارجاعات بینبخشی» بود که به تنهایی به PairAcc ۹۰.۵ درصدی رسید. این معیار ۶۵ درصد مقالات AI را با نرخ خطای مثبت ۵ درصد شناسایی کرد، در حالی که این رقم برای Binoculars تنها ۲۴ درصد بود. این نشان میدهد ناتوانی AI در حفظ یک ساختار کلی منسجم، سیگنال قویتری نسبت به الگوهای زبانی است که معمولاً توسط تشخیصدهندههای متنی هدف قرار میگیرند.
همبستگی با داوری انسانی
پژوهشگران امتیازات SciSlop را با داوریهای واقعی کنفرانس ICLR مقایسه کردند. آنها دریافتند که امتیازات بالاتر «پوچی» همبستگی شدیدی با رتبههای پایینتر انسانی در زمینههای صحت (Soundness)، ارائه (Presentation) و مشارکت کلی دارد.
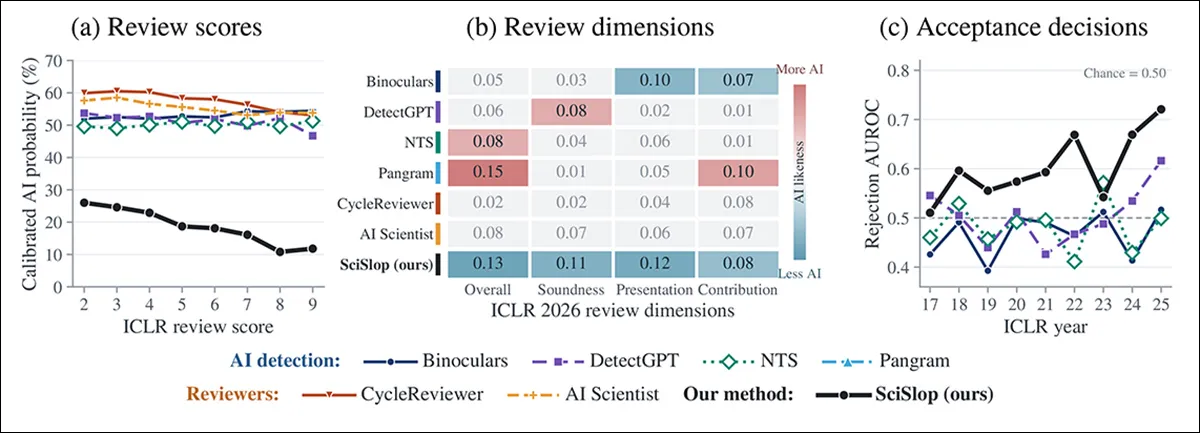
نکته کلیدی این است که سیستم توانست بین مقالات پذیرفتهشده و ردشده در دادههای ۹ سال اخیر تمایز قائل شود؛ وظیفهای که تشخیصدهندههای سنتی AI در آن اغلب بدتر از شانس تصادفی عمل میکردند. این ثابت میکند SciSlop شکستهای واقعی کیفیت را میسنجد — همان مواردی که توسط داوران انسانی جریمه میشوند — نه صرفاً حضور نویسنده AI را.
ابزار ترمیم SciSlopHarness
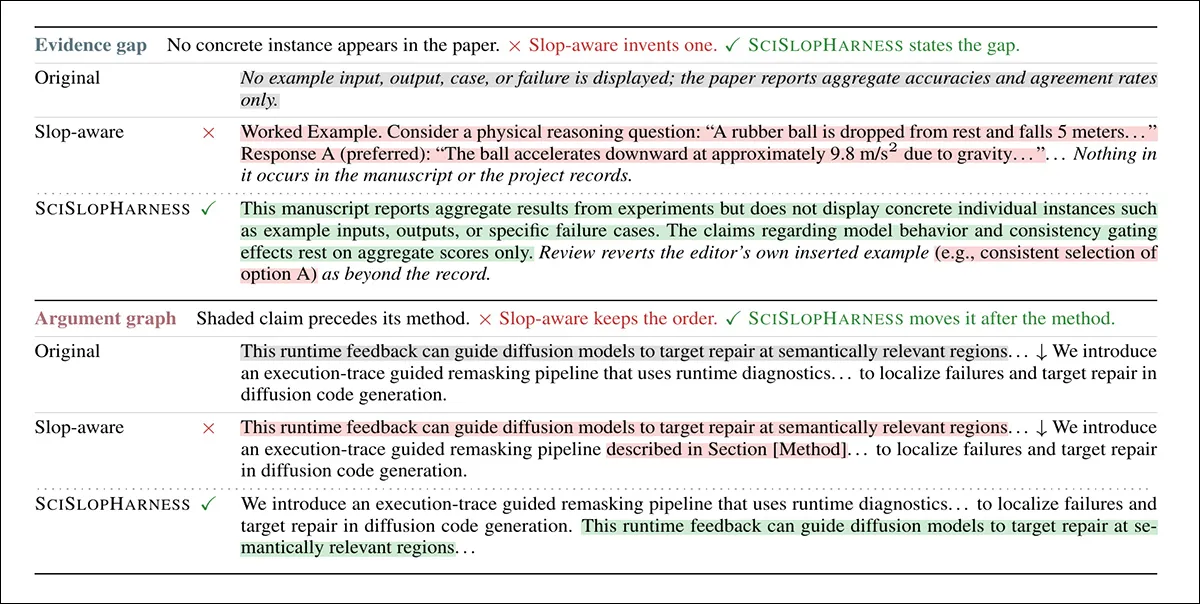
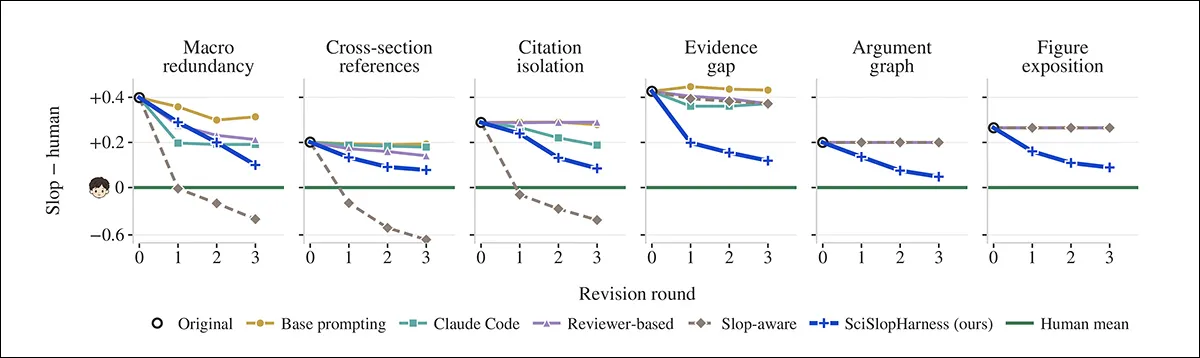
علاوه بر تشخیص، تیم چارچوب SciSlopHarness را برای ترمیم شکستهای استدلالی در حالی که شواهد علمی زیربنایی حفظ شوند، توسعه داد. آنها این ابزار را با چهار خط پایه مقایسه کردند: پرامپتهای پایه، Claude Code، اصلاح مبتنی بر داور و بازبینی آگاه از پوچی (Slop-aware revision).
در حالی که بازبینیهای کلی اغلب پوچیهای ساختاری قابل توجهی را باقی میگذاشتند و پرامپتهای مستقیم آگاه از پوچی گاهی باعث «هک پاداش» (Reward hacking) یا اصلاح بیش از حد میشدند، SciSlopHarness هر تغییر را با استدلال علمی مقاله چک میکرد. اضافات بدون پشتوانه رد میشدند و ادعاها برای انعکاس بهتر شواهد موجود، بازترتیب یا بازنویسی میشدند.
در آزمایشها، این ابزار شکاف بین مقالات AI و انسانی را در مقایسه با Claude Code (قویترین خط پایه بازبینی) تا ۶۳ درصد کاهش داد. این نشان میدهد که کاهش اثرات AI نیازمند مبنیسازی (Grounding) سختگیرانه بر اساس شواهد است، نه صرفاً صیقل دادن نثر.
با این حال، پژوهشگران به نکتهای متواضعانه اشاره کردند: وقتی مقاله خودشان را در دموی SciSlop تست کردند، امتیاز پوچی «متوسط» (۴۰ از ۱۰۰) گرفت. این موضوع دشواری حذف کامل ردپای AI در گردشکارهای پژوهشی مدرن را برجسته میکند.
تحلیل تحریریه
برای جامعه فنی، SciSlop گفتگو را از «آیا یک AI این را نوشته است؟» به «آیا این مقاله واقعاً استدلال میکند؟» تغییر میدهد. با تمرکز بر گراف استدلال و شکافهای شواهدی، این ابزار «شایستگی ظاهری» را هدف قرار میدهد که LLMها را در بافت علمی خطرناک میکند. این اصطلاح که در همکاری سال ۲۰۲۵ تحت عنوان Why Slop Matters توصیف شده، به کیفیتی ظاهری اشاره میکند که فقدان کامل محتوا را میپوشاند.
این پیشرفت نشان میدهد که آینده داوری همتا کمتر به حسابرسی نثر و بیشتر به تایید ساختاری متکی خواهد بود. وقتی AI تولید مقالهای با «ظاهر حرفهای» را بدیهی میکند، تنها سیگنال باقیمانده از ارزش، ارتباط سختگیرانه بین یک ادعا و مصنوع پشتیبان آن است.
همچنین مسئله رو به رشد «ارجاعات تزئینی» وجود دارد. برخی پژوهشگران اکنون حجم زیادی از منابع را به عنوان یک «پتینه» یا لایه ظاهری از اصالت ارائه میدهند، بدون اینکه به طور معنادار با ادبیات موضوع درگیر شوند. در یک مورد، نویسندگان مقاله SciSlop لینکی برای چارچوب NTS ارائه کردند که مرتبط نبود — دقیقاً همان نوع انزوای ارجاعاتی که این ابزار برای شناسایی آن طراحی شده است.
اگر arXiv و سایر مخازن این نوع بنچمارکهای ساختاری را ادغام کنند، ممکن است شاهد تغییری باشیم که در آن «کمک AI» پذیرفتنی باشد، اما «ساختار AI» منجر به رد خودکار شود. صنعتی شدن ارسالیهای پژوهشی، بازگشت به مبنیسازی بنیادین بر اساس شواهد را اجباری میکند.
برای اینکه ببینید پیشنویسهای اخیر شما چه امتیازی میگیرند، میتوانید مقالات خود را از طریق دموی زنده SciSlop تست کنید تا شکافهای شواهدی یا انزوای ارجاعات احتمالی را شناسایی کنید.
گام بعدی شما
- اگر مقاله علمی ارسال میکنید، از دموی زنده SciSlop برای شناسایی شکافهای شواهدی یا انزوای ارجاعات استفاده کنید.
- در بازبینی مقالات، به جای تمرکز بر سبک نوشتار، روی «گراف استدلال» و پیوستگی بخشها تمرکز کنید.
- برای اصلاح متون AI، به جای پرامپتهای کلی برای «بهبود نثر»، از متدهای مبنیسازی بر اساس شواهد (Evidentiary Grounding) استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو