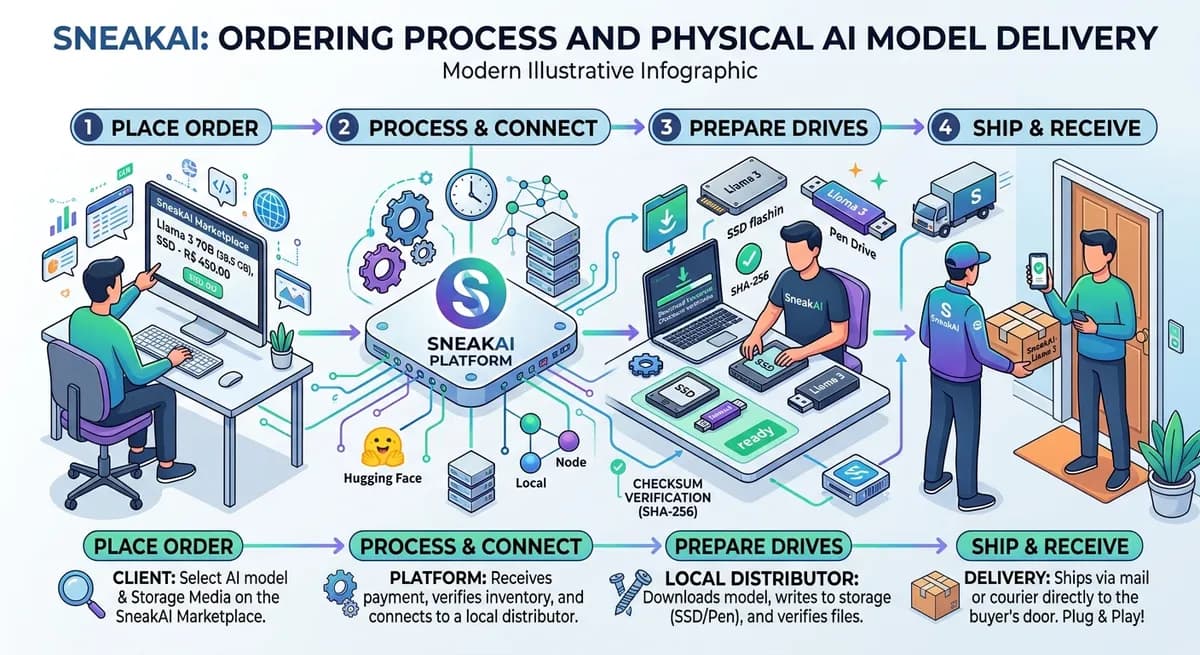
تصور کنید در حال دانلود یک مدل ۷۰ میلیارد پارامتری هستید و درست در ۹۰ درصد پیشرفت، اتصال اینترنت قطع میشود و تمام تلاش شما به باد میرود. SneakAI — پروژهای متنباز که در ۱۴ اکتبر ۲۰۲۶ توسط توسعهدهندهای به نام Aurimar معرفی شد — این قمار دیجیتال را با ارسال فیزیکی دادهها جایگزین میکند.
این رویکرد مستقیماً شکاف زیرساختی در پذیرش هوش مصنوعی را هدف قرار میدهد. مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — به دلیل حجم عظیم، برای بسیاری از کاربران غیرقابل دسترس است. همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی هزینههای استنتاج اشاره کردیم، دسترسی به مدلها اولین سد است؛ برای کاربرانی در مناطقی با پهنای باند محدود، خط لوله سنتی «ابر به سیستم محلی» عملاً قطع است. در همین راستا، تلاشهایی برای بهینهسازی لایههای میانی صورت گرفته است، بهطوری که درگاههای LLM توانستهاند هزینه توکنهای هوش مصنوعی را تا ۸۰٪ کاهش دهند تا دسترسی به مدلها اقتصادیتر شود.
به نقل از مستندات این پروژه در وبسایت dev.to، این سامانه از طریق شبکهای غیرمتمرکز از گرههای محلی و بینالمللی عمل میکند. توزیعکنندگان در این شبکه، مدلهایی با فرمت GGUF را مستقیماً روی حافظههای فیزیکی مینویسند و ارسال میکنند.
معماری فنی
- Runtime: Bun (نسخه ۱.x به بالا)
- Web Framework: Next.js 15+ با استفاده از App Router
- CMS: Payload CMS 3.x برای وارد کردن مدلها از API سایت Hugging Face
- Database: PostgreSQL
- UI: Tailwind CSS و shadcn/ui
این تغییر رویکرد، وزنهای مدل را به جای یک بهروزرسانی نرمافزاری، مانند یک سختافزار گرانبها مدیریت میکند. بر اساس مستندات پروژه، با غیرمتمرکز کردن توزیع، نقطه شکست واحد در هابهای متمرکزی مثل Hugging Face برای کاربران با اینترنت ضعیف حذف میشود. این رویکرد مکمل پیشرفتهایی در زیرساختهای محلی است؛ برای مثال، سرور Superfluid توانسته است زمان پاسخدهی عاملهای محلی را ۳۰ برابر کاهش دهد و بهرهوری اجرای مدلها را در محیطهای غیرابری افزایش دهد.
برای کاربر نهایی، این یعنی «آخرین مایل» استقرار هوش مصنوعی را یک پیک موتوری طی میکند، نه یک کابل فیبر نوری. این مدل، اکتساب مدلهای هوش مصنوعی را به یک اقتصاد فیزیکی همتا-به-همتا تبدیل میکند.
گام بعدی شما
- اگر در منطقهای با اینترنت محدود هستید، کد منبع این پروژه را در گیتهاب بررسی کنید تا با نحوه ایجاد گرههای توزیع آشنا شوید.
- برای کاهش حجم مدلها پیش از توزیع، ابزارهای کوانتش وزنها (Weight Quantization) را مطالعه کنید.
- در مورد مدلهای فرمت GGUF و نحوه اجرای آنها روی سختافزارهای معمولی تحقیق کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو