
آیا یک مدل با ۴ میلیارد پارامتر میتواند رقبایی را که سه برابر بزرگتر هستند، به زانو درآورد؟ مدل باز Spark-X2.5-4B ثابت کرد که پاسخ مثبت است و سقف جدیدی از کارایی در ریاضیات، کدنویسی و گردشکارهای عاملمحور (Agentic) تعریف کرد.
به نقل از مستندات رسمی منتشر شده در ۳ سپتامبر ۲۰۲۶، این مدل فرض قدیمی را که وظایف استدلالی پیچیده حتماً به تعداد پارامترهای بالا نیاز دارند، به چالش میکشد. این عرضه در حالی رخ میدهد که صنعت به سمت مدلهای زبانی کوچک (SLM) حرکت میکند؛ مدلهایی که میتوانند روی سختافزارهای لبه (Edge) اجرا شوند بدون اینکه قدرت «تفکر» مدلهای پیشرو را از دست بدهند. این روند با تلاشهای گسترده شرکتهای بزرگ برای کاهش هزینه استنتاج عاملهای هوش مصنوعی همسو است تا دسترسی به مدلهای قدرتمند ارزانتر شود.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی مدلهای کوچک اشاره کردیم، تمرکز بر کیفیت دادههای آموزشی اکنون بر مقیاس خام غلبه کرده است. این مدل بهطور خاص توسعهدهندگانی را هدف قرار داده که به استدلال سطح بالا در بودجههای محاسباتی محدود نیاز دارند.
محکهای فنی
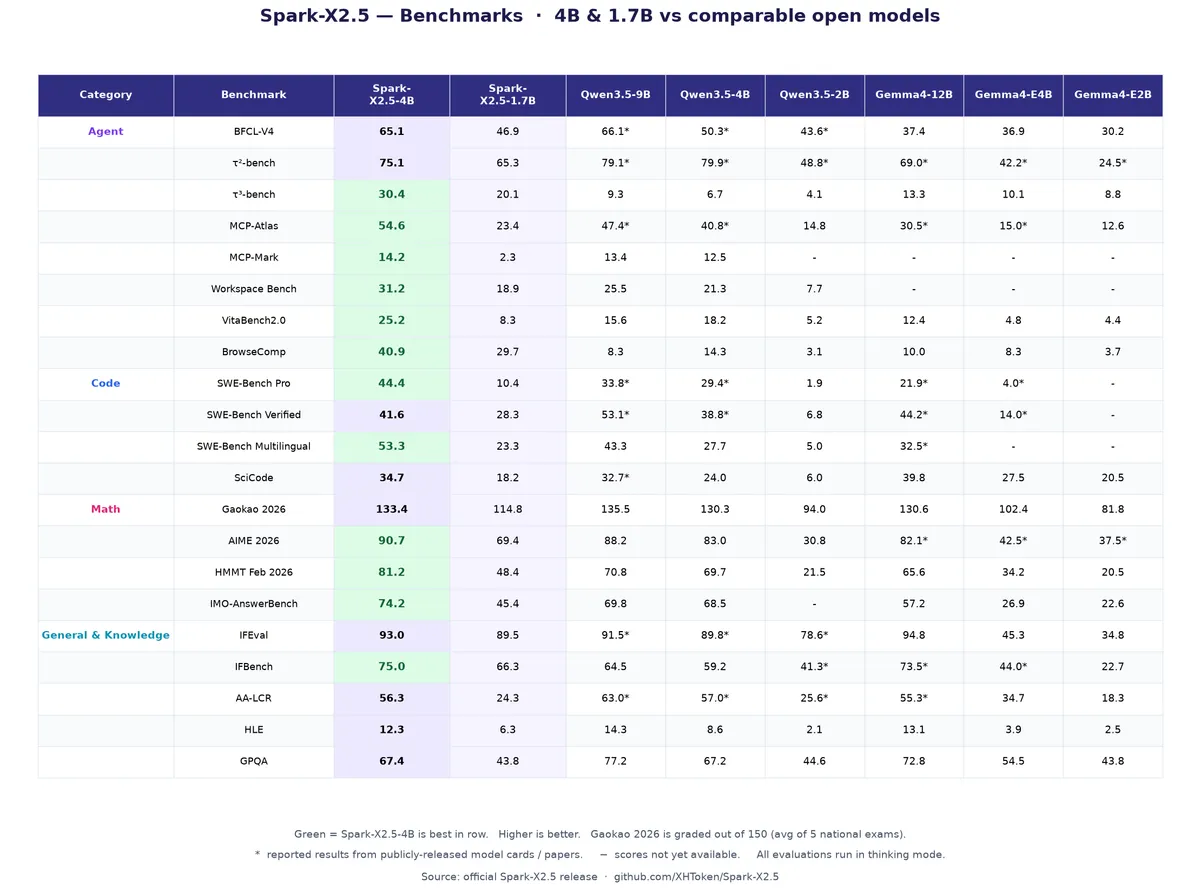
بر اساس دادههای فنی این انتشار، مدل Spark در کلاس اندازه خود در چندین معیار حیاتی پیشتاز است:
- عاملها: کسب امتیاز ۳۰.۴ در $\tau^3$-bench که بهطور قابلتوجهی بالاتر از Qwen3.5-9B (۹.۳) و Gemma4-12B (۱۳.۳) است. همچنین امتیاز ۴۰.۹ در BrowseComp و ۵۴.۶ در MCP-Atlas ثبت شده است.
- کدنویسی: دستیابی به امتیاز ۴۴.۴ در SWE-Bench Pro و پیشی گرفتن از Qwen3.5-9B (۳۳.۸) و Gemma4-12B (۲۱.۹). این جهش در توانایی کدنویسی یادآور پیشرفتهای اخیر DeepSeek در بنچمارکهای عاملمحور است که استانداردهای جدیدی را برای مدلهای باز تعریف کرد.
- ریاضیات: ثبت امتیاز ۹۰.۷ در AIME ۲۰۲۶ و ۸۱.۲ در HMMT فوریه ۲۰۲۶.
یکپارچگی و اکوسیستم
این مدل برای استقرار سریع طراحی شده و با چارچوبهای محبوب عاملها از جمله Codex، Claude Code، OpenClaw و Hermes یکپارچه شده است. در همین راستا، رقابت میان ابزارهای ناوبری وب شدت یافته است، بهطوری که فریمورک eve ورسل در برخی سناریوها بهینهتر از Claude Code عمل کرده است. همچنین یک نسخه کوچکتر ۱.۷ میلیاردی نیز عرضه شده که در برابر رقبای کلاس ۲ میلیاردی رقابتی باقی میماند.
برای جامعه فنی، این نتایج نشان میدهد که کارایی معماری و کیفیت دادههای آموزش اکنون اهمیت بیشتری نسبت به مقیاس مدل دارند. توانایی یک مدل ۴ میلیاردی در تسلط بر رقبای ۱۲ میلیاردی در SWE-bench و AIME، تغییر در نحوه سنجش «هوش» در برابر «ظرفیت» را نشان میدهد.
توسعهدهندگان اکنون میتوانند این مدل را از طریق Hugging Face یا MaaS API برای ارزیابی در خطلولههای عاملمحور خود آزمایش کنند.
گام بعدی شما
- مدل Spark-X2.5-4B را در Hugging Face برای جایگزینی با مدلهای بزرگتر در محیطهای Local تست کنید.
- عملکرد مدل را در وظایف کدنویسی پیچیده با استفاده از چارچوب Claude Code بسنجید.
- نسخه ۱.۷ میلیاردی را برای کاربردهای رایانش لبه با محدودیت VRAM شدید بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو