
اگر امروز برای اجرای مدلهای ۲۷ میلیارد پارامتری روی مکبوک هزینه میکنید، احتمالاً با سرعتی کند روبرو هستید که برای عاملهای خودکار غیرقابلقبول است. اما حالا با موتور TensorFold، یک مکبوک پرو M5 Max میتواند مدلهای متراکم را با سرعت خیرهکننده ۲۲۰ توکن در ثانیه رمزگشایی کند. این جهش عملکردی حاصل بهینهسازی نحوه تأیید رمزگشایی گمانهزنانه (Speculative Decoding) — شبیه به دستیاری که جملات بعدی را حدس میزند و یک استاد سختگیر آنها را در یک نگاه تأیید میکند — روی سختافزار اپل است. طبق اعلام Ash از MIT، توسعهدهنده این موتور، هدف اصلی کاهش شکاف میان هوشمندی مدلهای بزرگ و سرعت لازم برای اجرای عملیات پیچیده کدنویسی بوده است.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی استنتاج در لبه اشاره کردیم، چالش اصلی همواره توازن میان دقت و سرعت بوده است. در حالت عادی، سرعت رمزگشایی مدلهای ۲۷ میلیاردی حدود ۲۶ توکن در ثانیه است؛ یعنی برای خواندن انسان کافی است، اما برای یک عامل (Agent) — مثل کارمندی دیجیتال که هزاران خط کد را در صد مرحله مینویسد — بسیار کند است. این کندی ریشه در محدودیتهای انتقال داده در حافظه دارد که باعث میشود بخش بزرگی از توان پردازشی GPU بلااستفاده بماند. صنعت مدتها به دنبال راهی بوده تا این شکاف را بدون از دست دادن دقت «بایتبهبایت» مدل اصلی پر کند.
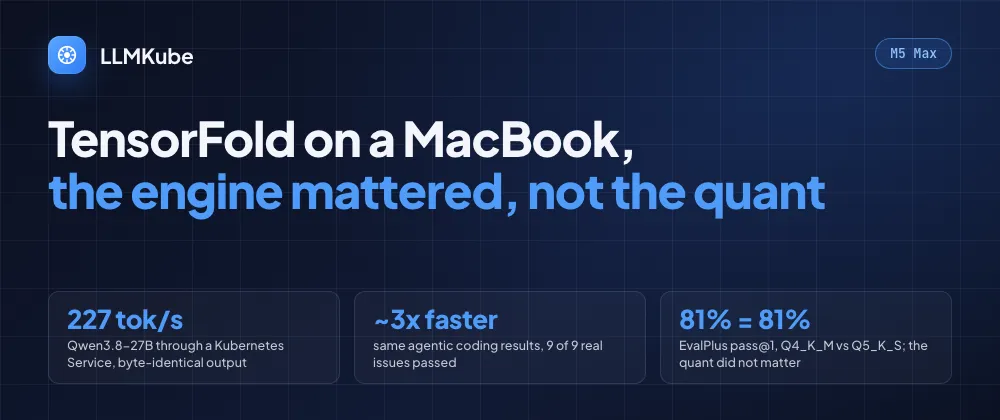
این پیشرفت در کنار ابزار LLMKube عرضه شده است تا مکبوکها را به گرههای استنتاج در خوشههای کوبرنتیز تبدیل کند. LLMKube ابزاری است که موتورهای مک را پشت سرویسهای کوبرنتیز قرار میدهد. به گزارش منابع فنی، اکنون توسعهدهندگان میتوانند یک مکبوک ردهبالا را دقیقاً مانند سرورهای انویدیا یا AMD در یک محیط توزیعشده به عنوان یک گره استنتاج و مجری عملیات در سطح تولید به کار گیرند.
سختافزار و بنچمارکها
آزمایشها روی مکبوک پرو با تراشه M5 Max و ۱۲۸ گیگابایت حافظه یکپارچه انجام شده است. برای تأیید ادعاها، نویسنده از بنچمارکهای موجود در README استفاده کرد و بهطور خاص مدلهای Nemotron 3.5 Lightning و Qwen3.8-27B را با استفاده از مدل پیشنویس DFlash2 تست کرد. در حالی که نتایج Nemotron کاملاً با مستندات مطابقت داشت (و حتی در یک سلول عملکرد بالاتری داشت)، تمرکز اصلی روی Qwen3.8-27B بود، زیرا این مدل یک مدل متراکم در اندازهای است که بهطور گسترده برای کارهای کدنویسی استفاده میشود. این بهینهسازیهای سختافزاری یادآور برتریهای معماری اپل در محاسبات ماتریسی است که پیشتر در تحلیلهای مربوط به ANE و GPU مشاهده شده بود.
بر اساس مستندات منتشر شده، در مواجهه با یک پرامپت YAML کوبرنتیز، مدل Qwen3.8-27B با استفاده از TensorFold به سرعت ۲۲۰ توکن در ثانیه رسید. در مقابل، mlx_lm تنها حدود ۳۱ توکن در ثانیه را مدیریت کرد. شکاف عملکردی در مقایسه با سایر پیکربندیها بسیار عظیم است:
- llama-server (Q4_K_M, بدون گمانهزنی): ۲۶.۴ (کد)، ۲۵.۴ (YAML)، ۲۶.۰ (نثر)
- llama-server (پیشنویس MTP, n-max 3): ۵۰.۸ (کد)، ۵۶.۰ (YAML)، ۳۹.۹ (نثر)
- mlx_lm.server: ۳۱.۴ (کد)، ۳۱.۵ (YAML)، ۳۱.۲ (نثر)
- TensorFold + DFlash2: ۱۳۹ (کد)، ۲۲۰ (YAML)، ۸۵ (نثر)
موتور در برابر پیشنویس
برای درک برتری TensorFold باید به سازوکار رمزگشایی گمانهزنانه نگاه کرد. در این فرآیند، یک مدل کوچک (پیشنویس یا Drafter) توکنهای بعدی را حدس میزند و مدل بزرگ (هدف یا Target) آنها را در یک مرحله (Single Pass) تأیید میکند.
در این تست، نویسنده از مدل پیشنویس DFlash2 از z-lab و وزنهای ۴ بیتی MLX از Vontra استفاده کرد. برای اینکه مشخص شود آیا سرعت حاصل از مدل پیشنویس است یا موتور استنتاج، همان پیشنویس DFlash2 با استفاده از llama.cpp (که اخیراً حالت پیشنویس DFlash و GGUF مربوطه را اضافه کرده است) تست شد. نتایج ثابت کرد که موتور استنتاج عامل تمایز است:
- llama-server + DFlash2 (n-max 3): ۴۸.۱ (کد)، ۵۲.۴ (YAML)، ۳۴.۴ (نثر)
- llama-server + DFlash2 (n-max 7): ۴۶.۸ (کد)، ۵۸.۷ (YAML)، ۲۴.۶ (نثر)
- TensorFold + DFlash2: ۱۳۹ (کد)، ۲۲۰ (YAML)، ۸۵ (نثر)
با پیشنویس یکسان، llama.cpp تنها در کد و YAML به سرعتهای MTP رسید و در متون ادبی (نثر) در طول پیشنویس توصیه شده، حتی از حالت بدون گمانهزنی کندتر شد. TensorFold عملکردی ۲.۵ تا ۳.۷ برابر بیشتر از مدل پیشنویس یکسان ارائه میدهد. راز این موفقیت در مرحله تأیید است: TensorFold یک درخت کامل از توکنهای کاندید را در یک مرحله بررسی میکند و هزینه تأیید دستهای (Batched Verify) آن تقریباً با یک مرحله تکردی برابر است.
عملکرد در دنیای واقعی و توهم
سرعت زمانی بیمعنی است که مدل دچار توهم (Hallucination) شود یا پاسخهای خود را تغییر دهد. نویسنده ۱۶ مورد تست مختلف — ترکیبی از رمزگشایی نمونهبرداری شده (Sampled) و حریصانه (Greedy) در چهار نوع پرامپت — را اجرا کرد و دریافت که خروجیهای پیشنویس در تمام موارد بهصورت بایتبهبایت با خروجیهای بدون پیشنویس مطابقت دارد. یک نکته فنی: تست «چهار درخواست همزمان» روی نسخهای اجرا شد که درخواستهای همزمان را در صف قرار میدهد؛ پشتیبانی واقعی از چند جریانی (Multi-stream) بعدها توسط Ash عرضه شد.
با این حال، میزان بهرهوری بسته به نوع کار متغیر است. متون تکراری و پیشبینیپذیر، مانند YAML کوبرنتیز و کدهای منبع، بیشترین افزایش سرعت را دارند زیرا حدسهای پیشنویس در اکثر مواقع درست از آب در میآیند. نثر کمتر پیشبینیپذیر است و افزایش سرعت در آن به حدود ۲.۷ برابر کاهش مییابد. از آنجایی که ترافیک عاملهای کدنویس عمدتاً شامل کد، YAML و فراخوانی ابزار است، این موتور دقیقاً برای مهندسان نرمافزار AI بهینه شده است.
افسانه کوانتش
یکی از یافتههای غافلگیرکننده این بود که کوانتش سفارشی برای این مدل اهمیت چندانی ندارد. نویسنده تلاش کرد یک کوانتش سفارشی ایجاد کند که بر اساس ۱.۵ میلیون توکن از ترافیک واقعی عاملها (استخراج شده از جلسات LLMKube) کالیبره شده باشد.
مقایسه کوانتش سفارشی با یک مجموعه عمومی جامعه نشان داد که مجموعه عمومی اغلب به همان اندازه خوب یا حتی برای نثر بهتر است. در سطح Q5_K_S، برتری مدل عامل بهطور کامل از بین رفت. علاوه بر این، imatrix در حدود ۶۵ هزار توکن اشباع شد، به این معنی که مجموعه دادههای بزرگتر هیچ سودی نداشت.
در طول این فرآیند، نویسنده به دنبال یک «شبح» بود؛ جایی که یک کوانتش ۸ بیتی در ۱٪ از توکنهای عامل با BF16 اختلاف داشت. در نهایت مشخص شد که این مشکل مربوط به خود مدل است: در لیستهای تراز شده با ستون (مانند ls -la)، مدل Qwen3.8-27B با اطمینان کامل اشتباه میکند و نام فایلهای قبلی را در ستونهای اشتباه کپی میکند. این اتفاق در BF16، کرنلهای Metal، بکاندهای CPU و حتی Hugging Face transformers روی DGX Spark با استفاده از CUDA رخ داد.
در تستهای HumanEval+ و MBPP+ (۵۴۲ مسئله)، نتایج در سطوح مختلف کوانتش تقریباً یکسان بود:
- Q4_K_M: نرخ موفقیت ۸۱.۲٪ pass@1 (زمان ۶۸ دقیقه)
- Q5_K_S: نرخ موفقیت ۸۱.۲٪ pass@1 (زمان ۹۴ دقیقه)
- TensorFold 4-bit: نرخ موفقیت ۸۲.۱٪ pass@1 (زمان ۱۰.۶ دقیقه)
اگرچه وزنهای ۴ بیتی انحراف توکن-محور بیشتری نسبت به BF16 داشتند (۸۶٪ تطابق در مقابل ۹۱٪ برای Q4_K_M)، اما این موضوع به شکست در کدنویسی منجر نشد. در یک تست واقعی برای حل سه مشکل واقعی در LLMKube، TensorFold کارها را در ۶۰ دقیقه به پایان رساند، در حالی که کوانتشهای llama.cpp برای هر مورد حدود ۱۸۵ دقیقه زمان نیاز داشتند. هر نه اجرای انجام شده (سه مورد برای هر رقیب) از تستهای پکیج، مجموعه تست کامل، لینتینگ در دو پلتفرم و «بررسی گاز» (Bite Check - جایی که کد اصلی بازگردانده میشود تا اطمینان حاصل شود تستهای جدید شکست میخورند) عبور کردند.
دادههای مقایسهای کوانتش
برای تحلیل بیشتر توازن بین اندازه و دقت، نویسنده چندین دستورالعمل GGUF را با تطابق توکنهای برتر BF16 مقایسه کرد:
- Q4_K_M (۱۶.۸ گیگابایت): ۹۰.۷٪ متن عامل / ۹۴.۹٪ نثر
- Attention + DeltaNet در ۶-بیت (۱۸.۴ گیگابایت): ۹۲.۵٪ متن عامل / ۹۵.۹٪ نثر
- Q5_K_S (۱۹.۰ گیگابایت): ۹۴.۱٪ متن عامل / ۹۷.۱٪ نثر
- Attention + DeltaNet در ۸-بیت (۲۰.۱ گیگابایت): ۹۲.۸٪ متن عامل / ۹۶.۰٪ نثر
نسخه ساده Q5_K_S تمام دستورالعملهای هدفمند، حتی نسخههای بزرگتر را با اختلاف حدود ۲ برابر شکست داد. فرمتهای MLX نیز داستان مشابهی داشتند: MLX 4-bit با فاصله زیادی از GGUF Q4_K_M عقب است و برای رسیدن به آن سطح، به حدود ۵ بیت در MLX نیاز دارد. فرمتی که TensorFold اجرا میکند (4-bit affine با گروه ۶۴)، در ۸۶ درصد توکنهای عامل با BF16 موافق بود، در حالی که این رقم برای Q4_K_M حدود ۹۱ درصد است.
چالشهای استقرار
استقرار این سیستم در یک خوشه کوبرنتیز از طریق LLMKube چندین باگ تولیدی را آشکار کرد. چون Metal نمیتواند داخل کانتینر اجرا شود، LLMKube از یک عامل کوچک استفاده میکند که بهطور بومی تحت launchd اجرا میشود. این عامل موتورها را استارت میزند و آنها را به عنوان سرویس با یک EndpointSlice ثبت میکند. پادها با یک ClusterIP معمولی صحبت میکنند و هرگز نمیفهمند که مدل روی یک لپتاپ قرار دارد.
یک مشکل بزرگ مربوط به llama.cpp 0.5.0 بود که پرچم --mlock را حذف کرده بود. چون عامل LLMKube همچنان این پرچم را ارسال میکرد، موتورها فوراً کرش میکردند. با این حال، عامل متوجه نبود که پروسه بسته شده است و تا زمان تایماوت دو دقیقهای، همچنان یک نقطه انتهایی سلامت (Health Endpoint) را بررسی میکرد. این موضوع باعث مسدود شدن تمام مدلهای دیگر در صف مک میشد. تنها خط لاگ موجود «timeout waiting for health check» بود.
دو اصلاحیه اعمال شد: اکنون عامل از llama-server میپرسد که چه پرچمهایی را پشتیبانی میکند و پروسه فرزند را زیر نظر میگیرد، که باعث میشود شکستهای استارتآپ در حدود ۱۵۰ میلیثانیه همراه با وضعیت خروج و لاگهای موتور بازگردانده شوند.
اصلاحات دقیق و پسرویها
علاوه بر مشکل پرچم، چندین شکاف دیگر برای پایدار کردن گردش کار «مک-به-عنوان-گره» پر شد:
- پسروی Enum رانتایم: لیست رانتایم در InferenceService CRD فقط موتورهای داخل خوشه را فهرست میکرد و بهطور پیشفرض روی
llamacppبود. در ماه ژوئن، عامل تغییر کرد تا فیلد مربوط به هر مدل را بر پرچم خود ترجیح دهد. چون Admission این پیشفرض را روی هر شیء پر میکرد، پرچم دیگر هرگز برنده نمیشد. هر موتور مک به جز llama.cpp برای سه ماه غیرقابل دسترس بود. اصلاحیه، موتورهای مک را به Enum اضافه کرد و پیشفرض را حذف نمود. - بررسیهای جایگاه (Placement): اپراتور اکنون از پذیرش یک موتور مخصوص مک برای مدلی که روی مک نیست خودداری میکند، به جای اینکه بیصدا یک Deployment llama.cpp با لیبل اشتباه بسازد.
- مدیریت مسیرها: باگی که در آن مدلهایی با مسیرهای محلی مطلق به عنوان URL دانلود تلقی میشدند، برطرف شد.
- آمادگی نقطه انتهایی: مشکلی حل شد که در آن نقطه انتهایی برای مدلی که عامل نمیتوانست استارت بزند، همچنان وضعیت
ready: trueرا گزارش میکرد و ترافیک را به یک پورت بسته میفرستاد. - شبکهسازی: خطای
dial tcp ... i/o timeoutرخ میداد زیرا مک تحت آدرس Tailscale ثبت شده بود که برخی گرهها به آن دسترسی نداشتند. این مشکل با استفاده از پرچم--host-ipبرای آدرس LAN مک حل شد.
الزامات فنی برای راهاندازی
برای بازتولید این سرعتها روی M5 Max، نویسنده پیکربندی زیر را توصیه میکند:
- نسخهها: نصب TensorFold v0.3.4.1 (bb4b4a3) و MLX 0.31.2. توجه داشته باشید که MLX 0.32.2 در تست بررسی دقت زمان بارگذاری برای Nemotron روی M5 شکست میخورد، که بهطور بیصدا پیشنویسها را غیرفعال کرده و سیستم را به رمزگشایی سریال برمیگرداند.
- تنظیم پیشنویس: مدل پیشنویس را یکبار با کاربری که عامل با آن اجرا میشود، Pull کنید. TensorFold پیشنویس را بر اساس خانواده مدل از کش Hugging Face برمیدارد. اگر موجود نباشد، بدون هیچ پیام خطایی سرعت ۲۷ توکن در ثانیه را دریافت خواهید کرد.
- اجرای عامل: عامل را با
--tensorfold-binاستارت بزنید و در InferenceService مقدارruntime: tensorfoldرا قرار دهید. - پنجره کانتکست: مقدار
contextSizeرا بهطور صریح تنظیم کنید. اگر تنظیم نشود، عامل بهجای پنجره کامل مدل، بهطور پیشفرض روی ۲۰۴۸ توکن تنظیم میشود.
مشخصات استقرار
برای استقرار TensorFold پشت یک سرویس کوبرنتیز، از مشخصات YAML زیر استفاده میشود:
apiVersion: inference.llmkube.dev/v1alpha1
kind: Model
metadata:
  name: qwen38-27b-mlx
spec:
  source: lmstudio-community/Qwen3.8-27B-MLX-4bit
  format: mlx
  hardware:
    accelerator: metal
---
apiVersion: inference.llmkube.dev/v1alpha1
kind: InferenceService
metadata:
  name: qwen38-27b-tensorfold
spec:
  modelRef: qwen38-27b-mlx
  runtime: tensorfold
  replicas: 1
  contextSize: 65536
تست از یک پاد داخل خوشه نشان داد که مسیر کوبرنتیز حدود ۲ درصد از عملکرد را کاهش میدهد. YAML کوبرنتیز با سرعت ۲۲۷.۵ توکن در ثانیه (در مقابل ۲۳۱ مستقیم)، کد با ۱۴۴.۶ (در مقابل ۱۴۷ مستقیم) و نثر با ۸۹.۹ (در مقابل ۹۲ مستقیم) اجرا شد.
رسیدها و نسخههای نهایی
برای کسانی که قصد بازرسی نتایج را دارند، نسخههای زیر استفاده شده است:
- TensorFold: v0.3.4.1 (bb4b4a3) با MLX 0.31.2.
- llama.cpp: بیلد Homebrew 0.5.0 با هش 7fe450e19.
- لایسنس: Qwen3.8-27B تحت Apache-2.0 و TensorFold تحت MIT است.
- PRهای LLMKube: اصلاحات در #1912 (Enum رانتایم)، #1916/#1917 (پرچمهای llama.cpp/fail-fast)، #1920/#1921 (مسیرهای محلی/نقاط انتهایی) و #1923 (رانتایم TensorFold) اعمال شدند.
این تغییر نشان میدهد که برای عاملهای AI محلی، انتخاب موتور استنتاج بسیار تعیینکنندهتر از دستورالعمل خاص کوانتش است. توانایی اجرای یک مدل ۲۷ میلیاردی با سرعت بیش از ۲۰۰ توکن در ثانیه، مک را از یک رابط چت ساده به یک گره viable برای گردش کارهای عاملمحور با توان عملیاتی بالا تبدیل میکند.
گام بعدی شما
- اگر از مکبوکهای سری M استفاده میکنید، TensorFold را جایگزین mlx_lm کنید تا سرعت تولید کد را تا ۷ برابر افزایش دهید.
- برای استقرار در محیطهای تیمی، از LLMKube برای تبدیل لپتاپهای قدرتمند به گرههای استنتاج استفاده کنید.
- در تنظیمات مدل، حتماً
contextSizeرا متناسب با نیاز مدل (مثلاً ۶۵۵۳۶) تعریف کنید تا از محدودیت پیشفرض ۲۰۴۸ توکن رها شوید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو