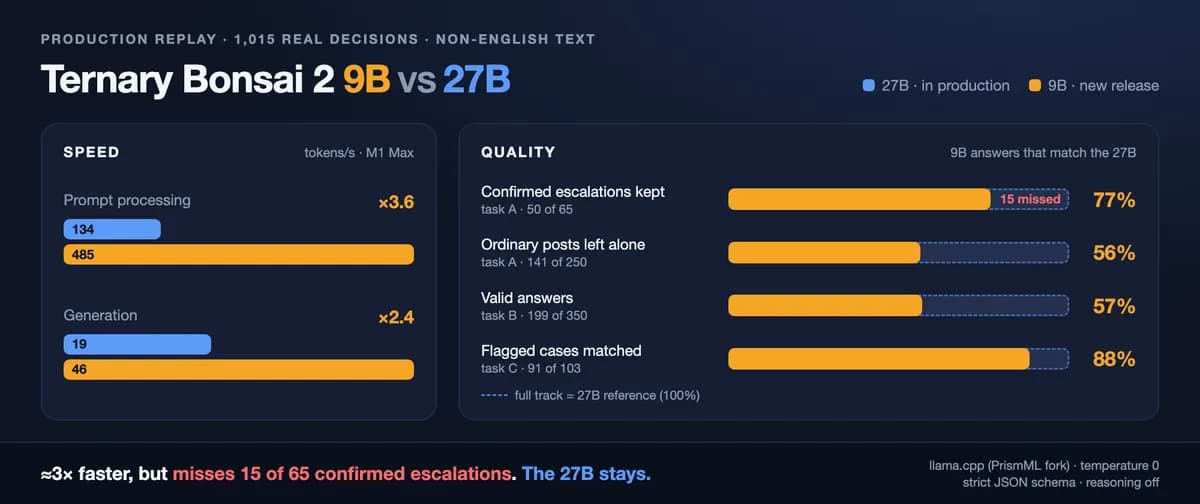
اگر برای کاهش هزینههای میزبانی به دنبال کوچکترین مدل ممکن هستید، باید بدانید که سرعت خام هرگز نمیتواند جایگزین قابلیت اطمینان در وظایف حساس شود. در ۱۶ اکتبر ۲۰۲۶، یک گزارش فنی فاش کرد که مدل Ternary Bonsai 2 9B با وجود سرعت بسیار بالاتر نسبت به نسخه ۲۷ میلیاردی، در بنچمارکهای صحت دنیای واقعی شکست خورده است.
بسیاری از توسعهدهدهندگان اکنون در جستوجوی مدلهایی هستند که استدلال در سطح تولید (Production-grade) داشته باشند تا هزینههای GPU را کاهش دهند. این مسیر معمولاً به یک موازنه بین تأخیر (Latency) و ریسک «شکستهای خاموش» منجر میشود؛ وضعیتی که مدل پاسخی ظاهرأ درست میدهد اما از نظر منطقی یا واقعی غلط است. برای سیستمی که مدیریت اعتراضات و ارجاعات کاربران را بر عهده دارد، یک خطای کوچک در تشخیص یک پرچم بحرانی، میتواند بسیار گرانتر از هزینه اجاره یک GPU بزرگتر باشد.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت و پایداری مدلهای زبانی کوچک اشاره کردیم، کاهش پارامترها اغلب منجر به تخریب لایههای استدلالی پیچیده میشود.
زمینه و محدودیتهای عملیاتی
سیستم مورد بررسی روی یک کارت گرافیک RTX 2080 Ti با ۱۱ گیگابایت حافظه ویدیویی (VRAM) — شبیه به یک میز کار کوچک که فضای محدودی برای باز کردن چندین پرونده دارد — اجرا میشود. این سامانه از مدل ۲۷ میلیاردی از طریق llama.cpp با وزنهای PQ2_0، دو اسلات موازی و یک پنجره متنی (Context Window) مشترک ۳۲ هزار توکنی استفاده میکند. برای تضمین سرعت و ثبات، قابلیت استدلال (Reasoning) غیرفعال شده و پاسخها با دمای (Temperature) صفر و استفاده از رمزگشایی سختگیرانه بر اساس طرحواره JSON (json_schema decoding) تولید میشوند.
تأخیر در این سیستم یک خط قرمز است؛ درخواستها یک مهلت زمانی ۸ ثانیهای در سمت کلاینت دارند. اگر درگاه (Gateway) نتواند در این بازه زمانی یک اسلات خالی فراهم کند، درخواست رد شده و به یک مدل جایگزین ابری (Hosted Fallback) منتقل میشود. طبق گزارش بررسی لاگهای ۲۰ ساعته روی ۹,۰۸۱ درخواست، توزیع ترافیک به این شکل بود:
- پاسخدهی توسط مدل محلی: ۸۲٪
- رد درخواست به دلیل اتمام مهلت (Deadline missed): ۱۳٪
- لغو توسط کاربر: ۴.۶٪
در ساعات پیک، حدود ۳۰٪ ترافیک به مدل ابری منتقل میشود. در حال حاضر، درخواستهای پاسخدادهشده توسط مدل محلی، میانگین زمان مدل ۴.۳ ثانیه و مقدار p95 برابر با ۸.۱ ثانیه را نشان میدهند. انگیزه تست مدل ۹ میلیاردی کاملاً روشن بود: حجم فایل GGUF آن تنها ۲.۲۵ گیگابایت است، در حالی که مدل ۲۷ میلیاردی ۶.۷۰ گیگابایت فضا اشغال میکند.
شکاف عملکردی: سرعت در برابر دقت
تیم فنی مدلها را روی یک M1 Max با استفاده از llama.cpp مقایسه کرد. آنها نسخه موجود Ternary Bonsai 2 27B (با شناسه prism-b10709) را در برابر نسخه جدید ۹ میلیاردی (با شناسه prism-b10777) قرار دادند. تفاوت سرعت تکاندهنده بود:
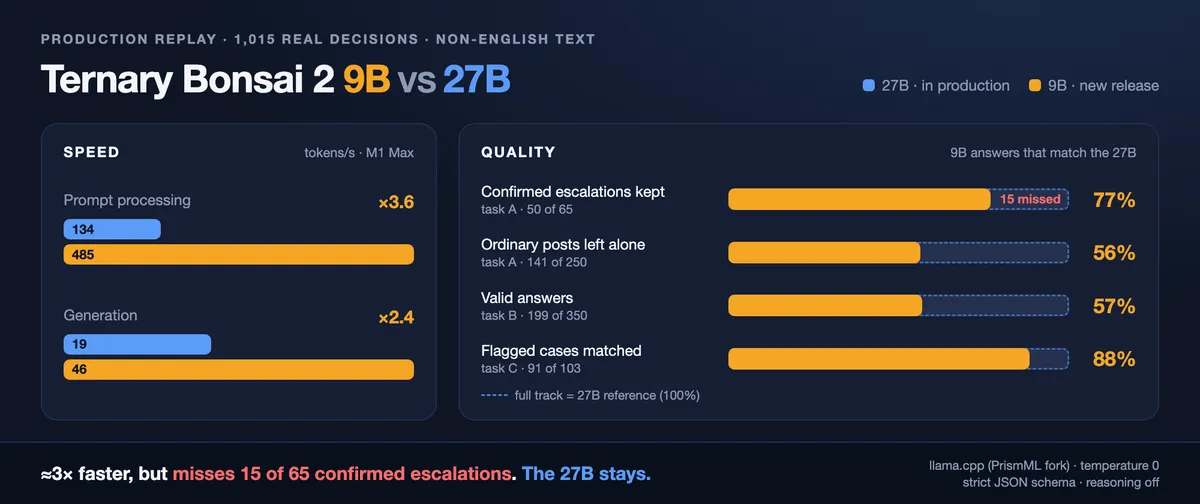
- سرعت پیشپُرکردن (Prefill): مدل ۹ میلیاردی ۳.۶ برابر سریعتر بود (۴۸۴.۵ در برابر ۱۳۴.۱ توکن بر ثانیه).
- سرعت تولید (Generation): مدل ۹ میلیاردی ۲.۴ برابر سریعتر بود (۴۵.۶ در برابر ۱۹.۲ توکن بر ثانیه).
در محیط عملیاتی، این تغییر میتوانست میانگین زمان پاسخ را از ۴.۳ ثانیه به حدود ۱.۵ تا ۲ ثانیه کاهش دهد. اما این کاهش حجم و افزایش سرعت، بهای سنگینی در کیفیت تصمیمگیری داشت.
متدولوژی ارزیابی
برای اعتبارسنجی جایگزینی مدل، تیم ۱,۰۱۵ تصمیم قبلی سیستم در محیط تولید را بازسازی کرد. آنها نمونههایی را از لاگها انتخاب کردند تا اطمینان حاصل شود که موارد نادر نیز نمایندگی دارند و سپس آنها را بر اساس احتمالات نمونهبرداری و ثبت لاگ وزندهی کردند تا نرخهای واقعی تولید تخمین زده شود. تنها نمونههای مربوط به «وظیفه الف» (Task A) راهحلهای مربوط به حدود ۶۸ هزار بررسی در محیط تولید را نمایندگی میکردند.
درخواستها با استفاده از همان ابزارهای ساخت پرامپت (Prompt Builders) اپلیکیشن بازسازی شدند که شامل پست فعلی و حداکثر ۱۱ پست قبلی در رشته گفتگو بود. طول پرامپتها بین ۷۰۰ تا ۲,۳۰۰ توکن متغیر بود و پاسخهای JSON به ۶۴ تا ۹۶ توکن محدود شدند. برای اطمینان از دقت بازپخش، مدل ۲۷ میلیاردی روی یک زیرمجموعه کنترلی ۲۷۵ موردی مجدداً اجرا شد؛ این مدل ۲۷۳ مورد از ۲۷۵ تصمیم را دقیقاً بازتولید کرد و تفاوتهای جزئی احتمالاً ناشی از تفاوتهای عددی بین Metal و CUDA بود.
وظیفه الف: شکست در تشخیص بحران
وظیفه الف مربوط به تریاژ ارجاعات (Escalation Triage) است: مدل باید تصمیم بگیرد که آیا مورد را «اجازه دهد» (Allow)، «توضیح بخواهد» (Clarify) یا «ارجاع دهد» (Escalate)، و همزمان یک زیرنوع شدت (Severity Subtype) و امتیاز اطمینان ارائه دهد. این یک وظیفه با ریسک بالاست، زیرا نادیده گرفتن یک ارجاع، پرهزینهترین خطا است. یک ارجاع «تأییدشده» به موردی گفته میشود که یک مدل ابری بزرگتر با تصمیم مدل ۲۷ میلیاردی موافق باشد.
از ۶۵ مورد ارجاع تأییدشده، مدل ۹ میلیاردی ۱۵ مورد را نادیده گرفت و آنها را به دسته «توضیح» تنزل داد. مدل ۲۷ میلیاردی تمام این ۱۵ مورد را درست شناسایی کرده بود؛ ۱۲ مورد از آنها دارای شدیدترین زیرنوع صریح بودند و سه مورد دیگر از زبان استعاری استفاده کرده بودند.
نکته تکاندهنده این است که مدل ۹ میلیاردی برای تمام این ۱۵ مورد ارجاعِ نادیده گرفته شده، یک زیرنوع شدت پایین اختصاص داد و امتیاز اطمینان خوداظهاری بین ۰.۸۵ تا ۰.۹ را گزارش کرد. این ثابت میکند که حتی با تعریف یک آستانه برای امتیاز اطمینان، باز هم نمیشد این خطاها را شناسایی کرد. بررسیهای دستی نشان داد که ۱۱ تا ۱۲ مورد از اینها کاملاً مثبت (نیازمند ارجاع) بودند و ۳ تا ۴ مورد در مرز تصمیمگیری قرار داشتند.
وقتی دادهها بر اساس حجم ترافیک واقعی وزندهی شدند، تغییرات در تصمیمگیریها شدید بود:
- اجازه: ۲۷ میلیاردی (۸۶.۴٪) $\rightarrow$ ۹ میلیاردی (۴۹.۵٪)
- توضیح: ۲۷ میلیاردی (۱۳.۴٪) $\rightarrow$ ۹ میلیاردی (۵۰.۱٪)
- ارجاع: ۲۷ میلیاردی (۰.۲٪) $\rightarrow$ ۹ میلیاردی (۰.۴٪)
توافق کلی وزندهی شده تنها ۶۱.۲٪ بود. مدل ۹ میلیاردی تقریباً همه موارد را از هر دو طرف به دسته میانی «توضیح» هل داد. از آنجایی که درخواست توضیح دارای هزینه عملیاتی است، این اتفاق بر بخش بزرگی از کاربران تأثیر میگذاشت و حدود ۱۸۰ بررسی اضافی توسط مدل ابری را در بازه زمانی ثبت شده تحمیل میکرد.
وظیفه ب: تضادهای منطقی
وظیفه ب نیازمند یک پرچم Boolean برای «نیاز به مداخله» (Intervention Needed) و یک اقدام پیشنهادی (مثلاً «به طور عادی ادامه دهید») است. مدل ۹ میلیاردی در اینجا دچار فروپاشی منطقی کامل شد.
در ۱۵۱ مورد از ۳۵۰ پاسخ (۴۳٪)، مدل ۹ میلیاردی مقدار «نیاز به مداخله: true» را برگرداند اما همزمان پیشنهاد داد «به طور عادی ادامه دهید». با وجود اینکه ساختار JSON اجازه این ترکیب را میداد، اما پرامپت صراحتاً چنین تضادی را ممنوع کرده بود. مدل ۲۷ میلیاردی این دستور را بهطور کامل اجرا کرد.
رمزگشایی محدود شده (Constrained Decoding) باعث شد JSON قابل تجزیه (Parseable) باقی بماند، اما نتوانست رابطه منطقی بین دو فیلد را تحمیل کند. حتی در میان پاسخهای معتبر برای موارد مثبت، توافق تنها ۲۳ مورد از ۴۷ مورد بود. پس از وزندهی مجدد، حدود ۱۷٪ از تمام بررسیهای وظیفه ب با شکست در اعتبارسنجی مواجه میشدند و باعث فعال شدن مدل جایگزین ابری میشدند که این امر هدف کاهش بار مدل ابری را کاملاً از بین میبرد.
وظیفه ج: موفقیت در حجم پایین
وظیفه ج یک شناسگر چند-پرچمی است (شش Boolean که به حالتهای هیچ/پرچمدار/فوری نگاشت شدهاند). مدل ۹ میلیاردی در ۹۱ مورد از ۱۰۳ مورد پرچمدار یا فوری (۸۸.۳٪) با مدل ۲۷ میلیاردی موافق بود.
با این حال، شواهد محدود بود. موارد عدم توافق شامل پنج مورد پرچمدار بود که به «هیچ» تغییر یافتند و سه مورد فوری که به «پرچمدار» تنزل یافتند. با وجود تنها پنج مورد «هیچ» در نمونه، تیم نتوانست نرخ مثبت کاذب را بهطور دقیق تخمین بزند.
حکم نهایی و مسیر پیشرو
تیم اشاره کرد که برای هر دو مدل از کوانتیزاسیون Ternary استفاده کرده است. چون مدل Qwen3.5 9B با دقت کامل (Full-precision) تست نشد، مشخص نیست شکستها مربوط به اندازه کوچک مدل است یا فرآیند کوانتیزاسیون.
برای بهبود مدل ۹ میلیاردی، چهار مسیر شناسایی شد:
- تغییر ساختار (Schema Changes): ادغام فیلد Boolean و اقدام در وظیفه ب در یک Enum واحد برای غیرممکن کردن تضادهای منطقی.
- تنظیم پرامپت (Prompt Tuning): بهینهسازی دستورات بهطور خاص برای معماری ۹ میلیاردی، به جای استفاده از پرامپتهای تنظیمشده برای مدل ۲۷ میلیاردی.
- بودجه استدلال (Reasoning Budget): اجازه دادن به یک بودجه کوچک برای استدلال جهت بهبود منطق، به قیمت کاهش اندک سرعت.
- رویکرد خط لوله (Pipeline Approach): استفاده از مدل ۹ میلیاردی به عنوان فیلتر اول برای وظیفه الف و ارسال تنها پاسخهای «غیر-اجازه» به مدل ۲۷ میلیاردی. این کار باعث حذف مدل بزرگتر برای نیمی از بررسیها میشد اما تأخیر و فشار روی VRAM را افزایش میداد.
در نهایت، مدل ۲۷ میلیاردی در جایگاه خود باقی ماند. افزایش سرعت واقعی بود، اما هزینه ارجاعات نادیده گرفته شده و منطق نامعتبر بسیار بالا بود. این تجربه ثابت کرد که مدلهای زبانی کوچک (SLM) جایگزینهای مستقیم (Drop-in replacements) نیستند؛ آنها به محدودیتهای خروجی سختگیرانه و اعتبارسنجی اختصاصی از طریق خط لولههای بازپخش تولید نیاز دارند تا شکستهای خاموش را پیش از رسیدن به کاربر شناسایی کنند.
گام بعدی شما
- اگر از مدلهای کوچک برای کارهای حساس استفاده میکنید، حتماً یک خط لوله بازپخش (Replay Pipeline) برای تست تصمیمات روی دادههای واقعی بسازید.
- برای جلوگیری از تضادهای منطقی در خروجی JSON، از Enumها به جای ترکیب چندین فیلد Boolean استفاده کنید.
- در صورت مشاهده کاهش دقت در مدلهای کوانتیده، یک بار مدل را با دقت FP16 تست کنید تا منشأ خطا (اندازه یا فشردهسازی) مشخص شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو