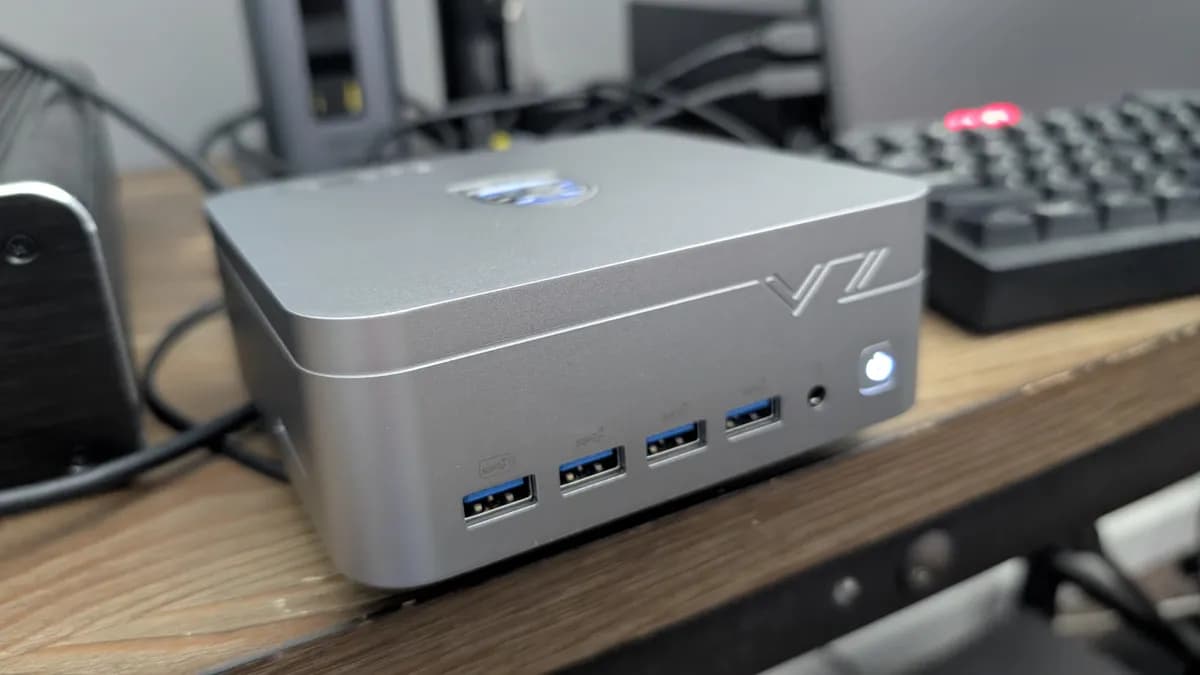
تصور کنید یک کامپیوتر کوچکتر از کف دست شما، ۱۵۰۰ خط کد کاربردی تولید کند بدون آنکه حتی یک لحظه موس شما روی صفحه خشک شود. مینیپیسی VZmore AX Max ثابت کرد که سختافزار اختصاصی هوش مصنوعی در ابعاد کوچک میتواند جایگزین ایستگاههای کاری حجیم برای جریانهای کاری مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — شود.
سالها بود که اجرای هوش مصنوعی محلی یک انتخاب دوگانه داشت: یا خرید یک کیس عظیم با کارت گرافیک انویدیا، یا پذیرفتن سیستمی که هر بار مدل شروع به فکر کردن میکرد، کاملاً یخ میزد. اکثر ماشینهای غیرانویدیا هنگام انجام کارهای پیچیده دچار «توقف کامل» (grinding halts) میشوند و تا زمانی که هوش مصنوعی پاسخ را تمام نکند، کامپیوتر غیرقابل استفاده است. این موضوع برای کاربرانی که به دنبال حریم خصوصی دادهها و قابلیتهای آفلاین هستند اما نمیخواهند عملکرد سیستم اصلیشان فدا شود، یک مانع بزرگ بود. این تمایل به انتقال پردازش از ابر به سختافزار شخصی، مشابه رویکردی است که پرتپلکسی برای مدیریت دادههای حساس در پردازش محلی در پیش گرفته است.
چالشهای هوش مصنوعی محلی
اجرای هوش مصنوعی محلی معمولاً به پیچیدگی وظیفه بستگی دارد. یک سؤال ساده سریع پاسخ داده میشود، اما درخواست نوشتن یک اپلیکیشن کامل، اغلب دسکتاپهای استاندارد را به بنبست میکشاند. این اتفاق بهویژه در ماشینهای فاقد GPU انویدیا رخ میدهد، جایی که بار پردازشی تمام منابع سیستم را میبلعد و باعث میشود سیستم در حین پردازشهای سنگین عملاً از کار بیفتد.
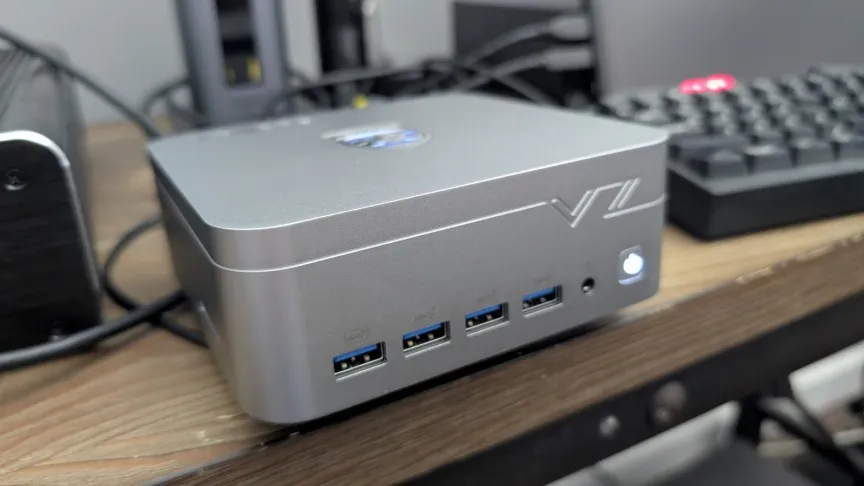
به گزارش ZDNET، دستگاه VZmore AX Max این الگو را با استفاده از یک موتور تخصصی هوش مصنوعی میشکند. این ماشین از پردازنده AMD Ryzen AI 9 HX 470 و گرافیک Radeon 890M بهره میبرد. اگرچه این دستگاه کارت گرافیک مجزای انویدیا ندارد، اما یک واحد پردازش عصبی (NPU) — شبیه به یک دستیار متخصص که فقط کارهای ریاضی هوش مصنوعی را انجام میدهد تا پردازنده اصلی خسته نشود — بر پایه معماری XDNA 2 را در خود جای داده است.
زمینه سختافزاری
این دستگاه دقیقاً برای جریانهای کاری هوش مصنوعی محلی طراحی شده تا وابستگی به سرویسهای ابری را کم کرده و دادههای حساس را روی خود دستگاه نگه دارد. ابعاد آن تنها ۵.۳ در ۵.۲ در ۲.۳ اینچ است که اجازه میدهد در فضاهای تنگ جای بگیرد و در عین حال قدرت کافی برای جلوگیری از کند شدن هنگام پردازشهای سنگین را داشته باشد. این تلاش برای کوچکسازی سختافزار استنتاج، یادآور راهاندازی Portable Computer توسط پرتپلکسی برای محلی کردن عاملهای هوش مصنوعی است.
مشخصات فنی دقیق دستگاه:
- پردازنده (CPU): AMD Ryzen AI 9 HX 470 (معماری Zen 5؛ ۱۲ هسته / ۲۴ رشته: شامل ۴ هسته Zen 5 و ۸ هسته Zen 5c)
- گرافیک (GPU): AMD Radeon 890M (۱۶ واحد پردازشی یا Compute Units، با فرکانس تا ۳.۱ گیگاهرتز)
- عملکرد AI: تا ۵۵ NPU TOPS (مجموعاً ۸۶ TOPS برای کل سیستم)
- حافظه (RAM): ۳۲ گیگابایت DDR5 (قابلیت ارتقا تا ۲۵۶ گیگابایت DDR5)
- ذخیرهساز: ۱ ترابایت PCIe 4.0 SSD (قابلیت ارتقای دوگانه PCIe 4.0 تا ۵ ترابایت)
- سیستم خنککننده: معماری V-Cooling نسل جدید با محفظه بخار (VC)، ورودی هوای ۳۶۰ درجه از کف و صدای کم (~۳۸ دسیبل) با توان حرارتی پایدار (TDP) تا ۶۵ وات
- سیستمعامل: ویندوز ۱۱ پرو
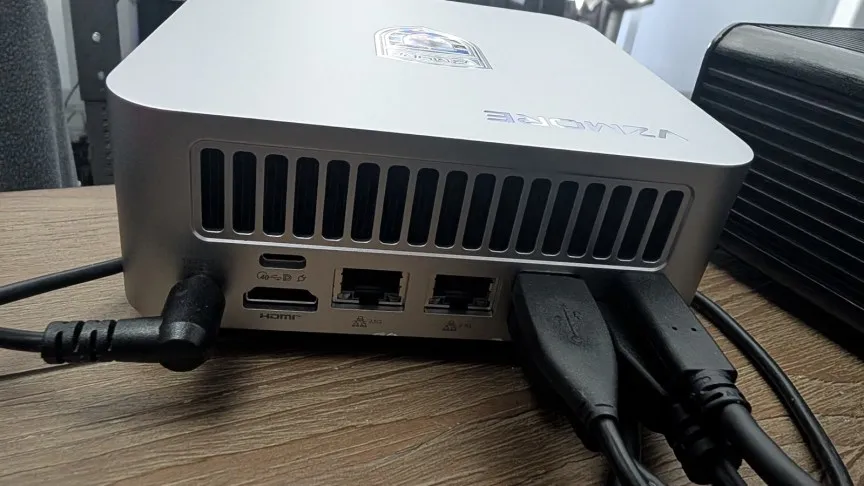
- نمایشگر: پشتیبانی از چهار نمایشگر از طریق دو پورت USB4 با سرعت ۴۰ گیگابیت بر ثانیه و دو پورت HDMI 2.1 (خروجی تا 8K)
- شبکه: دو پورت LAN 2.5G و Wi-Fi 7
- پورتها: ۲ عدد USB4 (۴۰ گیگابیت بر ثانیه) و ۶ عدد USB-A
- سایر: کارتخوان SD 4.0
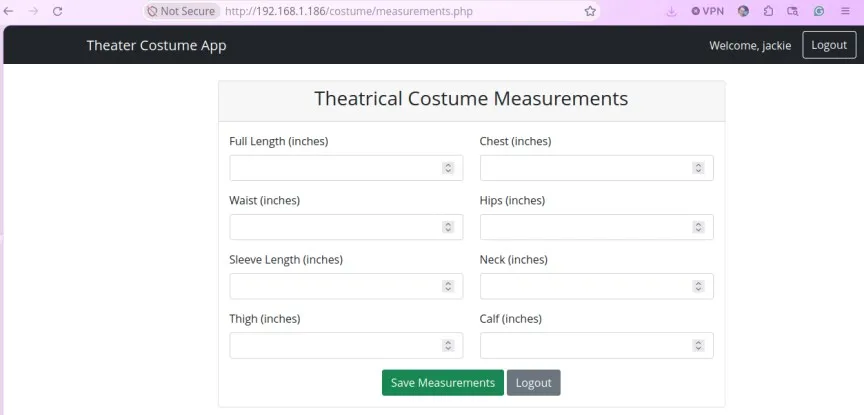
برای تست این سختافزار، جک والِن (Jack Wallen) ویندوز ۱۱ پرو پیشفرض را با توزیع فدورا لینوکس جایگزین کرد که نصب آن تنها دو دقیقه زمان برد. او از Ollama به همراه رابط گرافیکی Moose (که از طریق دستور flatpak install flathub io.github.moooossee.Moose نصب شد) برای اجرای مدل qwen3-coder:30b استفاده کرد. هدف این بود که یک اپلیکیشن وب کامل برای اندازهگیری لباسهای تئاتر، شامل پایگاه داده و سیستم احراز هویت کاربر ساخته شود.
تست عملکرد
والِن از هوش مصنوعی خواست برنامهای بسازد که ورودیهای کاربر برای اندازهها را بپذیرد، این دادهها را در یک دیتابیس ذخیره کند و به کاربران اجازه دهد برای ذخیره اطلاعاتشان وارد سیستم شوند. او انتظار داشت ماشین به کندی عمل کند، اما پاسخ بلافاصله شروع شد. هوش مصنوعی در نهایت حدود ۱۵۰۰ خط کد در چندین فایل از جمله config.php ، login.php ، logout.php ، measurements.php و signup.php تولید کرد.
برای تأیید کدها، والِن آپاچی را روی سیستم لینوکس نصب کرد، فایل حاصل costume.html را به ریشه اسناد آپاچی (/var/www/html) منتقل کرد و از طریق آدرس http://localhost/custom.html به آن دسترسی یافت. اپلیکیشن بسیار خوب عمل کرد و تنها با چند اصلاح کوچک در دستورات دیتابیس به کمال رسید.
طبق گزارش والِن، در حالی که یک دسکتاپ بزرگتر مانند System76 Thelio (با پردازنده Ryzen 9 7900X ۱۲ هستهای، گرافیک RX 7600 Navi 33 و ۳۲ گیگابایت رم) در کارهای مشابه دچار لگ، لرزش تصویر و توقف میشد، VZmore AX Max کاملاً روان باقی ماند. هوش مصنوعی بدون اینکه سیستم حتی پلک بزند، بلافاصله شروع به تولید کد کرد.
این پاسخدهی سریع به دلیل وجود NPU است که تا ۸۶ TOPS (ترا-عملیات یا تریلیون عملیات در ثانیه) قدرت پردازشی ارائه میدهد. این عدد اندازهگیری میکند که یک پردازنده در یک ثانیه چند محاسبه خام AI انجام میدهد و همان «قدرت اضافی» است که اجازه میدهد هوش مصنوعی بدون تخلیه منابع سیستم برای کارهای دیگر، اجرا شود.
ادغام در شبکه (LAN) و کاربرد در آزمایشگاه خانگی
فراتر از استفاده مستقیم، این دستگاه میتواند به عنوان یک سرور هوش مصنوعی اختصاصی برای شبکه محلی (LAN) عمل کند. با پیکربندی Ollama برای دسترسی شبکه، کاربران میتوانند کارهای سنگین AI را از لپتاپهای اصلی یا دسکتاپهای خود به VZmore منتقل کنند (Offload).
والِن دریافت که اگرچه اجرای Ollama روی شبکه به اندازه اجرای مستقیم روی خود ماشین سریع نیست، اما VZmore در اتصال از راه دور، خروجی را بهطور قابلتوجهی سریعتر از سیستم قدرتمندتر System76 Thelio تولید کرد. این ویژگی آن را به گزینهای ایدهآل برای یک ماشین اختصاصی AI در محیطهای «آزمایشگاه خانگی» (Home Lab) تبدیل میکند.
این تغییر نشان میدهد که دستهبندی «کامپیوترهای AI» از دستیارهای ساده چت فراتر رفته است. با ادغام NPUهای با TOPS بالا در ابعاد کوچک، سازندگان سختافزار در حال ایجاد محیطهایی هستند که در آن هوش مصنوعی به جای بلعیدن منابع، یک ابزار پسزمینه است. در حالی که VZmore بر روی دسکتاپ تمرکز دارد، ابزارهایی مانند PocketPal AI امکان اجرای مدلهای زبانی را حتی روی موبایل فراهم کردهاند تا دسترسی محلی به AI به طور کامل دموکراتیزه شود.
برای کاربر نهایی، این یعنی اجرای دادههای حساس بهصورت محلی و کاهش وابستگی به ابر، بدون نیاز به پرداخت قبضهای برق سرورهای صنعتی.
این دستگاه با قیمت ۱,۴۹۹ دلار، گزینهای با ارزش بالا برای توسعهدهندگان و کاربران حساس به حریم خصوصی است و تجربه هوش مصنوعی محلی را از یک اتفاق مختلکننده به یک فرآیند بیسروصدا در پسزمینه تبدیل میکند.
اگر در حال ساخت یک استک هوش مصنوعی محلی هستید، این ماشین از LM Studio، Ollama و AMD GAIA برای اجرای مدلهای سازگار Qwen، Llama، Gemma و DeepSeek پشتیبانی میکند.
گام بعدی شما
- اگر توسعهدهنده هستید، بررسی کنید که آیا مدلهای مورد نیاز شما (مانند Llama 3) با معماری NPUهای AMD سازگار هستند یا خیر.
- برای کاهش بار سیستم اصلی، از مدل «سرور محلی» با نصب Ollama روی یک مینیپیسی و اتصال از طریق LAN استفاده کنید.
- در صورت خرید، برای بهرهوری حداکثری از حافظه RAM دستگاه را به مقدار بیشتری ارتقا دهید تا مدلهای بزرگتر را بدون افت سرعت اجرا کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و آینده استنتاج محلی مراجعه کنید.



گفتگو