یک مدل فشرده ۴ بیتی میتواند کوچکتر، ارزانتر در اجرا و حتی دقیقتر از نسخه اصلی و تمامدقت (Full-precision) باشد که از آن مشتق شده است. این یافته که توسط شرکت Multiverse Computing منتشر شده، معادله سنتی فشردهسازی را تغییر میدهد؛ جایی که پیش از این، کوانتیزاسیون (Quantization) به عنوان یک «مالیات» اجباری و ضروری بر عملکرد مدل دیده میشد که باعث کاهش کیفیت میشد.
به نقل از مستندات این شرکت، استاندارد صنعتی برای استقرار بهینه مدلها طی سالها یک فرآیند دو مرحلهای بوده است: ابتدا فشردهسازی ساختاری (مانند حذف لایهها، سرهای توجه یا نورونها) و سپس کوانتیزاسیون (کاهش دقت وزنها به ۴ بیت). این مسیر اگرچه حافظه و محاسبات را کاهش میدهد، اما بهطور سیستماتیک قابلیتهایی را که برای محیطهای عملیاتی حیاتی هستند — بهویژه استدلال (Reasoning)، حل مسائل ریاضی و تولید کد — تخریب میکند.
برای رفع این مشکل، توسعهدهندگان از مرحلهای به نام «بهبود» یا Healing قبل از استقرار نهایی مدل در محیط تولید استفاده میکنند. همانطور که در تحلیلهای قبلی ما اشاره شد، بسیاری از مدلهای مدرن با وزنهای باز، از جمله خانواده Nemotron انویدیا، gpt-oss و مدل Hypernova 60B متعلق به خود شرکت Multiverse Computing، همگی بر نسخهای از این رویکرد «فشردهسازی و سپس بهبود» متکی هستند.
محدودیتهای روشهای فعلی بهبود
بیشتر خطوط تولید مدلهای بهینه از یک توالی سهمرحلهای سختگیرانه پیروی میکنند: ابتدا معماری فشرده میشود، سپس وزنهای فشردهشده کوانتیزه میشوند و در نهایت آسیبهای وارده بهبود مییابند. تفاوت روشهای مدرن دقیقاً در همین مرحله آخر است.
بسیاری از این روشها بر آموزش آگاه از کوانتیزاسیون (Quantization-Aware Training یا QAT) متکی هستند. در این متد، عملگرهای کوانتیزاسیون مجازی (Fake-quantization) در مسیر پیشرو (Forward pass) قرار میگیرند و مدل روی یک تابع زیان وظیفه (Task loss) تنظیم دقیق میشود. این کار مدل را مجبور میکند تا یاد بگیرد با نمایشهای دقت پایین سازگار شود. در عمل، این روش نیازمند اجرای مجدد یک فرآیند گرانقیمت و چندمرحلهای پسآموزش — شامل تنظیم نظارتشده (SFT)، یادگیری تقویتی با بازخورد انسانی (RLHF) و تنظیمات عاملمحور (Agentic tuning) — از طریق یک مسیر پیشرو نویزیتر و با دقت پایینتر است. این امر نهتنها هزینهبر است، بلکه اگر آموزش بیش از حد نقطه بهینه ادامه یابد، میتواند ناپایدار شود.
جایگزین دیگر، تقطیر آگاه از کوانتیزاسیون (Quantization-Aware Distillation یا QAD) است. در اینجا بهجای تابع زیان وظیفه، یک مدل «معلم» منجمد با دقت کامل به یک مدل «شاگرد» کوانتیده منتقل میشود و از زیان واگرایی KL (KL-divergence loss) روی لاجیتهای خروجی استفاده میگردد. این روش زمانی عالی عمل میکند که تنها تغییر ایجاد شده، کوانتیزاسیون باشد؛ زیرا در این حالت، یک نسخه واقعی با دقت کامل از همان مدل دقیقاً وجود دارد تا نقش معلم را ایفا کند.
اما طبق گزارش Multiverse Computing، وقتی مدل دچار فشردهسازی ساختاری (کاهش لایهها، سرهای توجه یا نورونها) میشود، این فرض میشکند. در این حالت، دیگر هیچ نسخه مستقل آموزشدیده با دقت کامل از آن معماری کوچکتر وجود ندارد. تنها کاندیدای معلم، همان نسخه بازیابیشده bfloat16 است که خود صرفاً یک تقریب تقطیرشده از مدل اصلی است. تقطیر از چنین معلمی، مدل شاگرد کوانتیده را به یک هدف تخریبشده متصل میکند و دقت آن را به سقف عملکرد همان نسخه بازیابیشده محدود میکند.
سازوکار QAH: شکستن سقف عملکرد
روش بهبود آگاه از کوانتیزاسیون (Quantization-Aware Healing یا QAH) با تغییر هویت معلم، این سقف عملکرد را از بین میبرد. در QAH، تقطیر بهجای استفاده از نسخه فشردهشده و بازیابیشده، مستقیماً از مدل اصلی و پیش از فشردهسازی صورت میگیرد.
از آنجا که توزیع خروجی یک معلم به معماری وابسته نیست (Architecture-agnostic)، مدل شاگرد میتواند نیمی از اندازه معلم باشد و با دقت MXFP4 اجرا شود، در حالی که معلم همچنان در اندازه کامل و با دقت بالا باقی میماند. شاگرد از طریق واگرایی KL روی لاجیتها یاد میگیرد؛ به این معنی که هرگز برچسبهای سخت (Hard labels) را نمیبیند، بلکه تنها توزیع احتمالی معلم را جذب میکند.
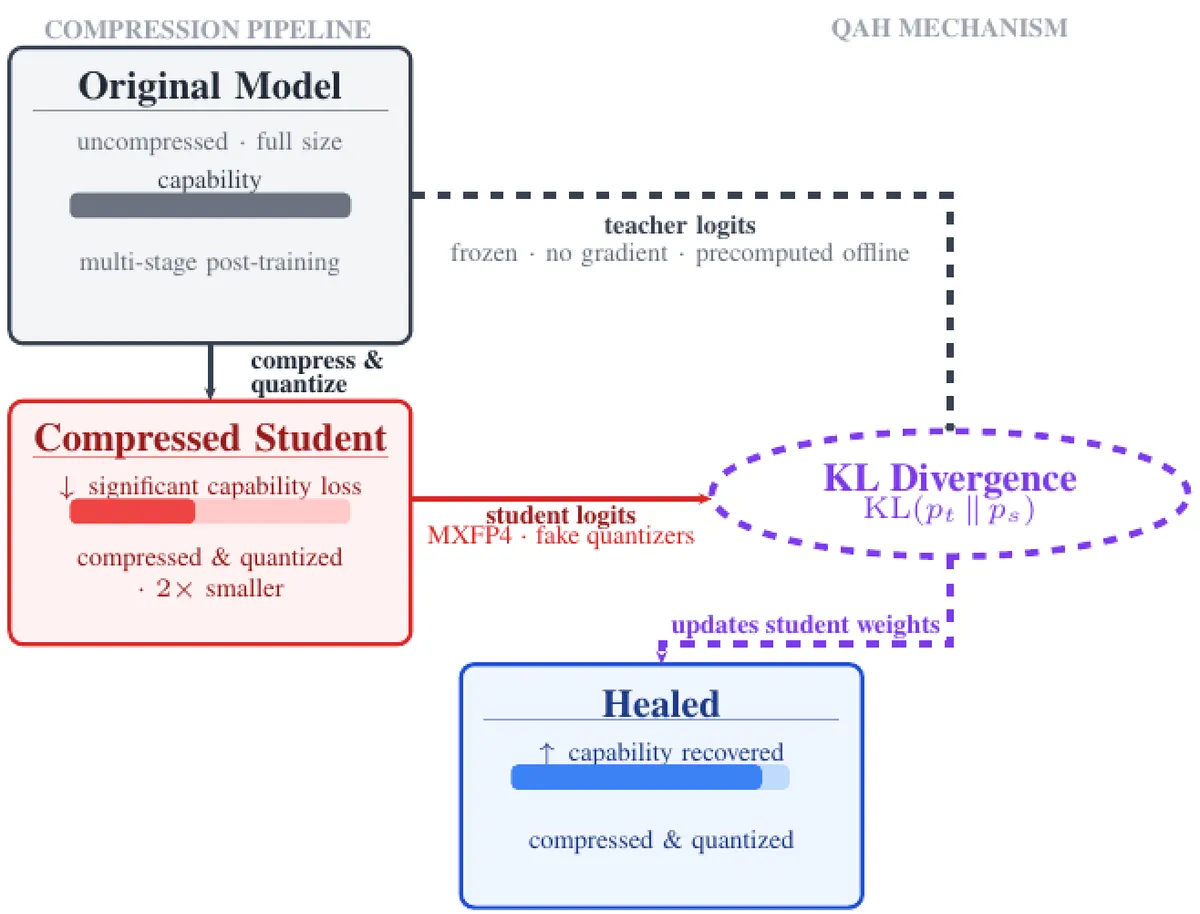
این رویکرد، کوانتیزاسیون را از یک مرحله پسپردازش تخریبی به یک مرحله دوم از تقطیر (Distillation) تبدیل میکند. مدل ۴ بیتی دیگر فقط سعی در جبران خسارت کوانتیزاسیون ندارد، بلکه اطلاعاتی را جذب میکند که در مرحله بازیابی اولیه، فرصت یا دادهای برای انتقال آنها وجود نداشت.
پیادهسازی در زمینههای متنی بلند
برای اینکه QAH در متون بلند، جایی که مجموعه دادههای بهبود شامل اسنادی تا ۳۲ هزار توکن است، بهدرستی کار کند، تیم توسعه یک مکانیزم خاص و بهینه از نظر حافظه پیاده کرد:
- زیان KL تکهبندی شده (Chunked KL-Divergence Loss): این تابع زیان، واگرایی KL را در هر بار، تنها برای یک برش (Slice) از توالی محاسبه میکند.
- بهینهسازی حافظه: این روش از ایجاد فیزیکی شبکههای حجیم «واژگان در مقابل توالی» (Vocabulary-by-sequence grid) جلوگیری میکند.
- بهرهوری سختافزاری: این ساختار اجازه میدهد فرآیند بهبود متون ۳۲ هزار توکنی در یک بودجه حافظه ثابت GPU جای بگیرد.
نتایج بنچمارکها
Multiverse Computing این روش را روی مدل GPT-OSS 120B پیاده کرد، آن را به ۶۰ میلیارد پارامتر کاهش داد و به MXFP4 کوانتیزه کرد. در مقایسه با نسخه ۶۰ میلیاردی bfloat16 (بهترین نسخه موجود از این معماری با دقت کامل)، مدل ۴ بیتی QAH در ۷ مورد از ۹ محک برنده شد.
برخی از دستاوردهای کلیدی عملکردی عبارتاند از:
- استدلال متنی بلند (AA-LCR): افزایش ۷.۴ امتیازی نسبت به نسخه BF16 (۴۲.۷ در برابر ۳۵.۳).
- ریاضیات (AIME 2025): افزایش ۵.۶ امتیازی (۷۶.۳ در برابر ۷۰.۷).
- کدنویسی عاملمحور (Aider): افزایش ۲.۷ امتیازی (۴۰.۹ در برابر ۳۸.۲).
- استفاده از ابزار ($ au^2$-bench): افزایش ۲.۳ امتیازی (۶۱.۷ در برابر ۵۹.۴).
- علوم (GPQA Diamond): افزایش ۱.۷ امتیازی (۶۷.۴ در برابر ۶۵.۷).
- پیروی از دستورات (IFBench): افزایش ۱.۵ امتیازی (۵۹.۹ در برابر ۵۸.۴).
- کدنویسی (LiveCodeBench): افزایش ۱.۰ امتیازی (۶۶.۵ در برابر ۶۵.۵).
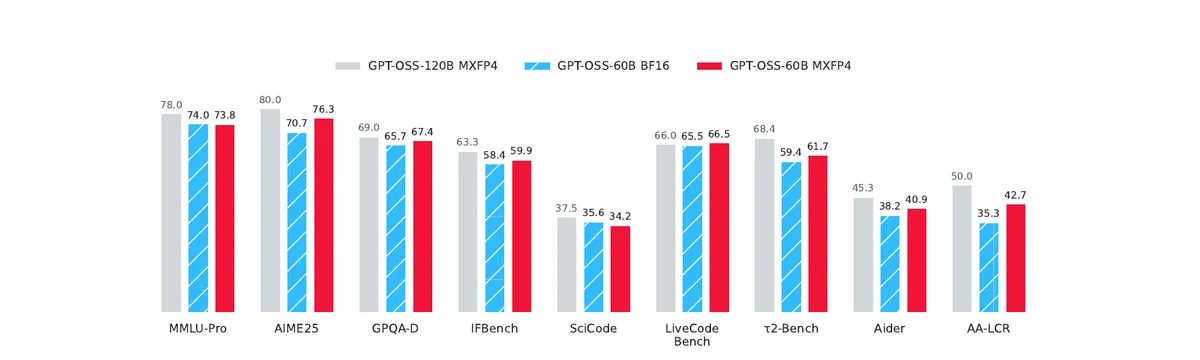
در دو محک MMLU-Pro (۷۳.۸ در برابر ۷۴.۰) و SciCode (۳۴.۲ در برابر ۳۵.۶)، اختلاف کمتر از یک و نیم امتیاز بود. نکته حائز اهمیت این است که بیشترین دستاوردها دقیقاً در قابلیتهایی رخ داد که فشردهسازی معمولاً بیشترین آسیب را به آنها میزند: استدلال متنی بلند و ریاضیات.
بهطور شگفتانگیزی، مدل QAH حتی در LiveCodeBench از مدل معلم ۱۲۰ میلیاردی پیشی گرفت (۶۶.۵ در برابر ۶۶.۰)، در حالی که نیمی از پارامترها و تقریباً یکچهارم حافظه وزنها را مصرف میکرد. همچنین در GPQA Diamond با اختلاف ۱.۶ امتیاز به معلم نزدیک شد (۶۷.۴ در برابر ۶۹.۰). بزرگترین شکاف باقیمانده در AA-LCR است، جایی که ظرفیت از دست رفته بر اثر فشردهسازی، ذاتاً سختترین بخش برای بازیابی است.
پایداری و بهرهوری
علاوه بر دقت، QAH یک ریسک حیاتی در استقرار را حل میکند: ناپایداری آموزش. در یک تست رودررو با استفاده از مدل GPT-OSS 9B کوانتیزه شده به MXFP4، تیم توسعه میانگین عملکرد را در MMLU-Pro، LiveCodeBench و GPQA Diamond ردیابی کرد.
- سرعت همگرایی: QAH در حدود ۱۰۰ گام به اوج خود (۵۴.۹) رسید، در حالی که QAT برای رسیدن به اوج مشابه (۵۴.۶) به ۷۰۰ گام نیاز داشت.
- پایداری: QAH در طول باقیمانده آموزش، در محدوده دو امتیاز فاصله از نقطه اوج خود باقی ماند.
- تخریب: مدل QAT پس از رسیدن به اوج، دچار سقوط شدید شد و تا گام ۱۲۰۰ حدود ۱۹ امتیاز از دست داد.
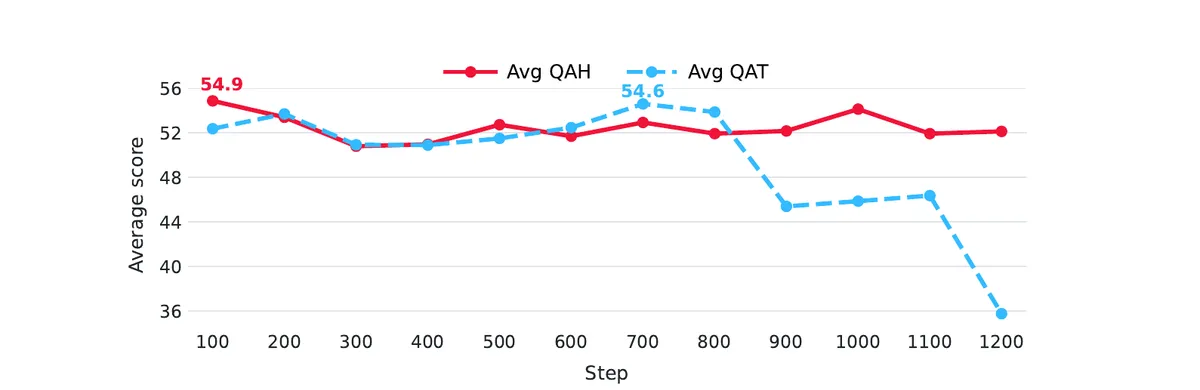
این تفاوت ریشه در تابع زیان دارد. تقطیر KL در برابر یک معلم منجمد، انگیزهای نمیدهد که مدل شاگرد پس از تطبیق با معلم، تغییر کند. در مقابل، هدف آنتروپی متقاطع (Cross-entropy) در QAT، مدل را بهطور مداوم به سمت برچسبهای سخت میراند که در نهایت قابلیتهای ارثبری شده از مدل اصلی را تخریب میکند. در نتیجه، یک چکپوینت QAT نیازمند توقف زودهنگام (Early stopping) دقیق با استفاده از یک سیگنال مجزا است، در حالی که چکپوینت QAH را میتوان با اطمینان سرو کرد زیرا دچار رانش (Drift) نمیشود.
پیامدهای فنی
این تغییر، مفروضات بنیادی فشردهسازی مدل را دگرگون میکند. کوانتیزاسیون دیگر یک سازش یا راهکاری برای کاهش ضرر نیست، بلکه فرصتی برای آموزش بیشتر است.
از نظر بهرهوری، مدل ۴ بیتی QAH حدود ۴ برابر حافظه کمتری نسبت به شاگرد bfloat16 مصرف میکند. همچنین به دلیل نصف شدن تعداد پارامترها نسبت به معلم ۱۲۰ میلیاردی، محاسبات هر توکن تقریباً نصف میشود. برای خانواده مدلهایی که بهجای ۴ بیت با bfloat16 عرضه میشوند، ترکیب کاهش پارامتر و کاهش دقت منجر به کاهش تقریباً ۸ برابری محاسبات هر توکن میگردد.
با جداسازی معماری معلم از شاگرد، Multiverse Computing ثابت کرد که «سقف» یک مدل فشرده را اندازه آن تعیین نمیکند، بلکه کیفیت معلم اصلی که از آن تقطیر شده، تعیینکننده است. توسعهدهندگان اکنون باید ارزیابی کنند که آیا خطوط تولید بهبود (Healing) فعلی آنها، مدلها را به اهدافی تخریبشده متصل کرده است یا خیر. حرکت به سمت تقطیر مستقل از معماری میتواند اجازه استقرار مدلهای فوقکوچک اما بسیار توانمند را روی سختافزارهایی بدهد که پیش از این برای کارهای استدلالی پیچیده ناکارآمد تصور میشدند.
گام بعدی شما
- اگر از مدلهای کوانتیده برای کاربردهای ریاضی یا کدنویسی استفاده میکنید، بررسی کنید آیا فرآیند بهبود (Healing) شما بر اساس یک مدل تخریبشده است یا مدل اصلی.
- در استقرار مدلهای لبه (Edge)، متد QAH را برای کاهش ۸ برابری هزینه محاسبات بدون افت دقت بررسی کنید.
- برای کاهش ریسک Overfitting در مدلهای فشرده، از توابع زیان مبتنی بر تقطیر KL بهجای آنتروپی متقاطع استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو