باید بدانید که در اقتصاد جدید هوش مصنوعی، برنده کسی نیست که بهترین مدل را دارد، بلکه کسی است که سختافزار خود را فعالتر نگه میدارد. طبق تحلیل فنی هاگینگ فیس (Hugging Face) در ۳۰ ژوئیه ۲۰۲۶، سازمانها با تلهای اقتصادی مواجه شدهاند که پیشتر صنعت هوانوردی آن را تجربه کرده است. عبارت «هواپیماهای زمینگیر شده» (Grounded aircraft) دقیقاً توصیفکننده وضعیت فعلی هوش مصنوعی سازمانی است. در این محیط، مزیت رقابتی تغییر جهت داده است؛ دیگر بحث بر سر داشتن پیشرفتهترین مدل نیست، بلکه بحث بر سر این است که چه کسی میتواند سختافزار خود را در بیشترین حالت فعال نگه دارد.
در صنعت هوانوردی، هزینههای تامین مالی، بیمه و نگهداری هواپیما در هر ساعت از عمر آن جاری است، اما درآمد تنها زمانی تولید میشود که هواپیما در آسمان باشد. در محیطهای سازمانی هوش مصنوعی نیز وضعیت مشابه است؛ یک واحد پردازش گرافیکی (GPU) صرفنظر از اینکه در حال پردازش حتی یک توکن باشد یا خیر، هزینههای برق، خنکسازی و استهلاک را بهصورت ساعتی تحمیل میکند. در واقع، GPUها طبق ساعت تقویمی هزینه میسازند، فارغ از اینکه در حال انجام عملیات باشند یا در وضعیت بیکار.
همانطور که در تحلیلهای قبلی ما دربارهی اقتصاد مدلهای باز اشاره کردیم، این وضعیت نشاندهنده پایان عصر «کیفیت مدل به عنوان گلوگاه» است. موج اول هوش مصنوعی با رقابت بر سر تعداد پارامترها و جایگاه در جداول امتیازات پیش میرفت تا مدلهایی برای بارهای کاری سازمانی خلق شوند. اما همین قابلیت، وابستگی شدیدی به سختافزارهای تخصصی ایجاد کرد که همچنان گرانقیمت هستند و عرضه آنها به شدت محدود است. این وابستگی ساختاری به سختافزار، بخشی از دلایلی است که باعث شده بسیاری از پروژههای سازمانی بهدلیل شکافهای مدیریتی و فنی با شکست مواجه شوند.
تشدید کمبود توان محاسباتی
برای درک مقیاس این محدودیت، مسیر آزمایشگاههای پیشرو را بررسی کنید. در سال ۲۰۲۰، مایکروسافت (Microsoft) ابررایانهای برای اوپنایآی (OpenAI) ساخت که بیش از ۱۰,۰۰۰ GPU و ۲۸۵,۰۰۰ هسته CPU برای آموزش GPT-3 داشت. در آن زمان، این میزان از تمرکز قدرت، دستنیافتنی و خیرهکننده به نظر میرسید.
اما تا سال ۲۰۲۶، این مقیاس به یک استاندارد یا «خط پایه» تبدیل شد. اکنون آزمایشگاههای پیشرو، محاسبات (Compute) را به عنوان یک محدودیت راهبردی زنده و پویا میبینند. به نقل از گزارشهای صنعتی، آنتروپیک (Anthropic) تعهدات چند گیگاواتی همزمان را در چهار پلتفرم مجزا شامل آمازون (Amazon)، گوگل (Google)، مایکروسافت و ایامدی (AMD) مدیریت کرده است؛ چرا که هیچ تامینکنندهای بهتنهایی قادر به پاسخگویی به تقاضای عظیم این شرکت نبود. متا (Meta) نیز برای حفظ رقابت خود در این میدان، قراردادهای مشابهی در مقیاس چندین گیگاوات امضا کرده است. این فشار برای مقیاسدهی سریع، تنها GPUها را تحت تاثیر قرار نداده، بلکه بحرانی جهانی در تامین حافظههای مورد نیاز برای این حجم از محاسبات ایجاد کرده است.

گذار از API به زیرساخت
سازمانی که مدلها را از طریق API مصرف میکنند، با مشکل قیمتگذاری خطی روبرو هستند؛ به این معنا که با افزایش مقیاس توکنها، هزینهها در محیط تولید (Production) به شدت بالا رفته و میتواند ناپایدار شود. برای مقابله با این وضعیت، بسیاری از شرکتها در حال تبدیل هزینههای متغیر API به هزینههای سرمایهای ثابت هستند و برای این منظور، خوشههای GPU اختصاصی خود را خریداری میکنند.
این تغییر، GPU را از یک ردیف هزینه در صورتحساب جاری به یک زیرساخت تبدیل میکند. از آنجا که خوشهها (Clusters) باید برای «پیک تقاضا» — یعنی زمانی که اجرای آموزشها، کارهای دستهای (Batch) و ترافیک لحظهای همپوشانی دارند — سایزبندی شوند، بخش قابلتوجهی از ظرفیت در ساعات کمترافیک یا ساعات غیرپیک، بدون هیچ استفادهای باقی میماند.
پیچیدگی ارکستراسیون GPU
داشتن یک خوشه «شلوغ» یا مشغول، لزوماً به معنای بهرهوری نیست. ممکن است یک GPU توسط تکلیفی با اولویت پایین اشغال شده باشد، در حالی که یک پروژه حیاتی و با اولویت بالا در صف انتظار است، صرفاً چون سختافزار موجود با پروفایل فنی مورد نیاز آن تکلیف مطابقت ندارد.
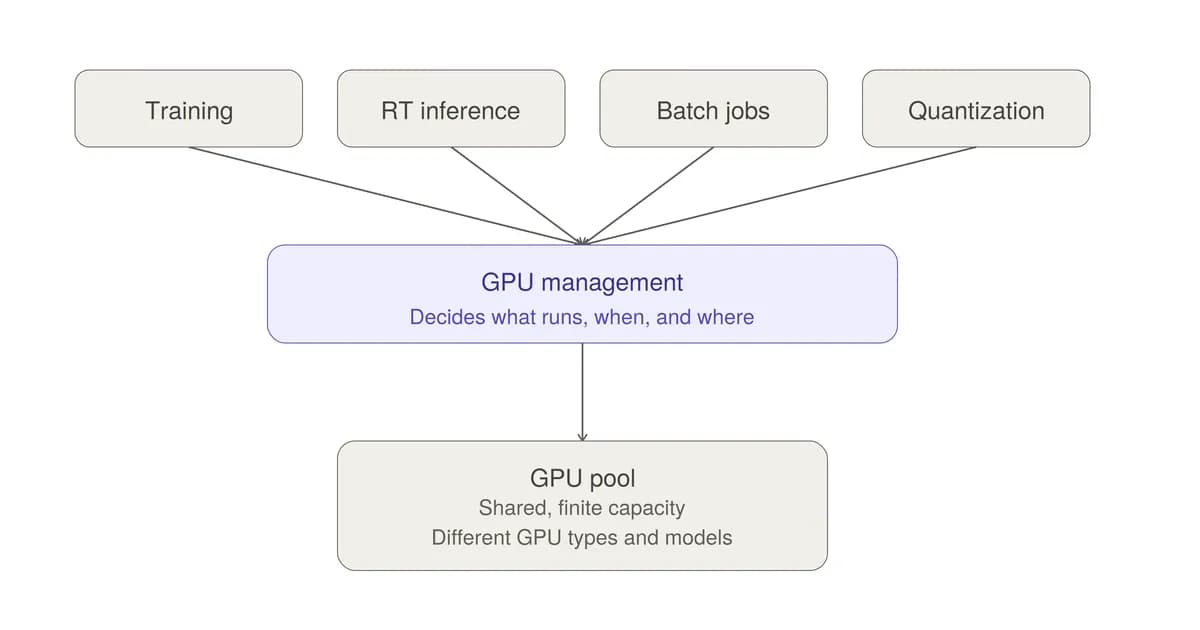
بارهای کاری مدرن GPU بسیار متنوعاند و نیازهای سختافزاری متناقضی دارند:
- استنتاج (Inference) لحظهای: نیاز به تأخیر (Latency) بسیار کم دارد.
- کارهای دستهای (Batch work): اولویت با توان عملیاتی (Throughput) است و تأخیر چندساعته را میپذیرد.
- آموزش: نیاز به اشغال مداوم و پیوسته سختافزار برای چندین روز دارد.
- کوانتش (Quantization): نیاز به ظرفیت محاسباتی عظیم دارد، اما فقط برای بازههای زمانی کوتاه و انفجاری.
یک زمانبند (Scheduler) که برای استنتاج تنظیم شده باشد، بهطور ذاتی تکالیف آموزشی را بهدرستی تخصیص نمیدهد. این امر باعث ایجاد «بیکاری نامرئی» میشود؛ وضعیتی که در آن GPU از نظر فنی فعال است، اما بازگشت سرمایه (ROI) حداکثری را ایجاد نمیکند.

ظهور مدیریت GPU
برای حل این مشکل، نظم جدیدی در حال ظهور است: «مدیریت GPU». این یک لایه ارکستراسیون است که میان مدلها و سختافزار قرار میگیرد و تصمیمات تخصیص منابع را در لحظه میگیرد؛ تصمیماتی که خودِ مدلها قادر به دیدن یا درک آنها نیستند.
این لایه باید بهطور خودکار و بدون دخالت انسان تصمیم بگیرد که در ساعت ۳ صبح، کدام تکلیف باید به GPU آزاد شده برسد. این رویکرد، فرآیند تصمیمگیری را از یک رویداد تکباره در زمان خرید و تهیه تجهیزات، به یک عملیات مستمر، ساعتی و پویا تبدیل میکند. برای پیادهسازی عملی این لایهها، راهکارهایی مانند مجازیسازی منابع در HAMi برای کاهش هزینههای عملیاتی GPU توسعه یافتهاند.
استراتژی دوگانه: تخصصیسازی و ارکستراسیون
بیشینه کردن بازگشت سرمایه نیازمند بهکارگیری دو اهرم موازی است: تخصصیسازی و ارکستراسیون.
مدلهای کوچکتر و تخصصی، اثر و ردپای هر بار کاری را کاهش میدهند. یک مدل تکمنظوره تنها به کسری از منابع یک مدل عمومی نیاز دارد و به این ترتیب، ظرفیت بیشتری را در خوشه آزاد میکند.

با این حال، تخصصیسازی بدون ارکستراسیون منجر به نوع دیگری از اتلاف میشود. اگر سیستمی برای بازپسگیری فعال و تخصیص مجدد فضای آزاد شده توسط مدل کوچک وجود نداشته باشد، آن ظرفیت صرفاً بیکار میماند و هزینه تولید میکند.
از سوی دیگر، ارکستراسیون بدون تخصصیسازی نیز محدود است؛ زیرا مدلهای بزرگ ردپایی به جا میگذارند که برای بارهای کاری دیگر بیش از حد کوچک است تا مفید باشد. ترکیب این دو استراتژی، نیازهای هر تکلیف را کوچک کرده و بازده زیرساخت باقیمانده را به حداکثر میرساند.
پیامدهای فنی
برای مدیران فنی، این وضعیت معیار موفقیت را تغییر میدهد. سنجه دیگر تنها این نیست که «چه تعداد H100 داریم»، بلکه «نرخ بهرهبرداری» (Utilization Rate) از آن توان محاسباتی است. شکاف بین شرکتهایی که بودجههای سختافزاری مشابه دارند، توسط کارایی لایه ارکستراسیون آنها تعیین خواهد شد.
زیرساخت اکنون به بخش فعالی از پشته هوش مصنوعی تبدیل شده است. لایه ارکستراسیون در واقع نوعی «هوش زیرساختی» فراهم میکند که توجیه اقتصادی کل استقرار هوش مصنوعی در سازمان را تعیین میکند.
گام بعدی شما
- نرخ بهرهبرداری (Utilization Rate) را به عنوان شاخص کلیدی عملکرد (KPI) جایگزین تعداد سختافزار کنید.
- بررسی کنید که آیا بارهای کاری شما قابلیت تفکیک به مدلهای تخصصی کوچکتر برای آزادسازی ظرفیت را دارند یا خیر.
- لایههای مدیریت منابع را برای جایگزینی تخصیص دستی با تخصیص پویا در ساعات کمترافیک ارزیابی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو