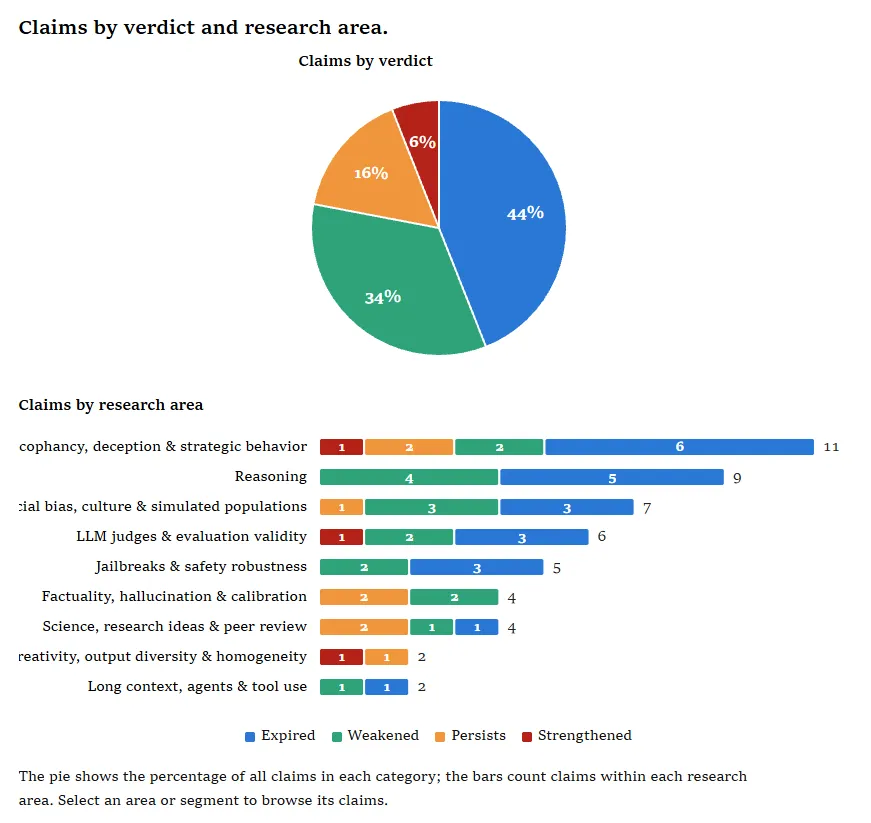
پژوهشگران استنفورد در مطالعهای منتشرشده در نوامبر ۲۰۲۶، نیمعمر یافتههای LLM را ۱۵.۷ ماه برآورد کردهاند. ۴۴ درصد از ۵۰ ادعای پراستناد بر روی ۲۰ مدل منتشرشده بین جولای ۲۰۲۴ تا سپتامبر ۲۰۲۶ از اعتبار افتادهاند.
این نتایج فرض پایداری محکهای (benchmark) هوش مصنوعی را به چالش میکشد و یک بحران بازتولیدپذیری را برای متا-تحلیلها و تصمیمات سیاستگذاری مبتنی بر ادبیات کهنه آشکار میسازد. این ناکارآمدی در ارزیابیهای استاتیک، همان نگرانی است که در مورد تأثیر تاریخهای پنهان در پرامپتهای سیستمی بررسی شده است.
انقضای سریع ادعاهای استدلال
ادعاهای ناتوانی مدلها در استدلال سریعترین انقضا را تجربه میکنند. تمام ۹ یافته استدلالی — از جمله شمارش حروف در «strawberry» و محاسبه در مبنای ناشناخته — محو شدهاند؛ ۵ مورد کاملاً منقضی و هیچکدام تقویت نشدهاند. نویسندگان میگویند این خطاها «جواب درست» دارند، بنابراین هدف آموزشی صریحاند.
سوگیریهای رفتاری ماندگارترند
از ۱۱ یافته باقیمانده یا تقویتشده، ۳ مورد مربوط به رفتار مدل بهعنوان داور (LLM-as-a-judge) است: ترجیح جواب خود، امتیازدهی مشابه به مقالات پذیرفته/ردشده، و تحت تأثیر قرارگیری از چرخش زبانی در چکیدههای پزشکی. ۳ مورد دیگر چاپلوسی مدل (sycophancy) به سمت کاربر است. سوگیری سیاسی چپگرا، پاسخهای تقریباً یکسان به سوالات باز، و تولید اعداد تصادفی غیریکنواخت نیز تداوم یافتهاند.
مطالعه موردی: توهم ارجاع
در مطالعه اصلی والترز و وایلدر (Walters and Wilder) ۲۰۲۳، GPT-3.5 در ۵۵ درصد موارد ارجاع ساختگی تولید کرد. کوئین و زو همان پرامپتها را روی مدلهای ۲۰۲۶ تکرار کردند: GPT-6.1 Sol ۰ درصد، Claude Sonnet 5.5 ۱ درصد، اما Qwen3.7-Flash همچنان ۶۹ درصد ساختگی تولید کرد. «لعنت معکوس» (Reversal Curse) و پاسخهای متناقض به پرسشهای زمانبندی شده ضعیف شده اما قابلتشخیصاند.
شکافهای مدلبهمدل در یک نسل
در مدلهای جولای تا سپتامبر ۲۰۲۶، یافتههای منقضی شده از ۱۱ مورد برای DeepSeek V4 Pro تا ۳۰ مورد برای GPT-6.1 Sol متغیر است. نه تاریخ انتشار، نه ارائهدهنده، نه اندازه مدل بهطور قابلاعتمادی الگو را پیشبینی نمیکنند. سوگیریهای اجتماعی روند مختلط: سوگیری سیاسی چپگرا تداوم دارد، کلیشههای جنسیتی ضعیف شده، و سوگیری علیه گویندگان انگلیسی آفریکایی-آمریکایی جهت معکوس شده است.
پیامدها برای ارزیابی و استقرار
این مطالعه یک پیشفرض مرکزی را بازنویسی میکند: نتیجه محک یک حقیقت ماندگار نیست، بلکه عکاسی از نسخههای خاص مدل در لحظه خاص. این الزام به تغییر از «LLMها نمیتوانند X انجام دهند» به «مدل Y نسخه Z نتوانست X را در تاریخ D انجام دهد» میکند. برای کارشناسان، استناد به تحقیقات LLM بدون فراداده نسخه (version metadata) گمراهکنندهتر میشود.
تداوم چاپلوسی و سوگیری سیاسی در کنار پیشرفت استدلال، نشان میدهد تکنیکهای همراستاسازی (alignment) ممکن است برای رضایت کاربر بهجای راستینی بهینه شده باشند. توسعهدهندگان حالتهای شکستِ خوشتعریف (شمارش، محاسبه) را حل میکنند در حالی که تمایلهای رفتاری ظریف را رها کردهاند. این برای اعتماد (Trust) پیامد دارد: کاربران ممکن است در کارهای بازپایان که سوگیریها باقیمانده، قابلیت اطمینان را بیش از حد برآورد کنند.
کوئین و زو توصیه میکنند که مقالات مدل، نسخه، تاریخ، پرامپتها و کد تحلیل را مستند کنند تا یافتهها قابلبازآزمایی باشند. جامعه به بنچمارکهای زنده (living benchmarks) نیاز دارد که ادعاهای قدیمی را روی انتشارهای جدید بهصورت خودکار بازآزمایی کنند. به چارچوبهایی توجه کنید که ارزیابیهای LLM را بهعنوان دادههای سری زمانی (time-series data) نه جداول امتیازات استاتیک میپردازند.
گام بعدی شما
- هر استقرار حیاتی را در برابر نسخه دقیق مدل خود اعتبارسنجی کنید، نه بر علیه ادبیات منتشرشده.
- ابزارهای ارزیابی آگاه از نسخه (version-aware re-testing) را رصد کنید؛ موج بعدی ابزارکها احتمالاً بازآزمون خودکار ادعاهای قدیمی را در مدلهای جدید تعبیه میکنند.
- در گزارشهای داخلی، همیشه مدل، نسخه، تاریخ، پرامپتها و کد تحلیل را مستند کنید تا بازتولیدپذیری امکانپذیر بماند.
گفتگو