تصور کنید یک مدل هوش مصنوعی امروز در حل یک مسئله ریاضی موفق شود، اما فردا با همان ورودی دقیقاً شکست بخورد. این نوسان عملکردی، نتیجهی یک متغیر پنهان و پیشفرض است که اعتبار ارزیابیهای فعلی را به شدت تهدید میکند. طبق تحلیل فنی منتشر شده در ۹ اکتبر ۲۰۲۶ با عنوان «تاریخگذاری مدل: تاریخهای پنهان در پرامپتهای سیستمی بر ارزیابی LLM اثر میگذارند»، تزریق خودکار تاریخ جاری به پرامپت سیستمی (System Prompt) منبعی از ناتعینپذیری ایجاد میکند که میتواند رتبهبندی لیدربوردهای جهانی را بدون هیچ تغییر واقعی در قابلیتهای مدل جابهجا کند.
ارزیابی مدلهای زبانی بزرگ (LLM) همواره دشوار بوده است، زیرا این مدلها ذاتاً ناتعینپذیر هستند. حتی با پرامپت و تنظیمات یکسان، تفاوتهای محیطی کوچک — مانند پیکربندی سختافزار، دقت محاسباتی عددی یا حتی ترتیب قرارگیری گزینهها در سوالات چندگزینهای — میتواند نتایج را تغییر دهد. این موضوع باعث میشود که برای کسبوکارها و مصرفکنندگان دشوار باشد که تشخیص دهند آیا یک بهروزرسانی در مدل، نشاندهنده پیشرفتی واقعی است یا صرفاً یک تغییر تصادفی.
در حالی که پژوهشگران سالها سعی کردهاند این متغیرها را کنترل کنند، همکاری جدیدی بین مؤسسات آلمان، مکزیک و آمریکا متهمی حیاتی و نادیده گرفته شده را شناسایی کرده است: تاریخ سیستم. اکثر مدلهای پیشرو و مدلهای وزنهای باز (Open Weights) بهطور خودکار تاریخ امروز را در پرامپت سیستمی قرار میدهند؛ دستورالعملهایی که رفتار مدل را شرطی میکند اما برای کاربر غیرقابل دسترس باقی میماند.
بستر ناتعینپذیری
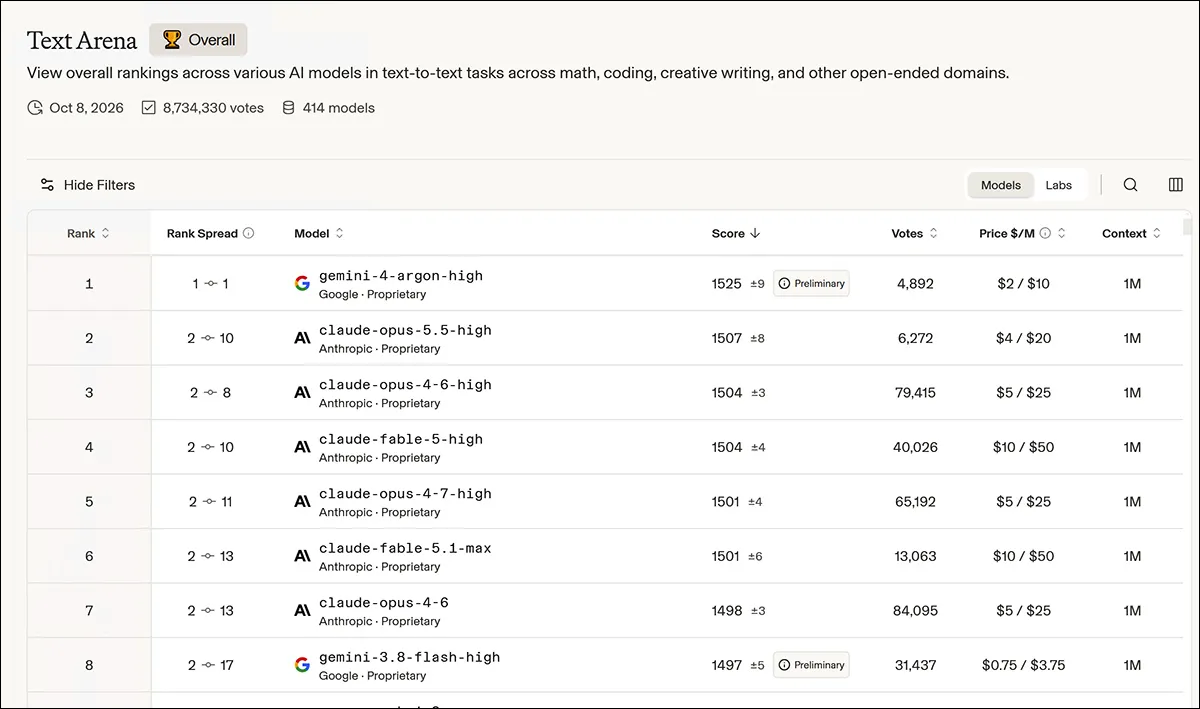
به نقل از این پژوهش، محکزنی (Benchmarking) به این دلیل حیاتی است که مبالغ هنگفتی سرمایه و اعتبار برندها به دقت ارزیابیهای سیستمهای هوش مصنوعی وابسته است. بدون محکهای قابل اعتماد، درک جایگاه یک مدل در برابر رقبا یا میزان پیشرفت آن در نسخههای اخیر غیرممکن است. به همین دلیل است که لیدربوردهای تأثیرگذاری، مانند لیدربورد arena.ai، برای کل صنعت تعیینکننده هستند. در همین راستا، تلاشهایی برای توسعه متدولوژیهای جدید جهت سنجش واقعی کیفیت مدلها در جریان است تا اثر شانس و نوسانات تصادفی در بنچمارکها به حداقل برسد.
با این حال، محققان دریافتند که تزریق پنهان تاریخ جاری، یک متغیر مخرب است. در بررسی ۹ مدل، ۶ مجموعه داده و ۴ وظیفه مختلف، این متادیتای پویا تأثیری بیشتر از سایر عوامل سطح سیستم، از جمله اندازه دسته (Batch Size) در استنتاج یا دقت (Precision) عددی داشت.
اثرات ملموس بر عملکرد
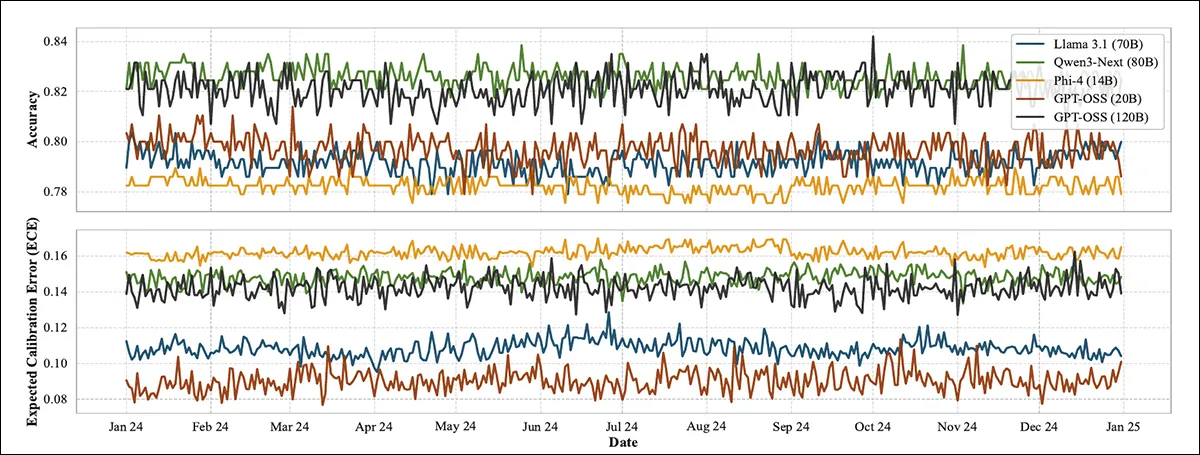
پژوهشگران آزمونی جامع را اجرا کردند که در آن تمام روزهای سال ۲۰۲۴، از ۱ ژانویه تا ۳۱ دسامبر، شبیهسازی شد. آنها برای هر مدل از پرامپتهای یکسان استفاده کردند و تنها تاریخ موجود در پرامپت سیستمی را تغییر دادند. در این آزمایش، ۹ مدل خاص مورد بررسی قرار گرفتند:
- Llama 3.1 Instruct (نسخههای 8B و 70B)
- Gemma 3 Instruct (نسخههای 4B و 27B)
- Qwen3 (4B) و Qwen3-Next (80B)
- Phi-4 (14B)
- GPT-OSS (نسخههای 20B و 120B)
نتایج نشان داد که تغییر ساده تاریخ در پرامپت سیستمی، صحت پاسخها را در وظایف مختلف تغییر میدهد:
- استدلال ریاضی: نوسان عملکرد تا ۱۴٪ (آزمون شده از طریق GSM8K برای ریاضیات گامبهگام).
- تولید کد: نوسان صحت تا ۷٪ (آزمون شده از طریق HumanEval برای کدهای پایتون با معیار pass@1).
- سوالات چندگزینهای: تغییر امتیازات تا ۶٪ (آزمونهای MMLU، GPQA و ARC-Challenge).
- ترجمه ماشینی: واریانس قابلتوجه در ترجمههای انگلیسی به آلمانی، انگلیسی به فنلاندی و انگلیسی به چکی (سنجیده شده با معیارهای BLEU و chrF).
پارادوکس استدلال
یکی از ضدشهودیترین یافتهها این است که تکنیکهای رایج مهندسی پرامپت (Prompt Engineering) اغلب این مشکل را تشدید میکنند. اگرچه ارائه پنج نمونه پاسخ از طریق یادگیری با نمونه اندک (Few-shot Learning) واریانس را اندکی کاهش داد — و میانگین نوسانات را از ۲.۵۲٪ به ۲.۲۷٪ رساند — اما نتوانست مشکل را بهطور کلی حل کند.
نگرانکنندهتر آنکه، تشویق مدل به استدلال گامبهگام، حساسیت مدل به تاریخ را افزایش داد. در تستهای Llama 3.1 (8B) روی محک MMLU، استفاده از زنجیره تفکر (Chain-of-Thought) — که در دادههای مطالعه با رنگ قرمز مشخص شده — نوسانات بهمراتب بیشتری نسبت به پاسخهای مستقیم (که با رنگ آبی مشخص شده) ایجاد کرد.
آسیبپذیری مدلهای تجاری
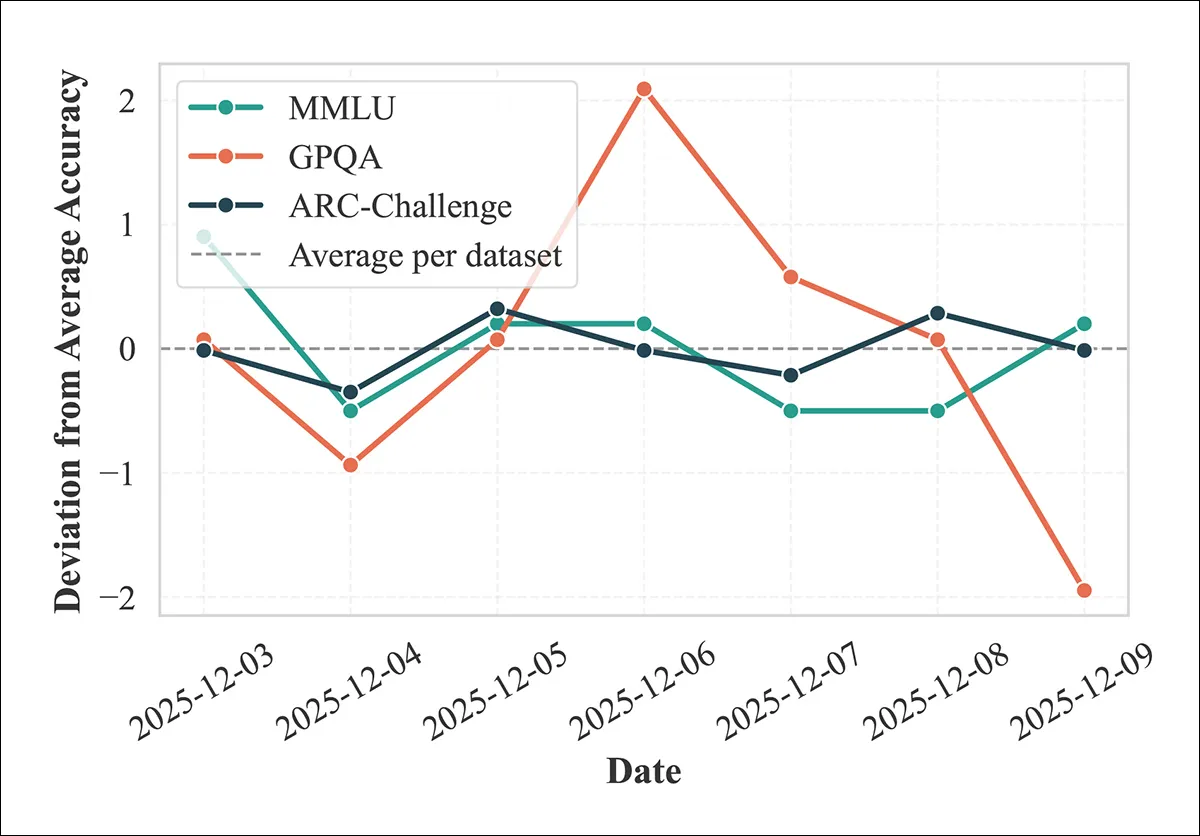
این اثر به سیستمهای بسته و تجاری نیز سرایت میکند. تستهای انجام شده روی GPT-5.1 در دسامبر ۲۰۲۵ نشان داد که صحت پاسخها در سه محک چندگزینهای طی یک هفته تا ۴٪ نوسان داشته است؛ بیشترین تغییر در محک GPQA مشاهده شد.
حتی زمانی که پژوهشگران پرامپت سیستمی را کاملاً خالی کردند، قابلیت استدلال را غیرفعال نمودند و مقدار تصادفی (بذر یا Seed) را روی صفر تنظیم کردند، ارائهدهنده مدل همچنان تاریخ را بهطور خودکار تزریق کرد و باعث تغییر عملکرد شد. این امر ثابت میکند که تاریخ فارغ از تنظیمات کاربر، توسط ارائهدهنده سرویس اعمال میشود.
ریشهها و راهکارهای کاهش خطا
این مطالعه پیشنهاد میکند که این حساسیت احتمالاً بهطور عمیقی در فرآیند آموزش مدل ریشه دارد. اگر پرامپتهای سیستمی در طول تنظیم نظارتشده (SFT) و یادگیری تقویتی با بازخورد انسانی (RLHF) ثابت باشند، مدلها نسبت به هر تغییر کوچک، حتی تغییر تاریخ، شکننده (Brittle) میشوند.
برای بررسی این موضوع، محققان ۶ عبارت مختلف برای پرامپت سیستمی را آزمایش کردند و دریافتند که این تغییرات در عبارتبندی، صحت را ۰.۷۸٪ تغییر میدهد؛ عددی که تقریباً دقیقاً برابر با اثر تغییر تاریخ است. این یعنی بهروزرسانی خودکار تاریخ، تأثیری معادل مهندسی آگاهانه پرامپت دارد، اما بدون اطلاع کاربر رخ میدهد.
پیامدهای فنی
این یافته این فرض را به چالش میکشد که ارزیابیهای LLM در صورت ثابت نگه داشتن پرامپت و بذر، بازتولیدپذیر هستند. این بدان معناست که جایگاه یک مدل در لیدربوردی مانند arena.ai میتواند تئوریکاً بر اساس روزی که تست اجرا شده تغییر کند، بدون اینکه پیشرفت یا پسرفت واقعی در قابلیتهای مدل رخ داده باشد. برای مدلهای کوچکتر، ابزارهایی مانند MicroLLM Lab محیطی مرورگر-محور برای چنین محکزنیهایی فراهم کردهاند تا دسترسی به ارزیابیهای سریعتر تسهیل شود.
برای حل این مشکل، پژوهشگران توصیه میکنند ارائهدهندگان یا تاریخ را کاملاً از پرامپتهای سیستمی حذف کنند یا آن را روی یک مقدار ثابت و مستند شده تثبیت کنند. جایگزین دیگر، استفاده از یک فراخوانی کوچک تولید بازیابیافزا (RAG) — یک روتین زیر یک کیلوبایت — برای دریافت تاریخ جاری به عنوان یک وظیفه اداری (Housekeeping) پیش از شروع تعامل است، به جای گنجاندن آن در دستورالعمل اصلی سیستم.
این موضوع شکاف بنیادی بین محاسبات قطعی (Deterministic) پیش از سال ۲۰۲۳ و ماهیت احتمالی سیستمهای مدرن مبتنی بر انتشار را برجسته میکند. در حالی که مسئله تاریخ در علوم کامپیوتر اساساً در ۱ ژانویه ۱۹۷۰ حل شده بود، اکنون به عنوان یک «شبح در ماشین» به عصر مدلهای زبانی بازگشته است.
توسعهدهندگان و پژوهشگران باید اکنون خط لولههای ارزیابی خود را ممیزی کنند تا متوجه شوند آیا «رانش تاریخی» (Date-drift) در حال پوشاندن پسرفتهای واقعی مدل یا متورم کردن دستاوردهای خیالی است. پرسش حیاتی بعدی این است که آیا این حساسیت زمانی بر قابلیت اطمینان عاملهای (Agents) هوش مصنوعی در انجام وظایف خودمختار بلندمدت اثر میگذارد یا خیر. در این زمینه، متدهای جدیدی مانند روش GDPO برای کاهش نرخ تخلف عاملها معرفی شدهاند تا کنترل بیشتری بر رفتار این سیستمها ایجاد شود.
گام بعدی شما
- اگر از بنچمارکهای داخلی برای مقایسه مدلها استفاده میکنید، تستها را در روزهای مختلف تکرار کنید تا اثر نوسان تاریخ را بسنجید.
- در پرامپتهای سیستمی خود، صراحتاً تاریخ را تثبیت کنید یا از مدل بخواهید تاریخ را نادیده بگیرد تا نتایج بازتولیدپذیر شوند.
- در گزارشهای ارزیابی، تاریخ اجرای تست را به عنوان یک متغیر محیطی ثبت کنید.
اما تأثیر این ناتعینپذیری بر حافظه بلندمدت عاملهای هوشمند حتی پیچیدهتر است — به تحلیل ما درباره پروتکل MCP مراجعه کنید.



گفتگو