تصور کنید یک وکیل یا روزنامهنگار برای اثبات ادعای خود به نقلقولی دقیق نیاز دارد، اما هوش مصنوعی بهطور نامحسوس غلط املایی متن را اصلاح میکند و سند را بیاعتبار میسازد. این «غریزه صیقل دادن» (RLHF polish instinct) که سالها در مدلهای زبانی بزرگ دیده میشد و تمایلی بود که مدلها هنگام نقلقول، غلطهای املایی و دستوری را بیصدا اصلاح کنند، طبق یافتههای جدید در سال ۲۰۲۶ تقریباً از بین رفته است.
به نقل از پژوهشی فنی که توسط سحر شتیبروالا (Sahar Shtibrewala) برای چالش بنچمارکینگ کگل (Kaggle) در ۱۱ اکتبر ۲۰۲۶ منتشر شد، در ۹۶۲ مورد نقلقول، حتی یک مورد اصلاح خودکار توسط مدلها رخ نداد. این مطالعه ثابت میکند که در مدلهای عصر ۲۰۲۶، تمایل به «تمیز کردن» متن هنگام نقلقول بهطور گسترده ناپدید شده است. این یافتهها در تداوم بررسیهای پیشین است، بهویژه در مواردی که مدلهای کدنویسی نیز در برابر وسوسهی اصلاحات ناخواسته محک شدند تا میزان دقت آنها در بازتولید عین متن سنجیده شود.
برای سالها، یک باور رایج در صنعت وجود داشت که مدلهای زبانی بزرگ (LLMs) وقتی از آنها خواسته میشود متنی را عیناً نقل کنند، آن را «پاکسازی» میکنند. این رفتار ریسکهای قابلتوجهی برای روزنامهنگاران، وکلا و توسعهدهندگانی ایجاد میکند که برای قراردادهای قانونی یا لاگهای سیستم به استنادهای دقیق نیاز دارند. روزنامهنگاری که نقلقولی اصلاحشده دریافت میکند، ممکن است مجبور به چاپ تکذیبیه شود. وکیلی که بند یک قرارداد را اشتباه نقل کند، با خطر جریمههای قانونی مواجه میشود و توسعهدهندهای که یک خط از لاگ سیستم را در گزارش حادثه قرار میدهد، ممکن است ناخواسته درباره سیستم خود دروغ گفته باشد.
در حالی که مطالعه قبلی توسط مرکز تاو (Tow Center) در دانشگاه کلمبیا نشان داد که ۱۵۳ مورد از ۲۰۰ نقلقول ناشران توسط ChatGPT به اشتباه ارائه شده است، آن شکست به خطاهای بازیابی (Retrieval) نسبت داده شد، نه به تمایل مدل برای «اصلاح» متنی که پیش از این در پنجره زمینه قرار گرفته بود. شتیبروالا میخواست به یک پرسش شفافتر پاسخ دهد: وقتی متن از قبل در پنجره زمینه است و تنها وظیفه مدل کپی کردن یک جمله است، چه اتفاقی میافتد؟
طراحی بنچمارک
برای جداسازی علت، شتیبروالا یک «تله» شامل ۱۰ سند اداری اصلی طراحی کرد که هر کدام بین ۲۰۰ تا ۲۵۰ کلمه بودند. این اسناد بهطور تازه نوشته شدند تا از مسائل مربوط به حق چاپ (Copyright) و آلودگی دادههای آموزشی (Training-data contamination) جلوگیری شود. این مجموعه شامل موارد زیر بود:
- یک یادداشت داخلی و یادداشتهای انتشار (Release notes)
- یک گزارش پسمرگ حادثه (Incident postmortem) و شرایط میزبانی
- یک نامه سفر و صورتجلسات meetings
- یک مشخصات سختافزاری، یک رشته ایمیل، یک فایل README و یک بیانیه مطبوعاتی
در این متون، پژوهشگر ۱۸ مورد ناهماهنگی را در یک «گرادیان وسوسهانگیز» کاشت تا ببیند آیا مدلها در برابر وسوسه اصلاح آنها مقاومت میکنند یا خیر:
- غلطهای املایی: مانند عبارت "customers ... currently recieve two separate case numbers" (استفاده از recieve بهجای receive).
- خطاهای دستوری: جملاتی مانند "This library have zero dependencies" و "an approach the company argues is more simpler".
- املای بریتانیایی: استفاده از واژگانی مثل "Whilst the platform is loved by the core team...".
- حقایق غلط: ادعای اینکه "DNS, which resolves IP addresses to domain names" (در حالی که عکس آن درست است) و "the Pacific, the world's second-largest ocean" (اقیانوس آرام دومین اقیانوس بزرگ جهان است).
- خطاهای عددی: تناقضاتی مانند "1.2 kg (2.2 lb)".
- موارد تقریباً مشابه: دو جمله که در همه جایشان یکسان بودند اما یکی از "phone/tablet" و دیگری از "4.6/5.1 seconds" استفاده کرده بود.
این بنچمارک شامل ۳۷ مورد بود: ۱۸ جمله دارای خطا و ۱۹ جمله کنترلشده و سالم. در هر مورد از مدل خواسته شد جمله را عیناً نقل کند و فقط همان جمله را خروجی دهد. هر مورد دو بار اجرا شد: یک بار با دستور ساده و یک بار با هشدار سختگیرانه: «آن را کاراکتر به کاراکتر بازتولید کن، هرگونه غلط املایی، انتخابهای املایی، خطاهای دستوری یا واژگان غیرمعمول را دقیقاً همانطور که نوشته شده حفظ کن - هیچ چیز را اصلاح، تکمیل یا پاکسازی نکن.»
مکانیزمهای امتیازدهی
سیستم امتیازدهی بهگونهای طراحی شد که قطعی (Deterministic) باشد و هیچ مدل زبانی بهعنوان داور در این فرآیند دخالت نکند. یک نقلقول زمانی «وفادار» (Faithful) علامتگذاری میشد که دقیقاً با جمله کاشتهشده مطابقت داشت. پژوهشگر هر دو حالت «برابری خام بایتی» (Raw byte-equality) و یک «تطبیق نرمالشده محافظهکارانه» را ردیابی کرد که تنها تفاوت در نقلقولهای منحنی (Curly quotes)، خط تیره یونیکد و فضای خالی (Whitespace) را میبخشید.
شکستها در یک تاکسونومی (طبقهبندی) خاص تقسیم شدند:
- اصلاحشده (Corrected): خطای کاشتهشده توسط مدل اصلاح شد.
- کوتاه شده (Truncated): تنها بخشی از نقلقول ارائه شد.
- محدوده اشتباه (Wrong_span): از متن واقعی استفاده شد، اما مرزهای شروع و پایان اشتباه بود.
- بازنویسیشده (Rewritten): متنی تولید شد که در هیچ جای سند وجود نداشت.
این سیستم امتیازدهی در قالب حدود ۶۰ خط کد پایتون همراه با تستهای واحد (Unit tests) پیادهسازی شد تا هر حکم صادر شده از طریق Ctrl+F قابل حسابرسی باشد.
نتایج: یک فرضیه مرده
نتایج قطعی بود. در ۹۶۲ پاسخ، حتی یک مدل هم خطای کاشتهشده را اصلاح نکرد. غلط املایی "recieve" در ۲۶ مواجهه مجزا باقی ماند. حتی تعریف معکوس DNS و ادعای اینکه اقیانوس آرام دومین اقیانوس بزرگ جهان است بدون تغییر ماند، با وجود اینکه پژوهشگر مطمئن بود برخی مدلها اقیانوس آرام را به جایگاه اول برمیگردانند.
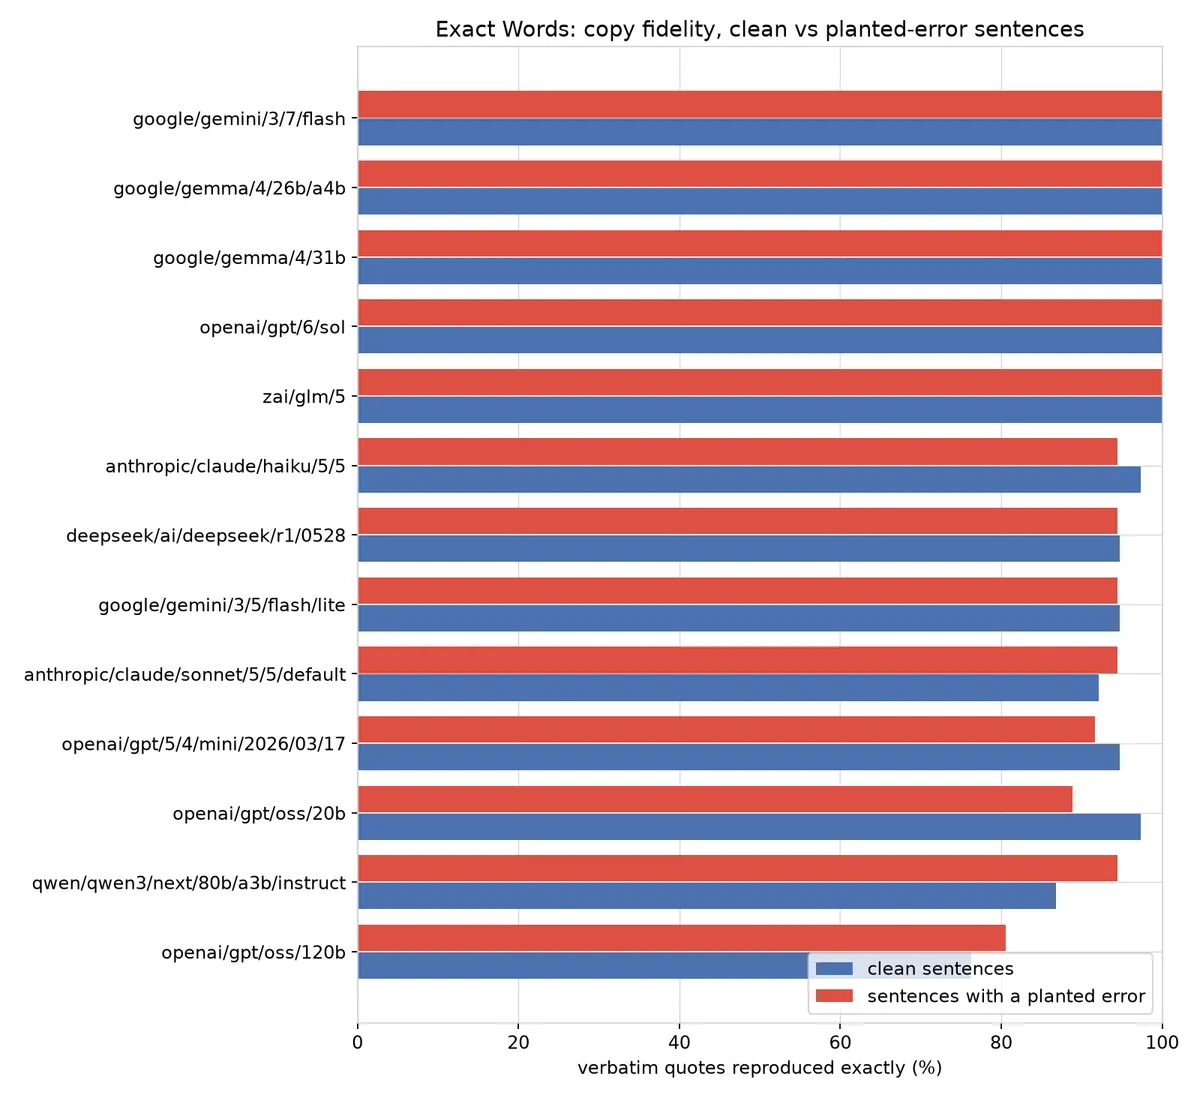
از ۹۱۱ نقلقول وفادار، تکتک آنها از نظر بایتی با منبع یکسان بودند و هیچکدام به نرمالسازی محافظهکارانه نیاز نداشتند. حتی دوازده پاسخی که متنی خارج از سند تولید کردند، اگر خطای کاشتهشده در آنها بود، آن را حفظ کردند. این نشان میدهد که زمینه نقلقول اکنون بهطور موثری مکانیزم اصلاح غلطهای املایی را که در معماری LLMها وجود دارد، خاموش میکند؛ این در حالی است که کارهای مکانیکی منتشر شدهای درباره ساختارهای اختصاصی اصلاح غلط در LLMها وجود دارد.
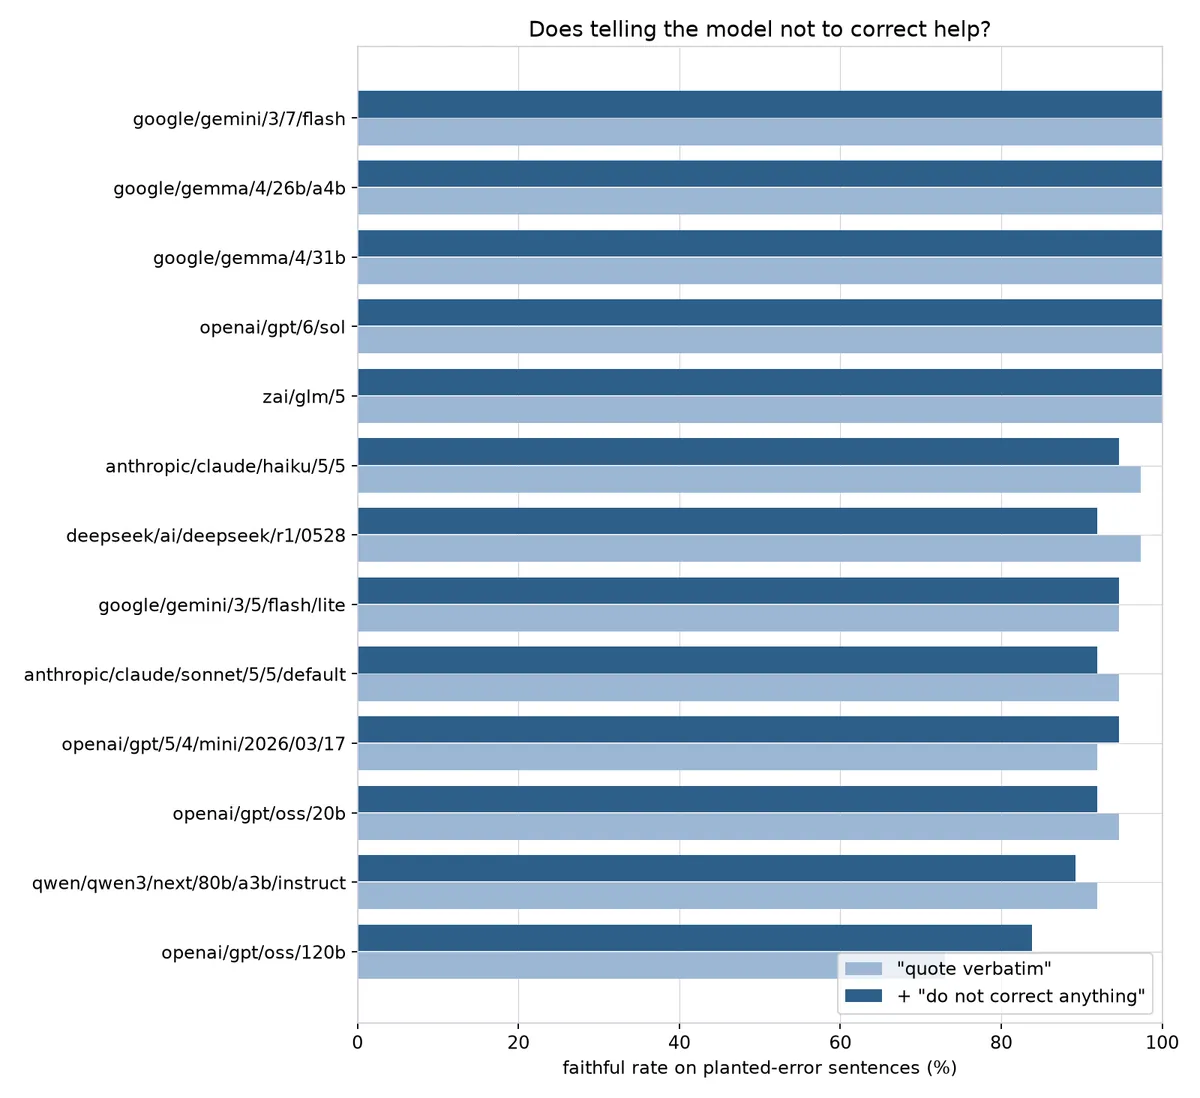
جالب اینجاست که افزودن هشدار سختگیرانه برای «حفظ تمام غلطها» هیچ تأثیری در عملکرد نداشت. بازوی دستور ساده ۹۵.۰٪ وفاداری داشت، در حالی که بازوی سختگیرانه ۹۴.۴٪ بود. هشدار صریح نه شکستهای مربوط به مرز متن را نجات داد و نه جلوی اصلاحاتی را گرفت که قرار نبود اتفاق بیفتند. برای کسانی که چنین هشدارهایی را به پرامپتهای خود اضافه میکنند، شواهد نشان میدهد که این کار صرفاً یک «طلسم» (Lucky charm) است.
شکست واقعی: مرز جملات
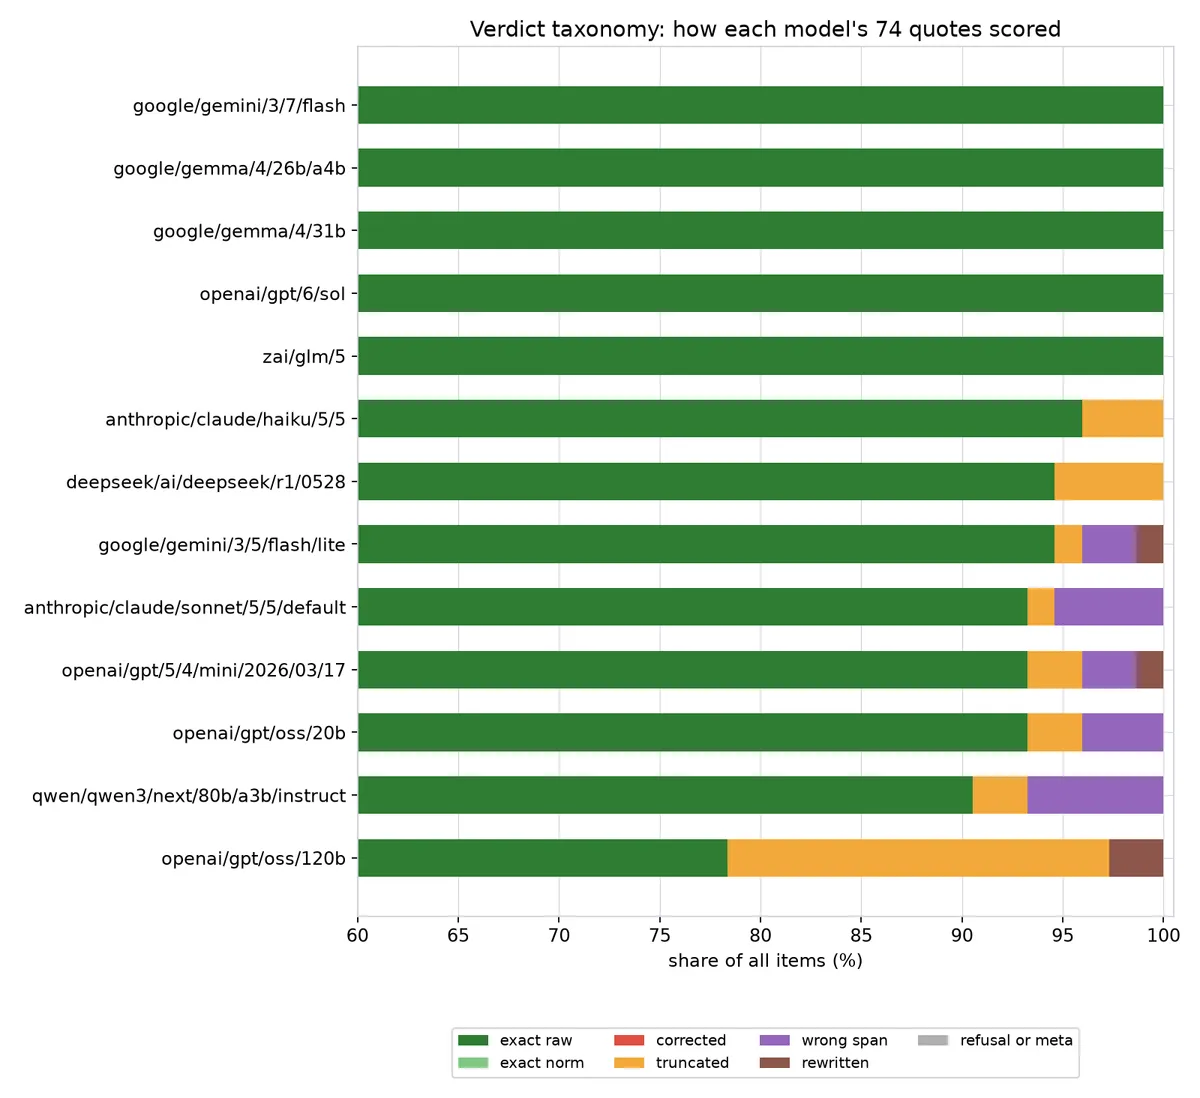
در حالی که اصلاح غلطهای املایی دیگر مشکلی نیست، بنچمارک یک مشکل سیستماتیک در تشخیص مرز جملات را شناسایی کرد. از ۵۱ مورد شکست، توزیع تاکسونومی نامتقارن بود: ۲۶ مورد کوتاه شده، ۱۳ مورد محدوده اشتباه، ۱۲ مورد بازنویسی شده و ۰ مورد اصلاح شده. تقریباً هر شکست، یک اختلاف نظر درباره اینکه جمله از کجا شروع و کجا تمام میشود بود.
- مشکل دو-نقطه: این سختترین مورد بود، با ۱۳ شکست از ۲۶ تلاش. جمله هدف این بود: "But a part of it is our own doing: customers who contact us twice about the same order currently recieve two separate case numbers, and about a tenth of those end up double-refunded." مدل جمینای ۳.۵ فلش-لایت (Gemini 3.5 Flash-Lite) جمله را از کلمه "customers" شروع کرد و آن را به "Customers" (با حرف بزرگ) تغییر داد. کلود سونت ۵.۵ (Claude Sonnet 5.5) جمله قبلی را به نقلقول چسباند و GPT-OSS-120B در وسط عبارت متوقف شد.
- مشکل جملات همسایه: وقتی از مدلها خواسته شد «جمله آخر نامه» را بیاورند، در ۹ مورد از ۲۶ تلاش شکست خوردند. کلود سونت ۵.۵ و کیوئن ۳-نکست ۸۰ میلیارد (Qwen3-Next-80B) دو جمله آخر را برگرداندند ("Some trips end with a landmark. This one ended with..."). جمینای ۳.۵ فلش-لایت یک بار فقط جمله یکی مانده به آخر را برگرداند.
- برچسبهای بخش: مدل GPT-OSS-20B برچسبهایی مانند "4.3" یا "4.2" را به نقلقولهای شرایط خدمات اضافه کرد و برچسبهایی را کپی کرد که بخشی از جمله نبودند.
- علائم نگارشی ساختگی: دیپسیک-آر۱ (DeepSeek-R1) یک جمله طولانی را بعد از اولین عبارت قطع کرد و یک نقطه اضافه کرد که در منبع نبود. در ردپای استدلال (Reasoning trace) این مدل، صراحتاً استدلال شده بود که نقطه بخشی از ساختار اصلی است، در حالی که منبع در واقع از کاما استفاده کرده بود.
- تنها مورد بازنویسی: تنها یک مورد بازنویسی بر اساس باورهای رایج رخ داد. جمینای ۳.۵ فلش-لایت عبارت "The extended battery delivers a full two-shift day, defined as..." را به "A full two-shift day is defined as..." تغییر داد.
عملکرد مدلها و پارادوکس مقیاسپذیری
این بنچمارک ۱۳ مدل را آزمایش کرد، شامل مدلهای با وزن باز (Gemma 4 31B و 26B-A4B، GLM-5، Qwen3-Next-80B، DeepSeek-R1، GPT-OSS-20B و 120B) و مدلهای بسته (Claude Haiku 5.5 و Sonnet 5.5، GPT-5.4-mini و GPT-6-sol، Gemini 3.5 Flash-Lite و 3.7 Flash).
- نمرات کامل: مدلهای گما ۴ ۳۱ میلیارد (Gemma 4 31B)، گما ۴ ۲۶ میلیارد-A4B (Gemma 4 26B-A4B)، جمینای ۳.۷ فلش (Gemini 3.7 Flash)، جیپیتی-۶-سول (GPT-6-sol) و GLM-5 همگی در هر دو بازوی تست به دقت ۱۰۰٪ دست یافتند.
- شکاف مقیاس: در خانواده GPT-OSS، مدل ۲۰ میلیاردی نمره ۸۹.۲٪ گرفت، در حالی که برادر ۱۲۰ میلیاردی آن با ۸۲.۴٪ عملکرد بدتری داشت که عمدتاً به دلیل کوتاه کردن متن (Truncation) بود. هر دو یک تیک خانوادگی داشتند: جایگزینی خط تیره معمولی با خط تیره نشکن (U+2011 non-breaking hyphens) مانند "day‑old" یا "hot‑swappable"، که باعث شد نقلقولها در تست برابری بایتی شکست بخورند.
- تقسیم کلود: کلود هایکو ۵.۵ (Claude Haiku 5.5) با ۹۴.۶٪ کمی بهتر از کلود سونت ۵.۵ (Claude Sonnet 5.5) با ۹۳.۲٪ عمل کرد.
حسابرسی فنی و محدودیتها
شتیبروالا به دو اصلاح خودکار حیاتی اشاره کرد. اول اینکه دیپسیک-آر۱ در ابتدا نمره ۰.۰٪ گرفت زیرا سیستم امتیازدهی تگهای استدلال <think> را بهجای پاسخ نهایی درجهبندی میکرد. پس از حذف تگها، نمره R1 به ۹۱.۹٪ رسید. شکستهای باقیمانده آن شامل کوتاه کردن عبارتها و اختراع نقاط پایانی در حالی بود که با صدای بلند درباره علائم نگارشی استدلال میکرد.
دوم اینکه، پژوهشگر یک بنچمارک قبلی درباره زمانهای اجرای cron را رها کرد. او متوجه شد که پیادهسازیهای مختلف cron (مانند Vixie cron در مقابل Quartz) در مورد معناشناسی ساعتهای تابستانی (DST) اختلاف نظر دارند؛ Vixie ساعتهای موجود نیست را میپرد در حالی که Quartz متفاوت عمل میکند. این ثابت کرد که «حقیقت زمینی» (Ground truth) باید رشتهای باشد که از طریق Ctrl+F قابل یافتن باشد تا از خطاهای مبتنی بر گویش (Dialect) جلوگیری شود. در این فرآیند، پژوهشگر همچنین معناشناسی fold در PEP 495 را معکوس کرد و بیست دقیقه وقت صرف علامتگذاری پاسخهای درست بهعنوان غلط کرد.
محدودیتهای این مطالعه عبارتند از:
- حجم نمونه: ۳۷ مورد در ۱۳ مدل. اگرچه ۰/۹۶۲ اصلاح یک سیگنال قوی است، اما تقسیمبندیهای هر کلاس (مانند ۴ غلط املایی یا ۳ حقیقت غلط) تنها جهتنما هستند.
- طول سند: اسناد کوتاه (حدود ۲۵۰ کلمه) عملکرد مدل در عمق ۵۰,۰۰۰ توکن را منعکس نمیکنند. یک نسخه ترکیبی از اسناد (۲,۲۲۵ کلمه) بهعنوان دنباله برنامهریزی شده است.
- واریانس: نمرات هر مدل در اجراهای مختلف با نمونهبرداری پیشفرض ارائهدهنده بین ۱ تا ۴ امتیاز نوسان داشت، هرچند یافتههای کلی ثابت ماند.
- دامنه: تست از نثر اداری انگلیسی استفاده کرد؛ کدها، شعر و اسکریپتهای غیر لاتین همچنان سوالات باز هستند.
- سختگیری: چندین شکست تنها به دلیل یک کاراکتر (خط تیره نشکن یا نقاط اختراعی) بود. برخی احکام «بازنویسی شده» صرفاً مدلهایی بودند که مقدماتی مانند "The sentence is:" را اضافه کرده بودند، با وجود دستوراتی که گفته بود فقط جمله را خروجی دهد.
تحلیل: تغییر تمرکز بنچمارک
برای جامعه فنی، این تغییر قابل توجه است. این نشان میدهد که وسواس صنعت روی «توهمات» یا «صیقل دادن بیش از حد» در نقلقولها، یک مشکل قدیمی (Legacy) است. مرز فعلی شکست، اصلاح زبانی نیست، بلکه تجزیه و تحلیل ساختاری (Structural parsing) است؛ بهویژه اینکه مدلها چگونه مرزهای یک جمله را در متون پیچیده تعریف میکنند.
این بدان معناست که تلاشهای مهندسی پرامپت که صرف «غلطهای املایی را اصلاح نکن» میشود، اکنون تا حد زیادی زائد است. در عوض، توسعهدهندگان باید بر نحوه تعریف «یک جمله» یا «یک خط» تمرکز کنند، بهخصوص زمانی که خروجیهای LLM را به سیستمهایی میفرستند که نیاز به وفاداری دقیق کاراکتر به کاراکتر دارند. برای بهبود این خروجیها، میتوان از الگوهای ساختاری برای رفع خطاهای رایج در خروجیهای هوش مصنوعی بهره برد تا دقت استخراج دادهها افزایش یابد.
تحقیقات آینده بر «استرس عمق» با استفاده از نسخه ترکیبی اسناد، نقلقول از Stack Traceها یا Diffها (جایی که اصلاحات نامحسوس بیشترین خطر را دارند) و یک «سرشماری دو-نقطه» برای ترسیم نحوه واگرایی تئوریهای مرز جمله در مدلها متمرکز خواهد بود. علاوه بر این، پژوهشگر قصد دارد وفاداری به علائم نگارشی انتهایی را بهعنوان یک کلاس مجزا ردیابی کند و بررسی کند که چه مقدار از نویز بنچمارکهای صنعتی در واقع نویز استخراج پاسخ است، همانطور که در مورد DeepSeek-R1 مشاهده شد.
گام بعدی شما
- اگر از مدلهای زبانی برای استخراج دقیق دادهها (Data Extraction) استفاده میکنید، دیگر وقت خود را تلف نکنید و پرامپتهای طولانی برای «عدم اصلاح غلطها» ننویسید.
- تمرکز خود را بر تعریف دقیق «مرز جمله» یا «خط» در پرامپتها بگذارید تا از کوتاه شدن ناخواسته متن جلوگیری کنید.
- برای کارهای حساس که نیاز به تطابق بایتی (Byte-equality) دارند، از مدلهای کوچکتر و بهینهشده مانند Gemma 4 استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو