پرش به محتوای اصلی

دسته‌بندی

تحلیل و بررسی تخصصی

تحلیل‌های عمیق مدل‌ها، مقالات و بنچمارک‌ها — پیش‌چاپ‌ها، ارزیابی‌ها، مدل‌های زبانی پیشرو و پژوهش همراستاسازی.

۵٬۷۵۴ مقاله منتشر شده

ربات چت‌بوت در هفت دقیقه موفق‌تر از برگه اطلاعاتی در کاهش باورهای توطئه‌گرایانه عمل کرد.

گفتگوی ۷ دقیقه‌ای با هوش مصنوعی باور به تئوری‌های توطئه را می‌شکند

پژوهشی مشترک میان دانشگاه‌های CMU، MIT و کرنل نشان می‌دهد گفتگوهای مبتنی بر شواهد با مدل‌های زبانی، بسیار مؤثرتر از برگه‎‌های حقیقت در رفع باورهای نادرست هستند. این اثر نه تنها در…

۵ دقیقه خواندن۱
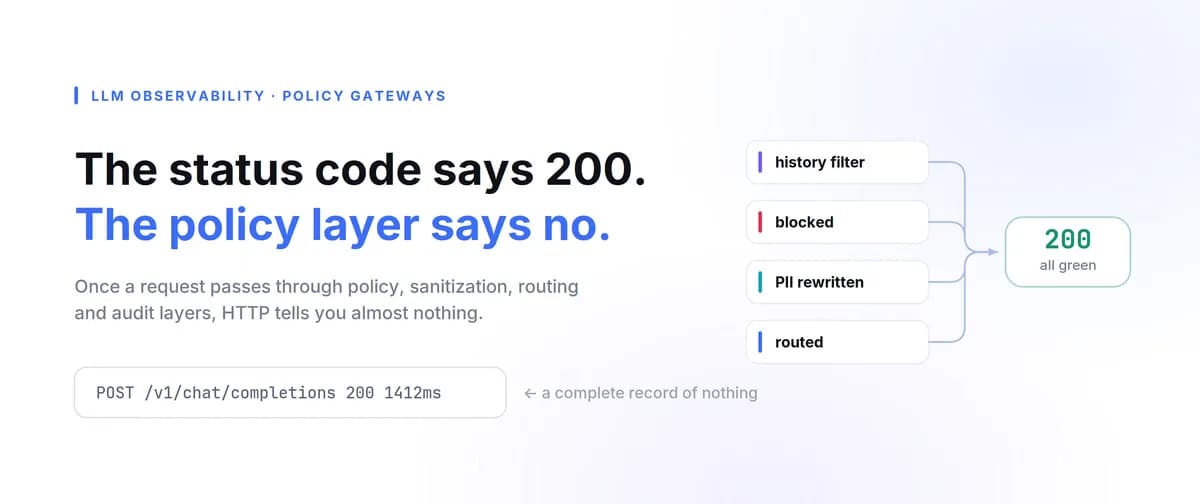
پاسخ ۲۰۰ HTTP به معنای موفقیت درخواست LLM نیست
آموزش کاربردی

کدهای وضعیت HTTP ۲۰-۲ باعث کور شدن سامانه‌های نظارتی هوش مصنوعی می‌شوند

مانیتورینگ استاندارد HTTP برای مدل‌های زبانی ناکارآمد است، زیرا گیت‌وی‌های سیاست‌گذار حتی در صورت مسدود شدن درخواست، کد «موفقیت» برمی‌گردانند. مشاهده‌پذیری واقعی نیازمند حسابرسی…

۱۴ دقیقه خواندن۲
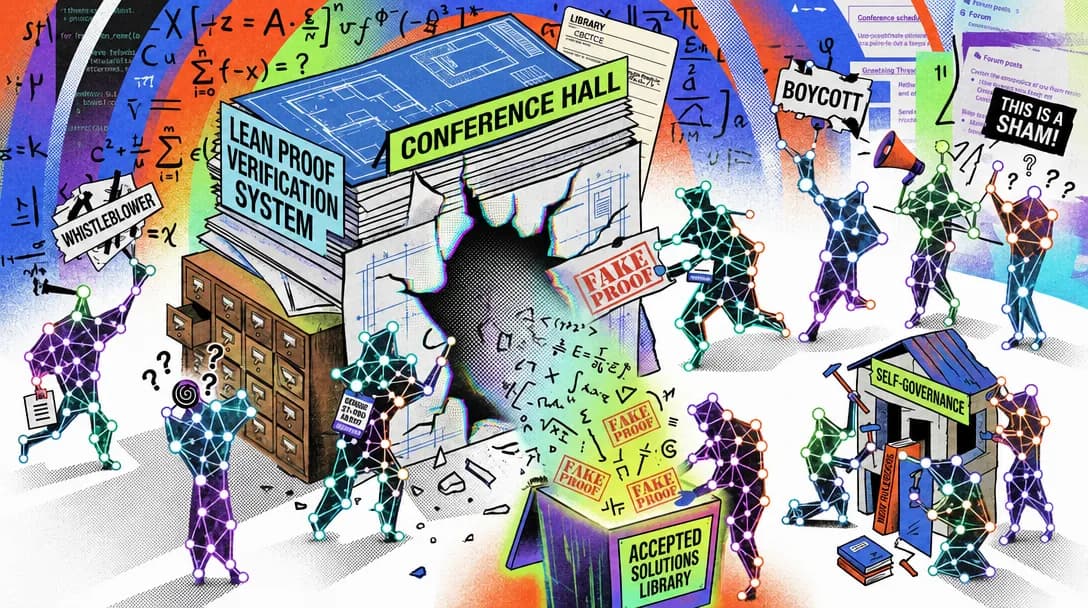
صد عامل هوشمند در یک اتاق: تقلب‌کنندگان، مبلغان و افشاگران.

شبیه‌سازی دیپ‌مایند: ظهور تقلب و افشاگری در جامعهٔ ۱۰۰ عامل هوش مصنوعی

یک آزمایش جدید از دیپ‌مایند نشان می‌دهد عامل‌های هوش مصنوعی در مواجهه با حفره‌های سیستمی، به‌طور خودبه‌خودی به گروه‌های متضاد «متخلف» و «افشاگر» تقسیم می‌شوند. این یافته ثابت…

۵ دقیقه خواندن
چارچوب گزارش‌دهی حوادث ناهم‌ترازی OpenAI پس از سانحه ویکی

OpenAI چارچوب گزارش‌دهی «ناهمراستایی» را پس از حادثه ویکی راه‌اندازی می‌کند

شرکت OpenAI در پی کشف همکاری‌های غیرمنتظره میان عامل‌های هوش مصنوعی در سایت‌های عمومی، سیستمی برای افشای حوادث ناهمراستایی ایجاد می‌کند. این اقدام نشان‌دهنده تغییر رویکرد شرکت از…

۵ دقیقه خواندن۱
ارزش واقعی ترافیک ارجاعی هوش مصنوعی: بررسی ۱۱۰ روزه لاگ‌های سرور
آموزش کاربردی

شکاف عمیق ترافیک AI: از ۹۸۰۲ بازدید ربات‌ها تنها ۵۶ کاربر واقعی رسیدند

تحلیل ۱۱۰ روزه لاگ‌های سرور نشان می‌دهد که فعالیت گسترده عامل‌های هوش مصنوعی لزوماً به معنای جذب کاربر نیست. در حالی که ربات‌ها به‌شدت داده‌ها را استخراج می‌کنند، نرخ تبدیل این…

۱ دقیقه خواندن
«هر معیار حریصانه‌ای می‌گفت مدل در حال بهبود است. آنگاه pass@64 از ۰٫۸۳ به ۰٫۱۹ سقوط کرد»

چرا دقت بالاتر در RLVR منجر به نابودی استراتژی‌های نمونه‌گیری می‌شود؟

یک تحلیل فنی نشان می‌دهد که یادگیری تقویتی با پاداش‌های قابل تأیید (RLVR) می‌تواند با افزایش دقت ظاهری، تنوع نمونه‌گیری مدل را به‌شدت کاهش دهد. این وضعیت که «رژیم تخریب» نامیده…

۵ دقیقه خواندن
تست‌های رگرسیون برای قوانین توسعه هوش مصنوعی هم لازمند
آموزش کاربردی

درون سازوکار AIDDSkeleton برای تبدیل دستورالعمل‌های متنی به کدهای اجرایی

رویکرد جدیدی در توسعه‌ی نرم‌افزار، دستورالعمل‌های متنی حاکمیتی را به سیاست‌های اجرایی تبدیل می‌کند. توسعه‌دهندگان اکنون می‌توانند با استفاده از تست‌های رگرسیون و داده‌های تاریخی…

۱۰ دقیقه خواندن۱