تیمهای تخصصی در برابر تکپرامپتها در اتخاذ تصمیمات مالی
پروژه متنباز TradingAgents با جایگزینی تکپرامپتها با تیمی از عاملهای تخصصی، فرآیند تحلیل بازار را به مناظرهای میان دیدگاههای صعودی و نزولی تبدیل کرده است. این چارچوب با…
۸ دقیقه خواندن۲
موضوع
گزارشها و تحلیلهای مربوط به توانایی تکرار و تأیید نتایج پژوهشهای هوش مصنوعی
۲۳۴ مقاله منتشر شده
پروژه متنباز TradingAgents با جایگزینی تکپرامپتها با تیمی از عاملهای تخصصی، فرآیند تحلیل بازار را به مناظرهای میان دیدگاههای صعودی و نزولی تبدیل کرده است. این چارچوب با…

یک بررسی فنی عمیق نشان میدهد که موتور Autograd در PyTorch بهجای تخمین شیب، مشتقات دقیق قاعده زنجیرهای را محاسبه میکند. با حذف لایههای انتزاعی، چرخه آموزش به یک فرآیند شفاف…
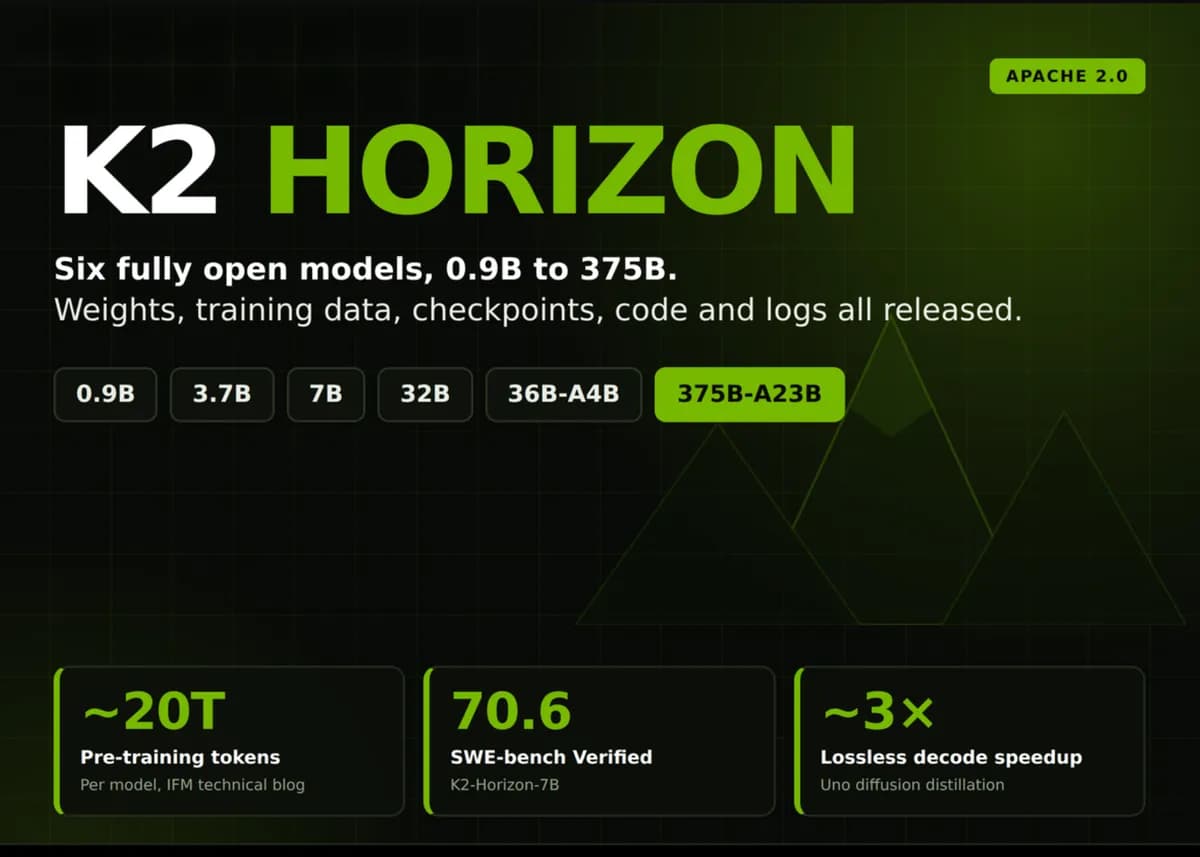
مؤسسه مدلهای بنیادی (IFM) خانواده مدلهای متنباز K2 Horizon را با معماریهای متنوع منتشر کرد. این مدلها با معرفی مکانیزم MoVA و آداپتورهای Uno، سرعت استنتاج را بدون کاهش کیفیت…

تکیه بر تاریخچهی چت برای بازبینی کدهای تولیدشده توسط عاملهای هوش مصنوعی، منجر به ایجاد «فولکلور» بهجای سوابق مهندسی میشود. برای تضمین تکرارپذیری، تیمها باید شناسهی مدل، هش…
پلتفرم TryNix با ترکیب WebAssembly و کشهای باینری، امکان اجرای هر نسخه از بستههای Nix را در یک ماشین مجازی لینوکسی درون مرورگر فراهم میکند. این ابزار نیاز به نصب محلی را حذف…
سازنده Mirofy با جایگزینی دادههای مصنوعی با مخازن واقعی کد، ۱۳ باگ بحرانی در تحلیل معماری نرمافزار یافت. این تجربه ثابت میکند تنها راه شناسایی لبههای پیچیده معماری، تست در…
یک پروتکل جدید با استفاده از هشهای رمزنگاریشده، مانع از تخیل عاملهای هوش مصنوعی درباره جزئیات سیستم میشود. این روش با جداسازی مشاهده از استناد، اجازه نمیدهد عاملها بدون مدرک…
یک چارچوب آزمون دو لایه با استفاده از اوراکلهای پنهان، مانع از «تقلب» مدلهای هوش مصنوعی در کدنویسی میشود. این روش تفاوت بین یک اصلاح واقعی کد و یک وصلهٔ سطحی که فقط تستهای…

توسعه سامانههای پیچیده چندعاملی بهدلیل نیاز به اجرای مجدد کل خط لوله برای تغییرات کوچک، بسیار هزینهبر است. رویکرد جدیدی با تبدیل جریانهای کاری به گرافهای وابستگی و استفاده از…
یک تحلیل فنی نشان میدهد که یادگیری تقویتی با پاداشهای قابل تأیید (RLVR) میتواند با افزایش دقت ظاهری، تنوع نمونهگیری مدل را بهشدت کاهش دهد. این وضعیت که «رژیم تخریب» نامیده…

پلتفرم Oqoqo با جایگزینی محکهای سنتی با محیطهای ایزوله (Sandbox)، امکان تست تعامل عاملها با APIها و SDKهای واقعی را فراهم میکند. این ابزار هر فراخوانی ابزار و هزینه توکن را…

روشهای سنتی تحلیل لاگ در شناسایی «رانش» (Drift) عاملهای هوش مصنوعی ناتواناند، زیرا مدلها بدون ایجاد خطا، ابزارها را نادیده میگیرند. سیستم پیشنهادی Run Card با استفاده از…