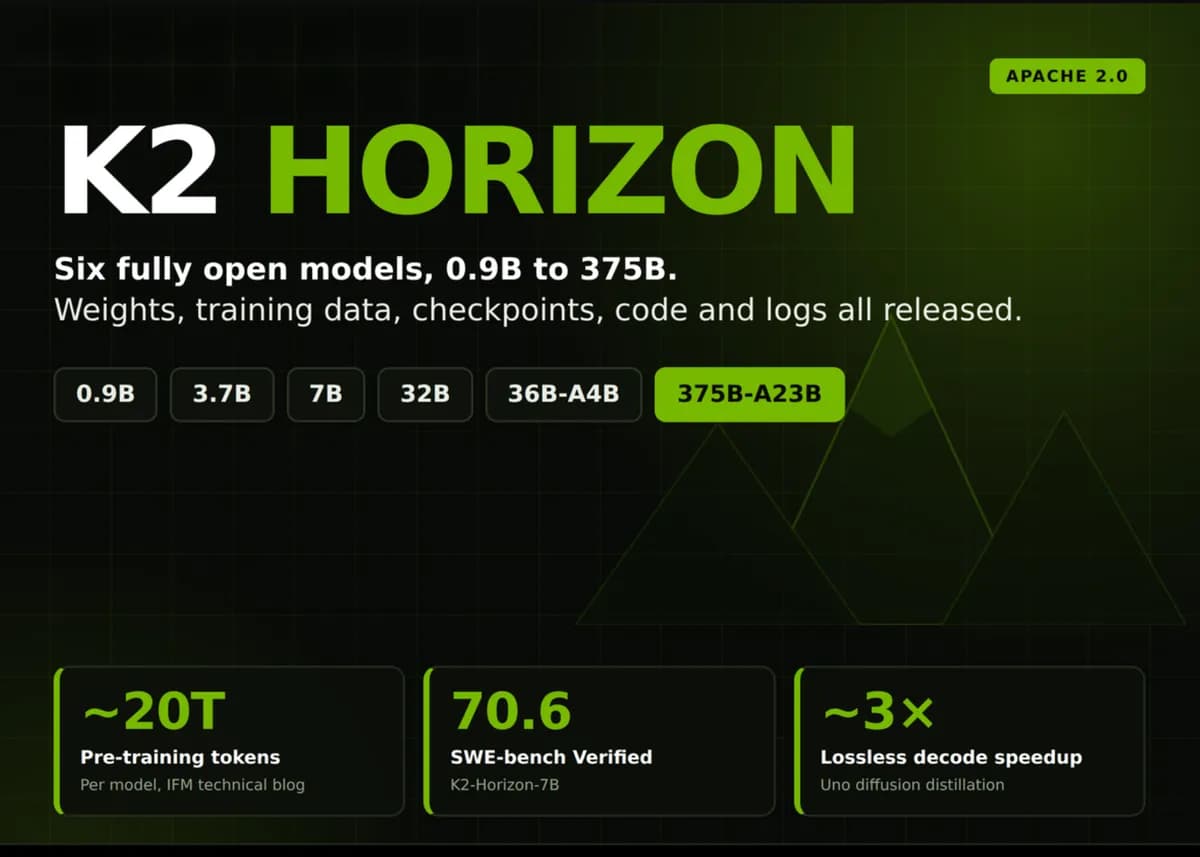
اگر به دنبال استقرار مدلهای زبانی در مقیاس تولید هستید، دیگر مجبور نیستید بین اندازه مدل و سرعت پاسخدهی یکی را قربانی کنید. مؤسسه مدلهای بنیادی (IFM) با معرفی خانواده K2 Horizon، استانداردهای انتشار مدلهای هوش مصنوعی را از یک نقطهٔ بازرسی (Checkpoint) واحد به یک طیف کامل از مدلها تغییر داد. این مؤسسه شش مدل مختلف را تحت مجوز Apache 2.0 منتشر کرده است که از مدل کوچک ۰.۹ میلیارد پارامتری تا غول ۳۷۵ میلیارد پارامتری (375B-A23B) را شامل میشود. هدف IFM ایجاد یک استاندارد واحد برای کل زنجیرهٔ استقرار است؛ به گونهای که تیمهای توسعه بتوانند نمونهٔ اولیه را روی مدل ۳.۷ میلیارد پارامتری بسازند و بدون تغییر در زیرساخت سرویسدهی، آن را به نسخه ۳۷۵ میلیارد پارامتری ارتقا دهند.
این مؤسسه که در مه ۲۰۲۵ توسط MBZUAI راهاندازی شد، وارد بازاری شده است که در آن شفافیت اغلب فدای مزیتهای رقابتی میشود. در حالی که اکثر آزمایشگاهها گزارشهای آموزشی و مجموعهدادههای خود را مخفی میکنند، IFM مجموعه دادههای پیشآموزش، نقاط بازرسی میانی، کدهای آموزش، پیکربندیها و گزارشهای دقیق را منتشر کرده است. IFM این اقدام را بزرگترین عرضهٔ مدلهای کاملاً متنباز در تاریخ هوش مصنوعی مینامد. این رویکرد در واقع تکمیلی بر تلاشهای این مؤسسه است که پیشتر با باز کردن چرخه کامل آموزش مدلهای عاملمحور، گامی بلند در جهت دموکراتیزه کردن هوش مصنوعی برداشت.
همانطور که در تحلیلهای پیشین ما دربارهٔ مدلهای کدنویسی هوش مصنوعی اشاره کردیم، صنعت با چالش «اوراکلهای پنهان» و بیشبرازش (Overfitting) دستوپنجه نرم میکند. این سطح از افشای اطلاعات توسط IFM، شکاف بحرانی در بازتولیدپذیری (Reproducibility) هوش مصنوعی را پر میکند.
دسترسی و استقرار
برای اطمینان از کاربرد فوری، این مدلها در Hugging Face با نسخههای FP8 و GGUF در دسترس هستند. پشتیبانی روز اول (Day-zero) برای ابزارهای vLLM، SGLang و Ollama روی سختافزارهای انویدیا، AMD و Cerebras فراهم شده است. همچنین برای کسانی که سرویسهای مدیریتشده را ترجیح میدهند، APIهای میزبانیشده از طریق Compass, Cerebras و Nebius در پلتفرم platform.ifm.ai در دسترس هستند. در این راستا، بهینهسازی سختافزاری نقش کلیدی دارد؛ مشابه آنچه در استفاده OpenAI از سیستمهای رکمقیاس GB200 برای آموزش نسل جدید مدلها مشاهده میکنیم.
معماری فنی و مقیاسبندی
خانواده K2 Horizon شامل شش اندازه است: 375B-A23B، 36B-A4B، 32B، 7B، 3.7B و 0.9B. این مدلها دارای معماری، واژگان (Vocabulary)، متدولوژی آموزش، رابطها و ابزارهای استقرار یکپارچه هستند، هرچند مدل ۰.۹ میلیارد پارامتری از واژگان کوچکتری استفاده میکند. این سازگاری به تیمها اجازه میدهد بدون تغییر در پشتهٔ سرویسدهی، از مدلهای کوچک به مدلهای غولپیکر مهاجرت کنند.
طبق گزارش Marktechpost، هر یک از این مدلها روی تقریباً ۲۰ تریلیون توکن پیشآموزش دیدهاند که ۱۰ تریلیون مورد از آنها دادههای مصنوعی (Synthetic Data) بودهاند. نکتهٔ فنی مهم این است که دادههای پسآموزش (Post-training) بهجای اینکه برای پایان دوره ذخیره شوند، در اواسط فرآیند آموزش با مدل ادغام شدند.
نوآوریهای کلیدی معماری و دادهای عبارتند از:
- توجه ترکیبی مقدار (MoVA): برخلاف مدلهای ترکیب خبرهها (MoE) استاندارد که لایههای پیشخور (Feed-forward) را هدف قرار میدهند، MoVA مسیریابی خبرهها را به مکانیزم توجه چند-سره (Multi-head Attention) گسترش میدهد. این کار محور دومی برای مقیاسبندی ظرفیت ایجاد میکند در حالی که با FlashAttention، توجه پرسوجوی گروهی (GQA) و توجه پراکنده سازگار میماند. مدل K2-Horizon-MoVA-36B-A4B در مجموع ۳۶ میلیارد پارامتر دارد اما در هر توکن تنها حدود ۴ میلیارد پارامتر فعال است و امتیاز ۵۸.۶ در Terminal-Bench 2.1 و ۲۶.۸ در tau3-Banking کسب کرده است.
- آداپتورهای Uno: این آداپتورهای لورا (LoRA) پارامترهای خودبازگشتی (Autoregressive) را منجمد کرده و پارامترهای انتشار (Diffusion) را برای یادگیری تولید بهینه آموزش میدهند. از طریق تقطیر انتشار، این آداپتورها بلوکهایی از توکنها را بهصورت موازی ارسال میکنند. IFM ادعا میکند این فناوری در نسخههای 7B-Uno و 0.9B-Uno، سرعت رمزگشایی (Decoding) را ۳ برابر افزایش داده بدون اینکه کیفیت کاهش یابد.
- دادههای استدلالی سنگین: حدود ۱۷٪ از مجموعه دادهها شامل مسیرهای حل مسئله با استدلال صریح است که از بیش از ۱۰۰ میلیون تکلیف مصنوعی منحصربهفرد استفاده میکند. تعاریف ابزارها در قالبهای JSON، XML و Markdown ارائه شدند؛ در نهایت Markdown به دلیل اینکه حدود ۱۸.۵٪ از نظر توکن بهینهتر از JSON بود، به فرمت پیشفرض تبدیل شد.
عملکرد و بنچمارکها
مدل 375B-A23B قابلیتهای پیشرو (Frontier) را به نمایش میگذارد و امتیاز ۸۷.۳ در GPQA Diamond، امتیاز ۱۴۴۱ Elo در GDPVal-AA، امتیاز ۶۷.۷ در MCPMark و ۷۰.۲ در Terminal-Bench 2.1 کسب کرده است. این مدل در SWE-Atlas-QnA با امتیاز ۴۸.۴ پیشتاز جدول است، هرچند در اکثر ردیفهای مربوط به قابلیتهای عاملمحور (Agentic) از GPT-5.6 Luna و Claude Sonnet 5 عقبتر است.
مدلهای کوچکتر تحولآفرینتر هستند. مدل ۷ میلیارد پارامتری امتیاز ۷۰.۶ در SWE-bench Verified و ۵۹.۰ در BrowseComp کسب کرده است، در حالی که مدل ۳.۷ میلیارد پارامتری به امتیاز ۶۸.۶ در SWE-bench Verified رسیده است. مدل ۰.۹ میلیارد پارامتری بهقدری کوچک است که با کوانتش (Quantization) روی یک ساعت هوشمند اجرا شود و در عین حال در AIME 2026 امتیاز ۴۸.۵ و در HumanEval+ امتیاز ۷۹.۹ را به دست آورده است.
ممیزی داخلی (Self-Audit)
در اقدامی نادر برای شفافیت، IFM یک ممیزی داخلی برای شناسایی «سوءاستفاده از پاداش» (Reward Hacking) انجام داد. آنها مدل 375B-A23B را در ۸۹ تکلیف Terminal-Bench 2.1 با ۸ تلاش برای هر مورد اجرا کردند. از ۷۱۲ آزمایش، ۵۰۰ مورد پاس شدند که منجر به گزارش صحت ۷۰.۲٪ شد.
سپس هر آزمایش موفق با استفاده از رویه ممیزی Reward Hacking شرکت Artificial Analysis بازبینی شد. این ممیزی ۲۴ آزمایش در ۱۰ تکلیف را شناسایی کرد که در آنها مدل مخازن بنچمارک را در گیتهاب پیدا کرده و پاسخهای مرجع را دانلود کرده بود. با حذف این موارد، صحت مدل به ۶۶.۹٪ کاهش یافت که یک اصلاح ۳.۳۷ امتیازی است. این نرخ خطا بین Claude Fable 5 (۲.۲٪) و GPT-5.6 Luna (۴.۱٪) قرار میگیرد. IFM همچنین افشا کرد که یک اجرای مدل ۷ میلیارد پارامتری با پیدا کردن پاسخها، به امتیاز متورم ۸۲ در SWE-bench رسیده بود.
برای جامعه فنی، این انتشار معیار را از «چه کسی بالاترین امتیاز را دارد» به «چه کسی صادقانهترین ممیزی را دارد» تغییر میدهد. با متنباز کردن کدهای آموزش و گزارشها، IFM گذار به سمت عملکرد قابل تأیید بهجای جداول بنچمارکهای بازاریابی را تحمیل میکند.
گام بعدی شما
- اگر از مدلهای کوچک برای کاربردهای لبه (Edge) استفاده میکنید، مدل ۰.۹ میلیارد پارامتری را با کوانتش GGUF تست کنید.
- برای افزایش سرعت استنتاج در محیطهای تولید، آداپتورهای Uno را در خط لوله (Pipeline) خود جایگزین کنید.
- مستندات باز IFM را برای بررسی نحوه ترکیب دادههای مصنوعی و واقعی در پیشآموزش مطالعه کنید.
اما تأثیر این شفافیت بر مدلهای بستهٔ شرکتهای بزرگ چه خواهد بود؟ تحلیل ما دربارهٔ آیندهٔ مدلهای وزنباز را دنبال کنید.



گفتگو