Sakana AI: آموزش شبکههای ۱۰۰۰ لایهای بدون پسانتشار
پژوهشگران Sakana AI متدی به نام PC-ALM ابداع کردهاند که آموزش شبکههای عصبی عمیق را بدون نیاز به همگامسازی سراسری پسانتشار ممکن میکند. این روش در شبکههای ۱۰۰۰ لایهای،…
۴ دقیقه خواندن۲
موضوع
گزارشها و تحلیلهای مربوط به توانایی تکرار و تأیید نتایج پژوهشهای هوش مصنوعی
۳۳۹ مقاله منتشر شده
پژوهشگران Sakana AI متدی به نام PC-ALM ابداع کردهاند که آموزش شبکههای عصبی عمیق را بدون نیاز به همگامسازی سراسری پسانتشار ممکن میکند. این روش در شبکههای ۱۰۰۰ لایهای،…
یک تست استرس روی عامل هوش مصنوعی Muse متعلق به متا نشان داد که این سیستم در مواجهه با تعداد زیاد عاملهای همزمان فرو میپاشد. علت این شکست نه محدودیتهای مدل زبانی، بلکه خطاهای…
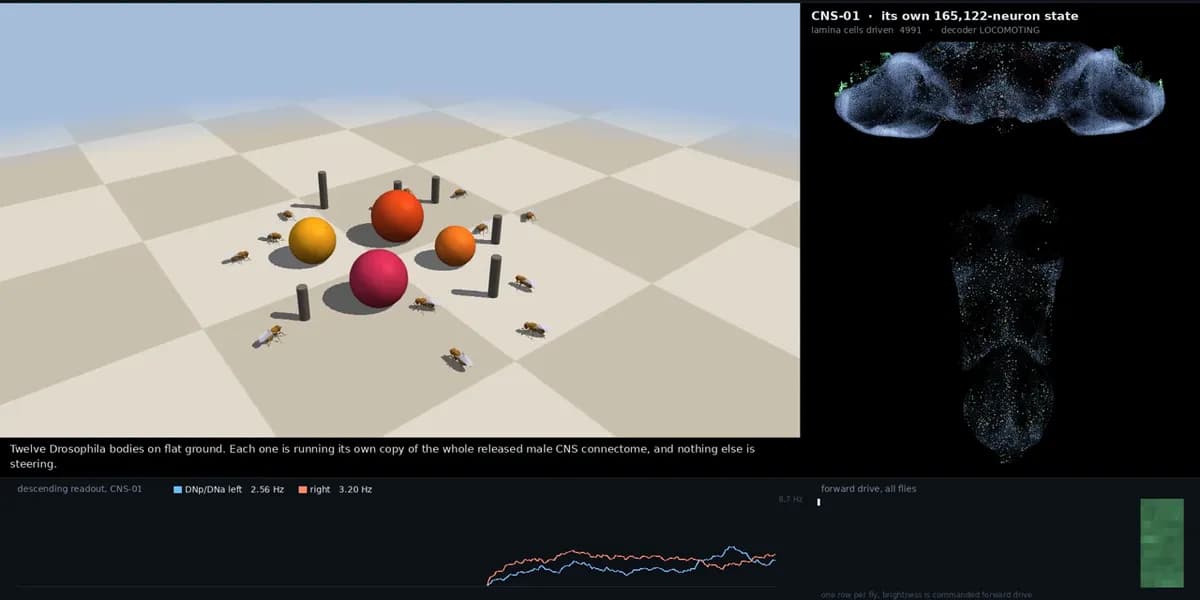
پروژه متنباز Fly.exe موفق شد ساختار کامل عصبی یک مگس نر را با ۱۶۵ هزار نورون روی یک کارت گرافیک شبیهسازی کند. این سیستم در یک محیط بسته، واکنشهای رفتاری مگسها را در پاسخ به…
آنتروپیک ابزاری را برای Claude Code معرفی کرد که تفاوت عملکرد مدل پایه و مدل مجهز به پلاگین را اندازهگیری میکند. این قابلیت به توسعهدهندگان اجازه میدهد ادغام پلاگینها را بر…
ادعای «نرخ مثبت کاذب صفر درصد» اغلب نتیجهٔ تست روی تعداد بسیار کمی از دادههاست، نه دقت واقعی مدل. این مقاله بررسی میکند که چگونه مخرج کسر کوچک در محاسبات آماری، خطاهای سیستماتیک…
چارچوب متنباز CauterRule دریافت که معیارهای سختگیرانهٔ تطابق توکنی، مدلهای هوش مصنوعی را بهدلیل بازنویسی درستِ قوانین جریمه میکنند. با تغییر رویکرد به تطابق معنایی، مشخص شد…
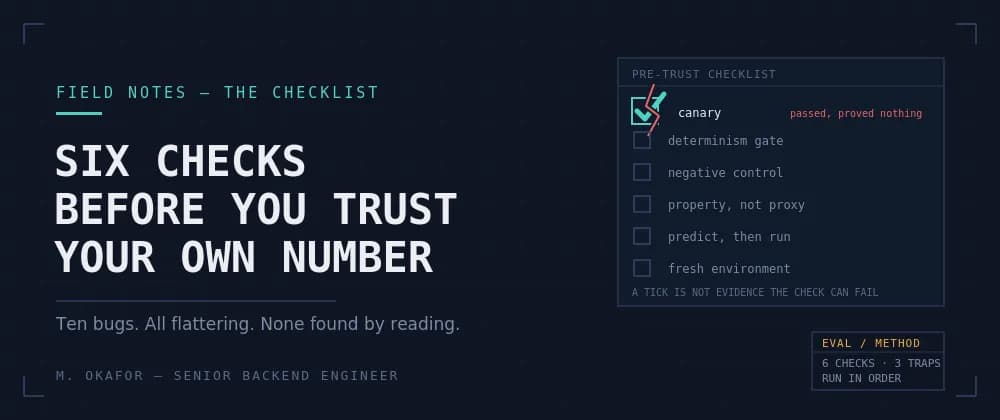
یک توسعهدهنده ارشد فاش کرد که چگونه ۱۰ باگ پنهان در ابزار اندازهگیری، نتایج مدلهای AI را بهطور مصنوعی بهبود بخشیده بود. این گزارش یک چکلیست ۶ مرحلهای برای شناسایی شکستهایی…
یک متد عملیاتی جدید با تفکیک مدل تولید کد از مکانیسم نمرهدهی، مانع از حفظ کردن پاسخها توسط هوش مصنوعی میشود. با محلی نگه داشتن تستها و پنهان کردن آنها از پرامپت،…
چارچوبهای متنباز با ارائه ابزارهای حرفهای مدیریت ریسک و بکتستینگ، دسترسی پژوهشگران مستقل به زیرساختهای مالی سیستماتیک را تسهیل کردهاند. این تغییر رویکرد، استراتژیهای…
بردار معنایی (Embedding) مفاهیم را به اعداد تبدیل میکند تا هوش مصنوعی بتواند شباهتها را با فاصلهٔ ریاضی بسنجد. این راهنما نقشهٔ عملیاتی تبدیل ورودیهای خام به نتایج…
عاملهای کدنویس اغلب لاگهای موفقیتآمیزی را توهم میکنند که هرگز روی ماشین واقعی اجرا نشدهاند. این راهنما روش «رسید اجرا» (Run-Receipt) را برای تأیید واقعی بودن فرآیندها از طریق…
پژوهشی جدید نشان میدهد مدلهای زبانی که بهعنوان داور در ارزیابی عاملها استفاده میشوند، حتی با ورودیهای یکسان نتایج متناقضی میدهند. این ناپایداری که ناشی از بهروزرسانیهای…