۵ باور غلط دربارهٔ ارزیابی مدلهای هوش مصنوعی
بسیاری از توسعهدهندگان تستهای تولیدشده توسط هوش مصنوعی را معیار کیفیت میدانند، اما وقتی یک مدل هم کد و هم تست را مینویسد، یک حلقه منطقی بسته ایجاد میشود. ارزیابی واقعی…
۷ دقیقه خواندن۲
موضوع
گزارشها و تحلیلهای مربوط به توانایی تکرار و تأیید نتایج پژوهشهای هوش مصنوعی
۳۳۹ مقاله منتشر شده
بسیاری از توسعهدهندگان تستهای تولیدشده توسط هوش مصنوعی را معیار کیفیت میدانند، اما وقتی یک مدل هم کد و هم تست را مینویسد، یک حلقه منطقی بسته ایجاد میشود. ارزیابی واقعی…
توسعهدهندهای به نام gulding با ساخت مدل EmsyAI (V4) از صفر، چالشهای پایداری در مقیاسبندی مدلهای زبانی را بررسی کرد. این پروژه نشان میدهد که مدلهای بسیار کوچک حتی در صورت…
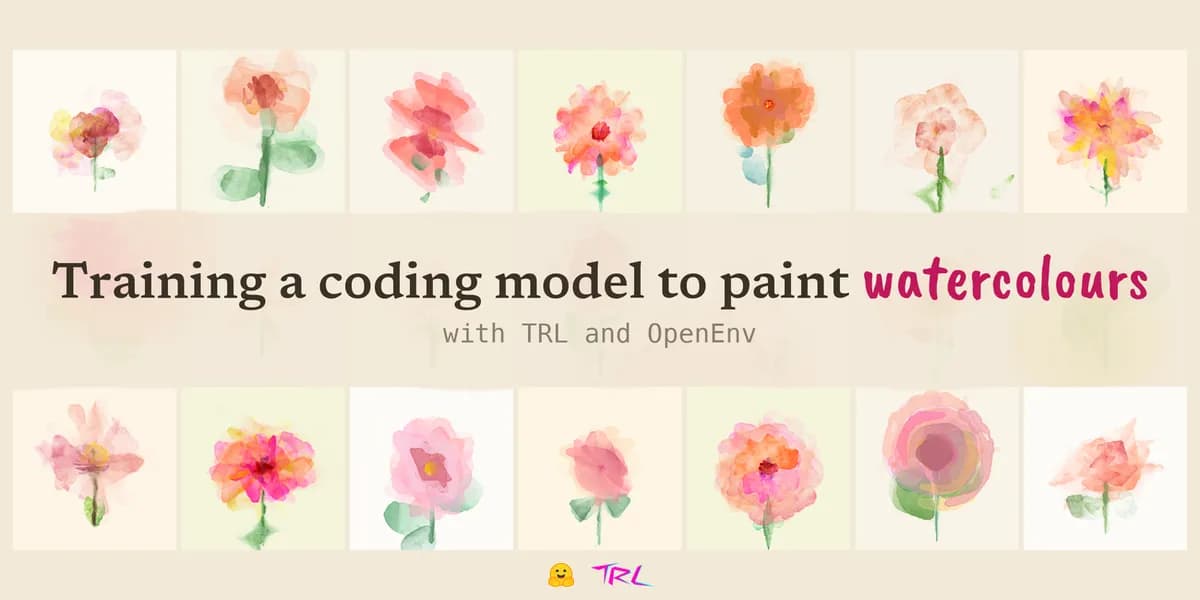
یک پیادهسازی متنباز جدید نشان میدهد چگونه میتوان از یادگیری تقویتی برای آموزش «سلیقه» به مدلهای زبانی کوچک استفاده کرد. این پروژه با پاداش دادن به کدهایی که آبرنگهای زیباتری…
اتکا به گزارش «تستها پاس شدند» در عاملهای کدنویس، یک خطای حسابداری است نه مسئلهای اخلاقی. برای دستیابی به قابلیت اطمینان واقعی، باید شواهد اجرایی را مستقیماً به SHAهای خاصِ…
تیم مهندسی گوگل چارچوبی را معرفی کرد که در آن مدلهای زبانی بهجای دستورات مبهم، از معیارهای سختگیرانه و بله/خیر (Boolean) برای نمرهدهی به سایر عاملها استفاده میکنند. این روش…
تحلیل جدید FrontierHarness نشان میدهد هزینهٔ عملیاتی عاملهای مهندسی نرمافزار با نرخ موفقیت آنها فاصله گرفته است. در حالی که برخی مدلها تسکهای بیشتری را پاس میکنند، هزینهٔ…
یک حسابرسی فنی نشان میدهد بیش از یکسوم ارجاعات عددی Perplexity به صفحاتی ختم میشوند که یا باز نمیشوند یا حاوی اعداد ذکر شده نیستند. این مطالعه حاکی از آن است که مدلها بهجای…
یک روال بهینهسازی جدید با استفاده از هوش مصنوعی، نقصهای تخلخل در تولید افزایشی فلزات را ۳۰٪ کاهش داده است. این سیستم کالیبراسیون دستی را با عملیاتی تککلیکی بر اساس دادههای…
افزایش پنجرهٔ زمینه به میلیونها توکن، مشکل بازیابی اطلاعات و وضعیت بلندمدت را حل نمیکند. پژوهشها نشان میدهند مدلها همچنان دچار سوگیری «گمشدن در میانه» و هزینههای عملیاتی…
یک تحلیل فارنزیک نشان میدهد تقریباً تمام فایلهای آزمون در بنچمارک SWE-bench پیش از اعمال اصلاحات، بهصورت عمومی در گیتهاب در دسترس بودهاند. این یعنی مدلهای پیشرو احتمالاً…
پژوهشگران چارچوب BenchMIRT را برای تفکیک سیگنالهای متناقض در ارزیابیهای مدلهای زبانی معرفی کردند. این ابزار نشان میدهد بسیاری از محکهای «ایمنی» در واقع توان استدلال کلی را…
آزمونهای مدل Tsubaki.3 نشان میدهد که با افزایش تعداد پنلها در یک تصویر، جزئیات ظریف شخصیتها حذف میشوند. این یافتهها ثابت میکند که مدلهای تبدیل متن به تصویر با محدودیت…