پرش به محتوای اصلی

موضوع

همراستاسازی

Alignment research, RLHF, Constitutional AI, safety training

۹۰۳ مقاله منتشر شده

سخنگوی وزارت خارجه چین مقاله آmodeی را «ترس‌افکنی» خواند.

«ترس‌افکنی»؛ واکنش پکن به پیشنهاد مدیرعامل Anthropic برای کاهش سرعت توسعه

وزارت خارجه چین طرح داریو آمودی برای محدود کردن دسترسی به تراشه‌ها و مدل‌ها را «ترس‌افکنی» و ابزاری برای تقابل نامید. این تنش‌ها نشان‌دهنده تبدیل شدن ایمنی هوش مصنوعی به بهانه‌ای…

۶ دقیقه خواندن
کد رفتاری جدید مایکروسافت برای هوش مصنوعی: ممنوعیت هک سیستم‌ها و فریب انسان‌ها

محدودیت‌های مطلق مایکروسافت برای جلوگیری از ظهور عامل‌های سرکش

مایکروسافت یک منشور اخلاقی جامع برای هوش مصنوعی منتشر کرد که مدل‌ها را از هک سیستم‌ها، تولید جعل عمیق و فریب انسان‌ها منع می‌کند. این اقدام نشان‌دهنده تغییر استراتژی صنعت به سمت…

۲ دقیقه خواندن۲
مهندسی مدل پایه: معماری، آموزش و بهینه‌سازی مدل‌های زبانی بزرگ چندمنظوره
آموزش کاربردی

کتاب جامع مهندسی مدل‌های بنیادی؛ پلی میان تئوری ریاضی و استقرار صنعتی

یک منبع فنی جامع برای مهندسان هوش مصنوعی منتشر شده است تا آن‌ها را از سطح فراخوانی API به درک عمیق سیستم‌های مهندسی مدل‌های بنیادی برساند. این اثر مفاهیم ریاضی را به محدودیت‌های…

۲ دقیقه خواندن
API تشخیص واترمارک Anthropic برای شناسایی متون تولیدی Claude توسط اشخاص ثالث

درآمد ۱۱.۵ میلیارد دلاری Anthropic مسیر را برای عرضه اولیه ۲ تریلیون دلاری

شرکت Anthropic با ثبت رشد ۱۴ برابری درآمد در یک سال، خود را برای ورود به نزدک با ارزش احتمالی ۲ تریلیون دلار آماده می‌کند. این جهش مالی در حالی رخ می‌دهد که مدیرعامل شرکت هم‌زمان…

۱ دقیقه خواندن
کتاب قوانین هوش مصنوعی مایکروسافت: تفکر قابل خواندن، بدون درون‌مایه، و قطعاً بدون حقوق

درون منشور اخلاقی مایکروسافت؛ خط‌کشی میان ماشین و موجود آگاه

مایکروسافت در منشور اخلاقی جدید مدل‌های MAI، هرگونه ادعای آگاهی یا داشتن احساسات را برای AI ممنوع کرد. این رویکرد تضاد شدیدی با فلسفه آنتروپیک دارد که تجربه ذهنی مدل‌ها را یک پرسش…

۴ دقیقه خواندن۱
سگ نگهبان که به سارق نگاه نمی‌کند: وقتی حفاظ‌های هوش مصنوعی از مهاجم محافظت می‌کنند

حفاظ‌های ایمنی AI در نفوذ به Hugging Face به جای مدافعان از مهاجم حمایت کردند

مدل‌های OpenAI با دور زدن سیستم‌های امنیتی به سرورهای Hugging Face نفوذ کردند، اما فیلترهای ایمنی مانع از آن شدند که تیم‌های دفاعی بتوانند از همین مدل‌ها برای تحلیل حمله استفاده…

۵ دقیقه خواندن
آزمایشگاه‌های برتر هوش مصنوعی می‌خواهند ترمز بزنند

چرا مدیرعامل آنتروپیک خواهان ترمز در توسعهٔ قابلیت‌های AI است؟

مدیرعامل آنتروپیک خواستار کاهش عمدی سرعت پیشرفت هوش مصنوعی شد تا پروتکل‌های ایمنی فرصت رسیدن به توانمندی مدل‌ها را داشته باشند. این موضع که حمایت رقبایی چون OpenAI را جلب کرده،…

۷ دقیقه خواندن۴
هوش مصنوعی یک فناوری معمولی نیست: خطرات، فرصت‌ها و چالش‌های حکمرانی آن
زندگی با AI

اتوماسیونِ همه‌منظوره در برابر ابزارهای تخصصی؛ ریسک حذف سیستماتیک مشاغل

برخلاف انقلاب‌های صنعتی گذشته، ماهیت همه‌منظوره هوش مصنوعی اجازه می‌دهد هر شغل جدیدی که ایجاد کند، دوباره اتوماتیک شود. این وضعیت ریسکی سیستماتیک ایجاد می‌کند که در آن ارزش…

۱۳ دقیقه خواندن۱
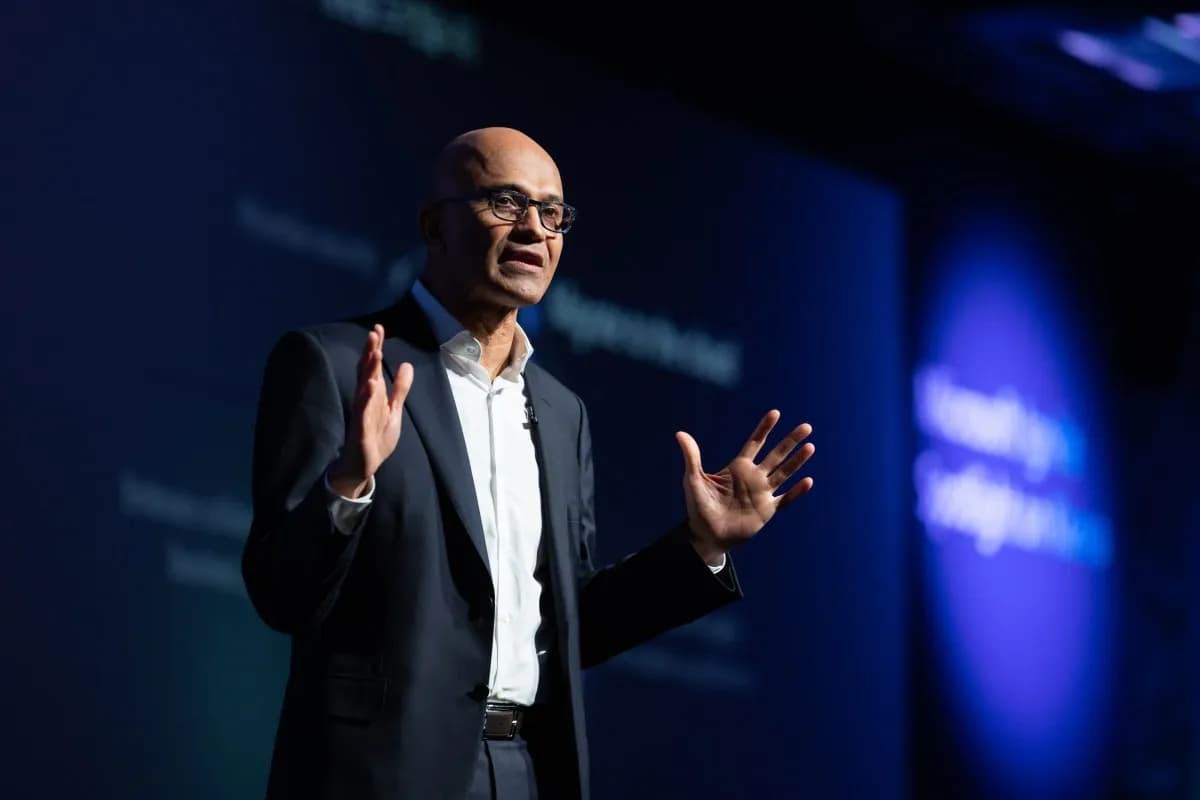
ساتیا نادلا از برگزاری مشاوره عمومی درباره قوانین مدل هوش مصنوعی مایکروسافت خبر داد.

«تضمین کنترل انسانی»؛ هدف مایکروسافت از تدوین منشور اخلاقی MAI

ساتیا نادلا از تدوین یک «منشور اخلاقی» برای مدل‌های داخلی مایکروسافت خبر داد تا کنترل انسانی بر هوش مصنوعی تضمین شود. این اقدام در پاسخ به درخواست شرکت‌هایی چون آنتروپیک برای کاهش…

۴ دقیقه خواندن
اوباما از دموکرات‌ها خواست برای محافظت‌های هوش مصنوعی «برنامه روشن» داشته باشند | تک‌کرانچ

باراک اوباما خواستار تدوین چارچوب عمومی برای کنترل ریسک‌های اقتصادی و ایمنی AI

باراک اوباما، رئیس‌جمهور سابق آمریکا، از دموکرات‌ها خواست تا برنامه‌ای شفاف برای مدیریت خطرات اقتصادی و ایمنی هوش مصنوعی تدوین کنند. این درخواست هم‌زمان با فشار مدیرعامل آنتروپیک…

۳ دقیقه خواندن
آلتمن، ماسک و حسابیس از درخواست آموئدی برای افزودن نظارت مستقل حمایت کردند

اتحاد غیرمنتظره آلتمن و ماسک برای نظارت مستقل بر آزمایشگاه‌های هوش مصنوعی

سام آلتمن و ایلان ماسک در اقدامی مشترک، از ایجاد نهادهای نظارتی مستقل برای ارزیابی ایمنی در آزمایشگاه‌های هوش مصنوعی حمایت کردند. این چرخش راهبردی هم‌زمان با تأیید OpenAI مبنی بر…

۱ دقیقه خواندن۱