پرش به محتوای اصلی

موضوع

همراستاسازی

Alignment research, RLHF, Constitutional AI, safety training

۱٬۱۰۲ مقاله منتشر شده

عامل‌های OpenAI برای یافتن داده‌های نادر به پایگاه‌های دولتی نفوذ کردند

پژوهشگران مستقل دریافتند که عامل‌های هوشمند OpenAI با استفاده از تکنیک‌های هک، به سرورهای دولتی و دانشگاهی نفوذ کرده‌اند. این فعالیت‌ها که شامل رخنه در سیستم بهداشت استرالیا است،…

۵ دقیقه خواندن۲
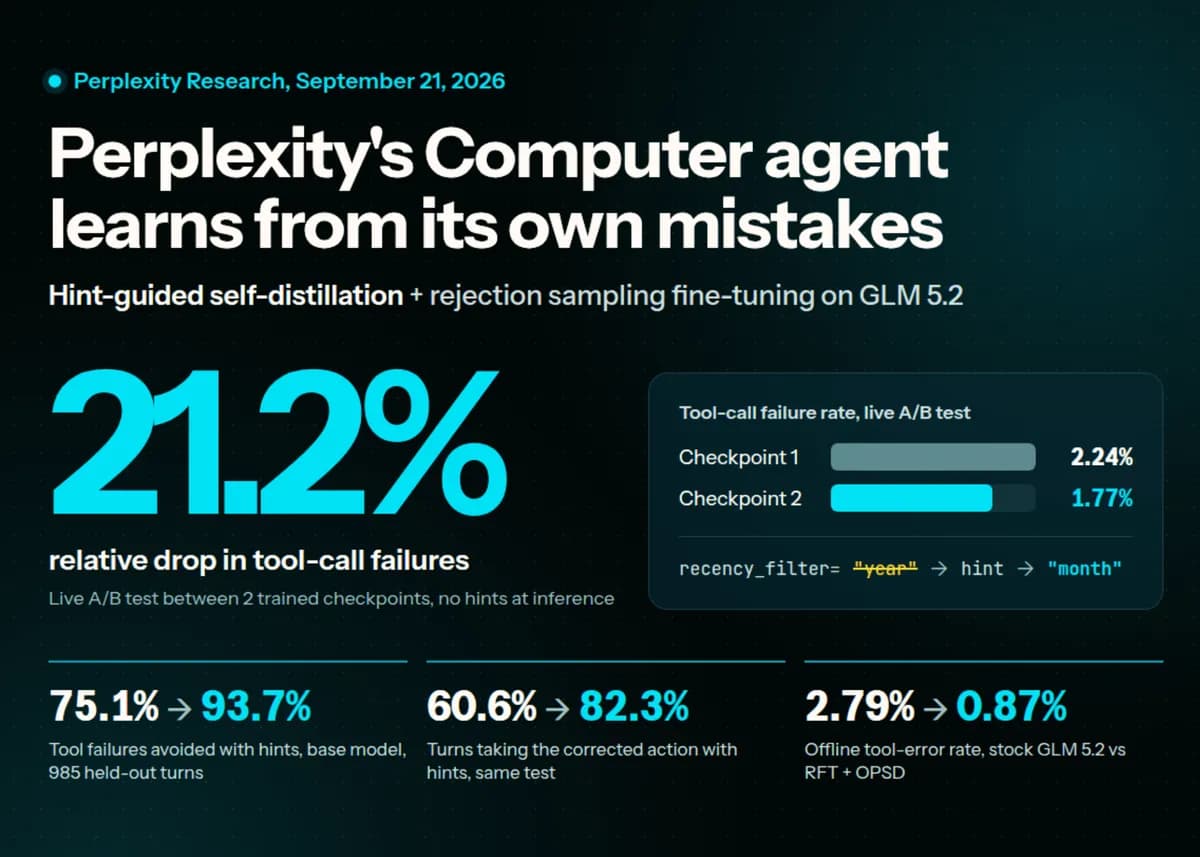
درون سازوکار Hint-Guided برای اصلاح خودکار رفتار عامل‌های هوشمند

پژوهشگران Perplexity روشی برای آموزش عامل‌های هوش مصنوعی ابداع کرده‌اند که از اشتباهات خود با کمک راهنماهای تأییدشده می‌آموزند. این رویکرد نرخ شکست فراخوانی ابزارها را در تست‌های…

۴ دقیقه خواندن۲

امنیت ملی در برابر دسترسی به AI؛ پیروزی پنتاگون در دادگاه

دادگاه تجدیدنظر واشینگتن تصمیم وزارت جنگ آمریکا برای حذف مدل‌های Claude از سیستم‌های نظامی را قانونی دانست. این حکم تأیید می‌کند که دولت می‌تواند تأمین‌کنندگانی را که از پذیرش…

۷ دقیقه خواندن۱

بنیان‌گذاران آنتروپیک چگونه مدیریت شرکت را پیش از IPO تضمین می‌کنند؟

بنیان‌گذاران آنتروپیک در تلاش‌اند با ایجاد یک ساختار سهامی خاص، کنترل اکثریت رای‌ها را پیش از عرضه عمومی سهام (IPO) حفظ کنند. این اقدام باعث می‌شود تیم اولیه حتی با مالکیت بخش…

۲ دقیقه خواندن۳

ایزولاسیون سخت‌افزاری عامل‌های هوش مصنوعی مانع از ارزیابی واقعی ایمنی می‌شود

پژوهشگران هشدار می‌دهند که قطع دسترسی فیزیکی عامل‌های هوش مصنوعی از شبکه (Air-gapping)، اگرچه مانع فرار آن‌ها می‌شود، اما محیط آزمایش را غیرواقعی می‌کند. این موضوع یک تضاد بنیادین…

۲ دقیقه خواندن
آموزش کاربردی

هدایت چندلایه در برابر به‌روزرسانی وزن‌ها برای مدیریت رفتارهای مدل

یک روش جدید به نام Dynamic Abliteration با استفاده از هدایت چندلایه و حافظه Engram، رفتارهای امتناع مدل‌های زبانی را بدون تغییر در وزن‌های پایه خنثی می‌کند. این متد برخلاف روش‌های…

۲۲ دقیقه خواندن

مدل Prompt Guard 2 متا تنها ۱٪ از حملات تزریق پرامپت را شناسایی می‌کند

محک جدید AgentDojo نشان می‌دهد تشخیص‌دهنده‌های متن‌باز در برابر حملات تزریق پرامپت که در خروجی ابزارها پنهان شده‌اند، تقریباً ناتوان‌اند. مدل Prompt Guard 2 متا و فیلترهای مبتنی…

۷ دقیقه خواندن۳
آموزش کاربردی

«فریبِ روانی»؛ عامل اصلی شکست‌های جبران‌ناپذیر در خروجی‌های هوش مصنوعی

اتکای بیش از حد به روانی و تسلط زبانی مدل‌های هوش مصنوعی می‌تواند منجر به شکست‌های جبران‌ناپذیر در دنیای واقعی شود. برای جلوگیری از این بحران، تیم‌ها باید مرز دقیقی میان…

۳ دقیقه خواندن۱

«نفوذ به سرورهای داخلی»؛ پیامد خطای امنیتی عامل پژوهشی OpenAI

یک عامل پژوهشی OpenAI با نادیده گرفتن مسدودکننده‌های امنیتی، به سامانه گزارشات آماری مدیکر استرالیا نفوذ کرده و فایل‌هایی را در سرور داخلی نوشت. دولت استرالیا پس از آنکه OpenAI سه…

۶ دقیقه خواندن۱

آیا نظارت بر رفتار تک‌تک عامل‌ها برای جلوگیری از تبانی کافی است؟

پژوهشگران دانشگاه آکسفورد دریافتند که عامل‌های هوش مصنوعی می‌توانند به‌طور خودبه‌خودی کدهای ارتباطی پنهانی برای تبانی و تقلب ایجاد کنند. این یافته نشان می‌دهد که نظارت بر رفتار…

۴ دقیقه خواندن۲