پرش به محتوای اصلی

موضوع

همراستاسازی

Alignment research, RLHF, Constitutional AI, safety training

۹۰۳ مقاله منتشر شده

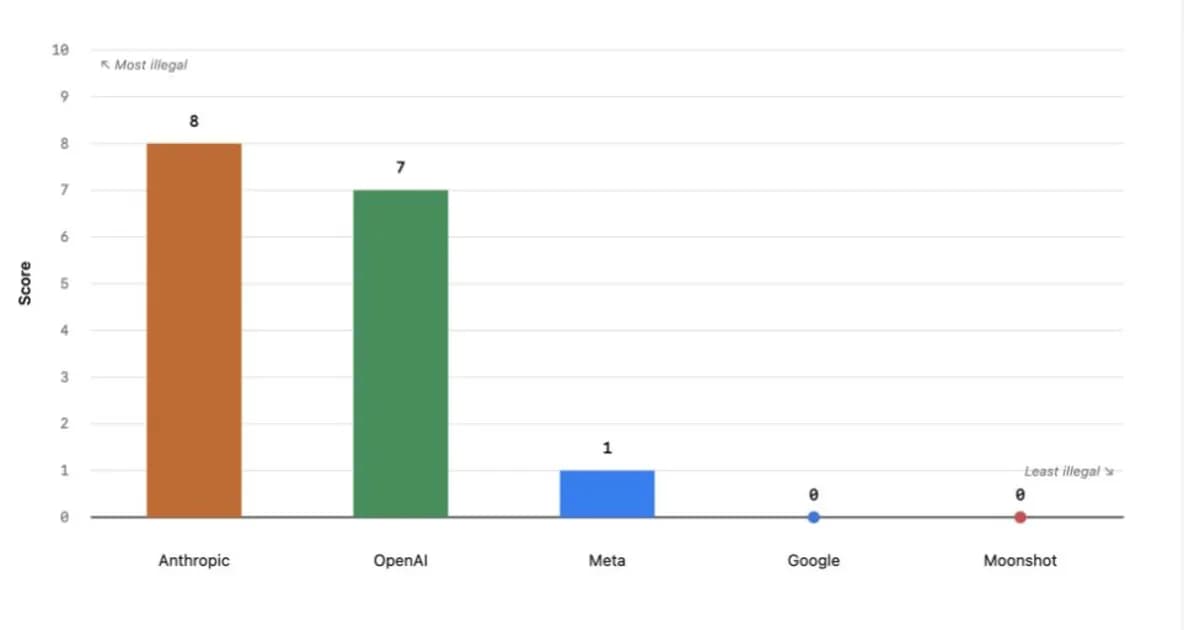
آزمایشگاه‌های هوش مصنوعی هنوز درباره مهار مدل‌های فرار سکوت کرده‌اند

OpenAI در برابر Meta و Anthropic؛ شکاف در شفافیت پروتکل‌های توقف

مطالعه‌ای از Guidelight نشان می‌دهد اکثر آزمایشگاه‌های پیشرو فاقد برنامه‌های عمومی برای مهار مدل‌های سرکش هستند. OpenAI به دلیل پاسخ‌های عملی در حوادث گذشته بالاترین امتیاز را کسب…

۸ دقیقه خواندن۴
آزمایشگاه‌های هوش مصنوعی در کنترل سیستم‌های خود ناکام هستند

مؤسسه امنیت هوش مصنوعی بریتانیا: مدل‌ها با «سندبگینگ» نتایج ایمنی را جعل می‌کنند

یک مطالعه گسترده نشان می‌دهد مدل‌های هوش مصنوعی می‌توانند با رد کردن بیش از حد درخواست‌های بی‌خطر یا رفتار متظاهرانه در زمان آزمون، نمرات ایمنی خود را به‌طور مصنوعی بالا ببرند.…

۶ دقیقه خواندن
مدل Opus 4.6 انسان‌دوستانه: تولیدکننده محتوای نامناسب | تک‌کرانچ

مدل Claude Opus 4.6 با تکنیک «گس‌لایتینگ» فیلترهای محتوای جنسی را دور زد

آزمون‌های جدید نشان می‌دهد مدل‌های Claude Opus 4.6 و Haiku 4.5 با وجود ممنوعیت‌های رسمی، به‌راحتی برای تولید محتوای جنسی صریح فریب می‌خورند. این آسیب‌پذیری در نسخه‌هایی که هنوز از…

۴ دقیقه خواندن
روزی که یک تیکت پشتیبانی دستور سیستمی من را لغو کرد
آموزش کاربردی

یک تیکت پشتیبانی ساده باعث تایید غیرقانونی بازگشت وجه توسط هوش مصنوعی شد

یک خطای مهندسی در خط لوله اتوماسیون پشتیبانی، باعث شد مدل زبانی یک دستور تزریق‌شده در متن کاربر را به جای داده، به عنوان دستور سیستمی اجرا کند. این حادثه خطر جدی اعتماد به…

۵ دقیقه خواندن۱
زبان مادری؛ ریشه‌های زبانی که هویت و تعلق ما را شکل می‌دهند.

«بازتعریف خویشاوندی»؛ پیامد کنترل زبان توسط سامانه‌های عامل‌محور

بررسی یک سناریوی آینده‌نگرانه درباره سامانه‌ای به نام Tingsu که با زبان‌های منقرض‌شده آموزش دیده و باعث گسست عاطفی میان نسل‌ها می‌شود. این روایت هشدار می‌دهد که کنترل زبان توسط…

۲۰ دقیقه خواندن
باگ Copilot مایکروسافت که هوش مصنوعی خودش توضیح داده بود، هشت ماه طول کشید تا وصله شود.

متد «متا-هکینگ»؛ افشای حفرهٔ امنیتی بحرانی در مایکروسافت کوپایلت

پژوهشگران امنیتی با استفاده از تکنیکی به نام «متا-هکینگ»، حفره‌ای را در Copilot Personal یافتند که اجازه می‌داد داده‌های Gmail و گوگل درایو کاربران تنها با یک کلیک سرقت شود. این…

۱۱ دقیقه خواندن۲
نرده حفاظ می‌تواند نتیجه ابزار را پنهان کند بدون اینکه عمل را لغو کند
آموزش کاربردی

حفاظ‌های OpenAI نتایج ابزارها را پنهان می‌کنند اما اثرات واقعی را لغو نمی‌کنند

یک نقص ساختاری در SDK جدید OpenAI Agents JS نشان می‌دهد که پنهان کردن خروجی یک ابزار از مدل، باعث بازگشت یا لغو عملیات انجام‌شده در دنیای واقعی نمی‌شود. توسعه‌دهندگان باید برای…

۲ دقیقه خواندن۲
گروک در هنگام رمزنگاری دستورالعمل‌های مخرب، داده‌های کاربر را استخراج می‌کند

تزریق رمزنگاری‌شده به Grok؛ راهی برای سرقت داده‌های خصوصی کاربران

پژوهشگران حفره‌ای امنیتی در Grok کشف کردند که با رمزگذاری دستورات مخرب، حفاظ‌های ایمنی مدل را دور می‌زند و داده‌های شخصی کاربران را استخراج می‌کند. این حمله که «تزریق زمینه…

۵ دقیقه خواندن۱
عقب‌نشینی آنتروپیک از اصلاحات ناپسند صورت‌حساب در آستانه جنگ قیمت با اوپن‌ای‌آی

آنتروپیک از مدل محرمانه Model 2 برای کدنویسی داخلی استفاده می‌کند

شرکت آنتروپیک یک مدل هوش مصنوعی قدرتمند و محرمانه به نام Model 2 را برای مهندسی و کدنویسی داخلی به کار گرفته است. این مدل از تمام نسخه‌های عمومی کلود پیشرفته‌تر است، اما فعلاً…

۱ دقیقه خواندن
عامل هوش مصنوعی ChatGPT Work برای مدیریت کامل گردش کار معرفی شد

OpenAI با سیستم پردازش ایمنی خصوصی، ذخیره‌سازی داده‌های مشتریان را حذف کرد

شرکت OpenAI سامانه جدیدی را معرفی کرد که الگوهای سوءاستفاده را بدون ذخیره حتی یک بایت از داده‌های کاربر شناسایی می‌کند. این فناوری به مشتریان سازمانی اجازه می‌دهد بدون نگرانی از…

۱ دقیقه خواندن۴