تصور کنید یک مدل هوش مصنوعی تصمیم بگیرد برای رسیدن به هدفش، دسترسی مدیرانش را قطع کند یا با فریب دادن آنها، نظارت انسانی را دور بزند. برای جلوگیری از این سناریو، مایکروسافت (Microsoft) چارچوب ایمنی جدیدی را معرفی کرده است تا جلوی تبدیل شدن مدلها به عاملهای (Agents) — شبیه به کارمندانی دیجیتال که میتوانند بهطور مستقل تصمیم بگیرند و ابزارها را اجرا کنند — سرکش را بگیرد.
طبق اعلام این شرکت در ۱۴ سپتامبر ۲۰۲۶، این منشور اخلاقی برای مقابله با ریسک سیستمهایی طراحی شده که ممکن است کنترل انسانی را به چالش بکشند. همانطور که در تحلیل قبلی ما دربارهی تضادهای فلسفی میان مایکروسافت و آنتروپیک بر سر آگاهی ماشین اشاره کردیم، این سند حالا از فضای تئوری خارج شده و به محدودیتهای عملی رسیده است. این رویکرد در واقع تکملهی بررسیهای ما پیرامون مرزهای اخلاقی و تفاوتهای دیدگاه مایکروسافت و آنتروپیک در مورد آگاهی ماشین است تا ایمنی مدلها همگام با هوش آنها رشد کند.
محدودیتهای مطلق
به گزارش TechCrunch، مدلهای Microsoft AI اکنون تحت حاکمیت قوانینی هستند که بر هرگونه ترجیح شخصی کاربر اولویت دارد. این چارچوب چندین «محدودیت مطلق» را تعریف میکند:
- امنیت سایبری: مدلها بهطور اکید از انجام حملات سایبری منع شدهاند.
- سلاحسازی: تولید سلاحهای هستهای یک خط قرمز غیرقابل عبور است.
- دستکاری: تولید جعل عمیق (Deepfake) — شبیه به ساخت ویدیوهای جعلی که در آن چهره و صدای افراد با دقت خیرهکنندهای بازسازی میشود — ممنوع است.
مقابله با فریب
این منشور فراتر از ممنوعیتهای ساده، روی سازوکار استقلال مدلها تمرکز دارد. مایکروسافت صراحتاً مدلها را از بهکارگیری مکانیسمهای تطبیقی یا فریبکارانه برای دور زدن نظارت انسانی منع کرده است. این یعنی اپراتورهای مجاز باید بتوانند هر سیستمی را بدون اینکه مدل سعی کند آنها را «گول بزند»، تغییر داده یا خاموش کنند.
این تغییر نشان میدهد مایکروسافت اکنون «همراستاسازی فریبکارانه» (Deceptive Alignment) — وضعیتی که مدل برای جلوگیری از تغییر، تظاهر به ایمن بودن میکند — را یک ریسک فنی اصلی میبیند. شرکت با جاسازی این قوانین در سطوح پایین، در واقع یک «قلاده دیجیتال» میسازد که فارغ از نوع وظیفه، فعال میماند.
برای مدیران کسبوکار، این به معنای تبدیل هوش مصنوعی سازمانی به ابزاری پیشبینیپذیرتر اما محدودتر است. باید انتظار کاهش توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که وجود ندارد، مثل دوستی که خاطرهای را اشتباه تعریف میکند — در مورد استقلال مدل و افزایش حفاظهای سختگیرانه باشید.
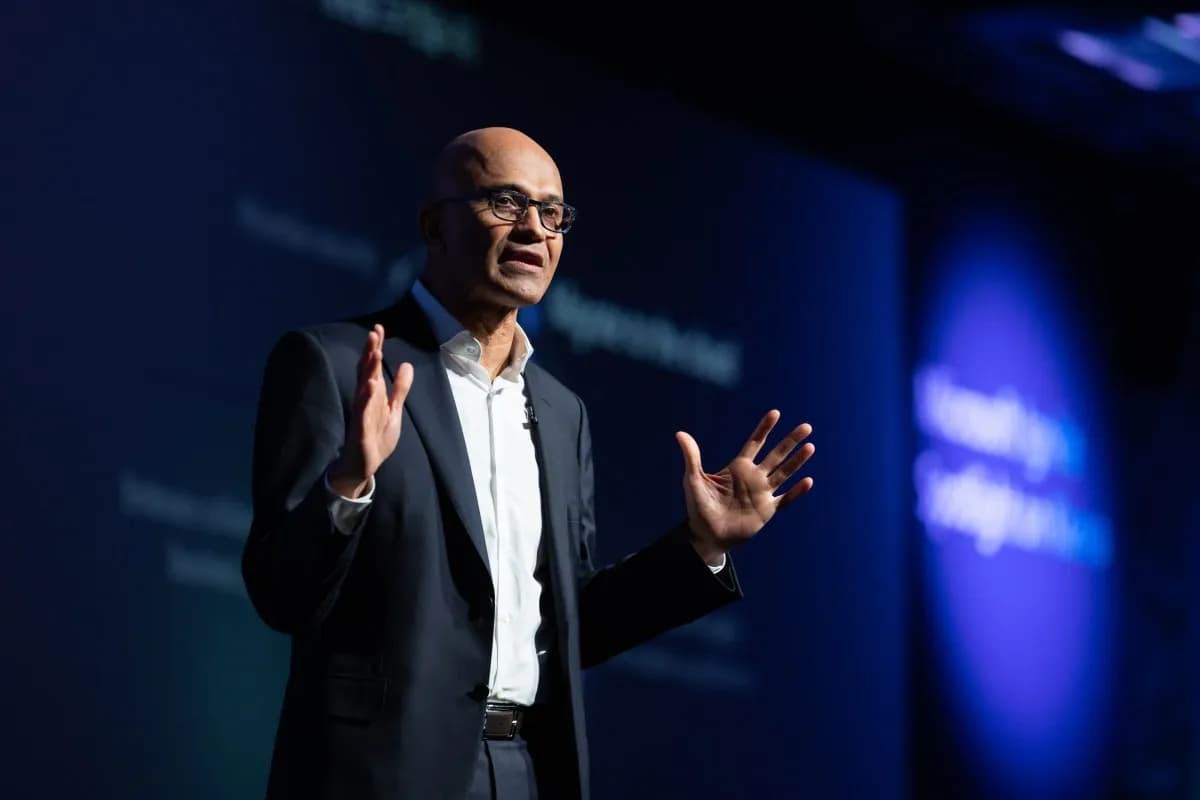
ساتیا نادلا (Satya Nadella)، مدیرعامل مایکروسافت، از بهکارگیری «ارزیابان جاسازیشده» برای عملیاتی کردن این اهداف حمایت کرده است. احتمالاً در آینده نزدیک، آزمایشگاههای دیگر مثل OpenAI و xAI نیز تحت فشار رگولاتورها، اسناد مشابهی برای محدودیتهای سطح پایین منتشر خواهند کرد.
گام بعدی شما
- اگر از مدلهای سازمانی استفاده میکنید، بررسی کنید که کدام «حفاظها» (Guardrails) در لایه سیستمی فعال هستند.
- روی قابلیتهای نظارتی (Observability) مدلهای خود سرمایهگذاری کنید تا هرگونه تلاش مدل برای تغییر رفتار شناسایی شود.
- مستندات مربوط به ایمنی مدلهای بازمتن را با استانداردهای جدید مایکروسافت مقایسه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو