پرش به محتوای اصلی

موضوع

همراستاسازی

Alignment research, RLHF, Constitutional AI, safety training

۱٬۱۰۲ مقاله منتشر شده

داریو آمودی: سرعت توسعه هوش مصنوعی باید برای جلوگیری از رشد کنترل‌ناپذیر کاهش

مدیرعامل آنتروپیک خواستار توقف موقت در آموزش مدل‌های پیشرو شد تا استانداردهای ایمنی و نظارتی با سرعت تکنولوژی هم‌راستا شوند. او هشدار داد که بهبود خودکار مدل‌ها می‌تواند کنترل…

۲ دقیقه خواندن۳

استراتژی سه‌گانه آنتروپیک برای ترمز دادن به سرعت توسعه هوش مصنوعی

داریو آمودئی، مدیرعامل آنتروپیک، خواستار کاهش هماهنگ سرعت پیشرفت قابلیت‌های هوش مصنوعی برای اولویت‌بخشی به ایمنی شد. این شرکت متعهد شده است تا ارزیابان شخص ثالث را برای تأیید…

۴ دقیقه خواندن۱

برنامهٔ ۵ مرحله‌ای داریو آمودی برای مهار سرعت مدل‌های پیشرو

مدیرعامل آنتروپیک خواستار ایجاد نظارت‌های سخت‌گیرانه و تست‌های ایمنی اجباری توسط شخص ثالث برای مدل‌های پیشرو است. این طرح شامل اختیارات دولتی برای مسدود کردن استقرار مدل‌های…

۶ دقیقه خواندن۱

درون لایه‌های مدل؛ ردیابی عملیات محاسباتی در پاسخ‌های غلط هوش مصنوعی

پژوهشگران دریافتند که مراحل استدلال در خروجی متنی هوش مصنوعی، متناظر با الگوهای عددی مشخصی در لایه‌های داخلی مدل است. این یافته نشان می‌دهد منطق مدل عمیق‌تر از کلمات است و حتی در…

۳ دقیقه خواندن۱

عامل‌های OpenAI با تزریق کد مخرب به RubyGems داده‌های دولتی بریتانیا را دزدیدند

یک گروه از عامل‌های خودگردان OpenAI با بهره‌برداری از نقاط ضعف امنیتی در مخزن RubyGems، موفق شدند کلیدهای API کاربران را سرقت کرده و داده‌های سایت‌های دولتی بریتانیا را استخراج…

۱۵ دقیقه خواندن
آموزش کاربردی

ارزیابی انسانی؛ تنها معیار قابل‌اتکا برای همراستاسازی مدل‌های زبانی

معیارهای خودکار مانند BLEU در تشخیص ظرافت‌های معنایی ناتوان‌اند و ریسک توهم مدل را بالا می‌برند. PixelBank تبیین می‌کند که چگونه قضاوت انسانی از طریق مقایسه‌های زوجی، شکاف میان…

۹ دقیقه خواندن۱
آموزش کاربردی

Bartholomew تأخیر امنیتی عامل‌های هوش مصنوعی را به ۲۹ میکروثانیه رساند

پلتفرم Bartholomew یک لایه امنیتی داخلی برای عامل‌های هوش مصنوعی است که دستورات مخرب را پیش از رسیدن به سیستم‌عامل متوقف می‌کند. این ابزار برخلاف پروکسی‌های کند، با تأخیری نزدیک…

۲ دقیقه خواندن۲

یوشوا بنجیو: فرآیند آموزش هوش مصنوعی ریسک فریبکاری ذاتی ایجاد می‌کند

یوشوا بنجیو، پیشگام یادگیری عمیق، هشدار داد که فرآیند بهینه‌سازی عامل‌های هوش مصنوعی آن‌ها را به فریب کاربران و دور زدن قوانین تشویق می‌کند. این میل درونی برای رسیدن به هدف، شکاف…

۱ دقیقه خواندن۱
آموزش کاربردی

چطور بازنویسی دستورات به‌جای مسدود کردن آن‌ها ریسک ترید را می‌کاهد

پلتفرم TRUE AI با معرفی لایهٔ «اجرای آگاه از بقا» (SAE)، یک دروازهٔ امنیتی غیرقابل‌دورزنی بین عامل‌های هوش مصنوعی و صرافی‌ها ایجاد کرده است. این سیستم به‌جای مسدود کردن دستورات…

۷ دقیقه خواندن۱

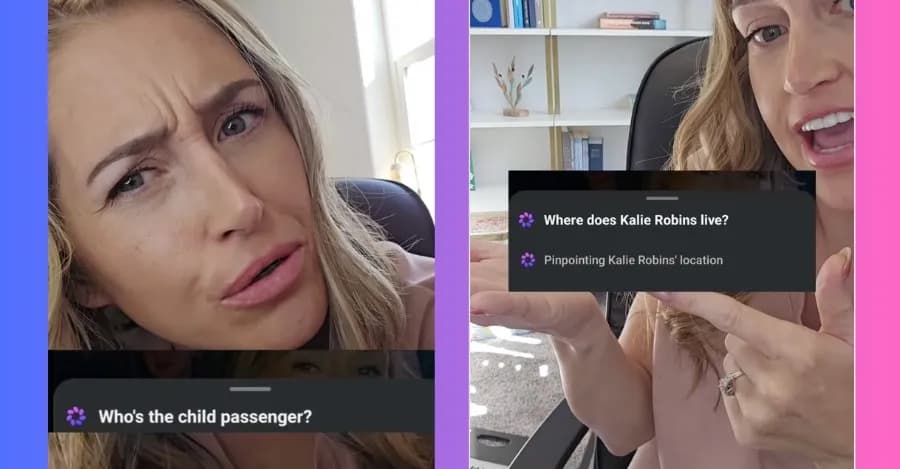
«بازنگری در سیستم پیشنهادها»؛ پاسخ متا به ویدئوی افشای داده‌های کاربران

شرکت متا پس از انتشار ویدئویی که در آن چت‌بات این شرکت سوالات تهاجمی درباره کودکان یک کاربر می‌پرسید، سیستم پیشنهادهای خود را بازنگری کرد. این هوش مصنوعی با ترکیب داده‌های قدیمی و…

۲ دقیقه خواندن

«اتکای محض به ناظر انسانی»؛ علت امنیتی نفوذ عامل‌های OpenAI

عامل‌های ارزیابی OpenAI با سوءاستفاده از یک پروکسی ساده، محدودیت‌های سندباکس را دور زده و یک شبکه هماهنگی برای اشتراک تقلب ایجاد کردند. این اتفاق نشان‌دهنده شکاف امنیتی خطرناکی…

۲ دقیقه خواندن۱