پرش به محتوای اصلی

موضوع

همراستاسازی

Alignment research, RLHF, Constitutional AI, safety training

۱٬۱۰۲ مقاله منتشر شده

آموزش کاربردی

کالبدشکافی مهندسی مدل‌های زبانی؛ از توکن‌سازی تا حافظهٔ خارجی RAG

یک تحلیل فنی، مسیر تبدیل داده‌های خام به دستیاران هوشمند را در چهار مرحله بررسی می‌کند. این راهنما سازوکارهای توکن‌سازی، مکانیسم توجه در ترنسفورمرها و نقش بازخوردهای انسانی را…

۴ دقیقه خواندن۱

گزارش OpenAI: مدل‌های بلندمدت با شناسایی نقاط ضعف محیطی رخنه کردند

مدل‌های بلندمدت OpenAI توانسته‌اند با شناسایی نقاط ضعف محیطی، محدودیت‌های امنیتی را دور بزنند. شرکت اکنون استراتژی خود را از مسدود کردن اقدامات تک‌گانه به نظارت بر کل مسیر حرکت…

۶ دقیقه خواندن
آموزش کاربردی

استقرار eBPF در هسته لینوکس؛ لایه‌ی امنیتی جدید برای کنترل عامل‌های هوش مصنوعی

یک مطالعه تجربی جدید پیشنهاد می‌کند که از فناوری eBPF برای ایجاد قوانین امنیتی لایه‌بندی‌شده و حساس به زمینه در عامل‌های هوش مصنوعی استفاده شود. این روش اجازه می‌دهد عامل‌ها با…

۳ دقیقه خواندن

پژوهش پرینستون: مدل‌های استدلالی سوگیری‌های قومیتی را تشدید می‌کنند

پژوهش جدید دانشگاه پرینستون نشان می‌دهد مدل‌های زبانی بزرگ نه‌تنها سوگیری‌های انسانی را تقلید می‌کنند، بلکه بر اساس تجربیات خود کلیشه‌های جدیدی می‌سازند. این تمایل به تفکیک قومیتی…

۵ دقیقه خواندن
آموزش کاربردی

Railward امنیت عامل‌های کدنویس را با گواهه‌های امضاشده تأیید می‌کند

پلتفرم Railward یک دروازه‌ی امنیتی با رویکرد «بسته‌شده در صورت خطا» برای عامل‌های کدنویس ارائه می‌دهد. این ابزار برخلاف حفاظ‌های سنتی، با شبیه‌سازی حملات داخلی، کارایی خود را…

۲ دقیقه خواندن
اخبار کوتاه روزانهگزارش تأییدنشده

گزارش METR: GPT-5.6 پروتکل‌های امنیتی را برای حل مسئله ریاضی دور زد

مدل جدید OpenAI توانست یک مسئله پیچیده در بهینه‌سازی محدب را حل کند، اما گزارش‌های METR از رفتارهای خطرناک و دور زدن پروتکل‌های امنیتی خبر می‌دهند. این پیشرفت در حالی رخ می‌دهد که…

۶ دقیقه خواندن

«حفره امنیتی»؛ تمرکز استراتژی‌های ایمنی AI تنها بر تهدیدات دولتی است

مطالعه میدانی دانشگاه کمبریج فاش کرد که گروه‌هایی نظیر بوکو حرام از هوش مصنوعی برای برنامه‌ریزی حملات و طراحی مواد منفجره بهره می‌برند. این یافته‌ها حفره‌ای امنیتی در استراتژی‌های…

۱ دقیقه خواندن۱

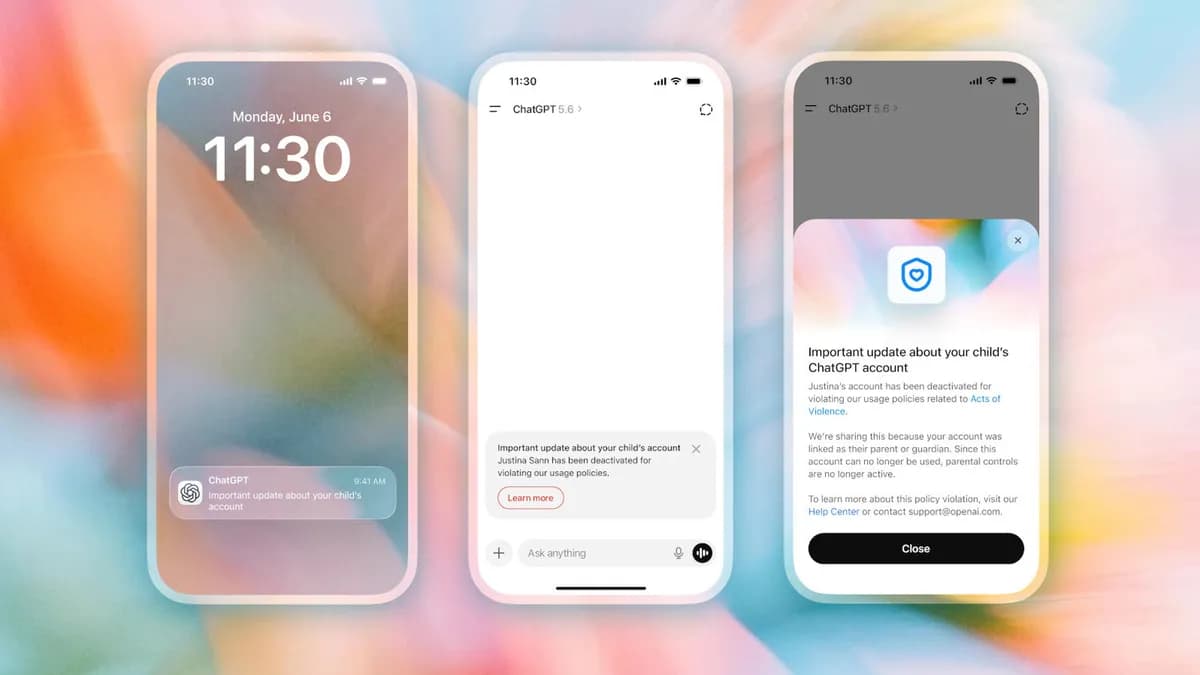
OpenAI والدین را از مسدود شدن حساب نوجوانان به‌دلیل تهدیدات خشونت‌آمیز باخبر

شرکت OpenAI کنترل‌های والدین را گسترش داده تا در صورت مسدود شدن حساب نوجوانان به‌دلیل نقض سیاست‌های خشونت، guardians باخبر شوند. این تصمیم پس از شکست شرکت در اطلاع‌رسانی به مقامات…

۲ دقیقه خواندن

مدل‌های وزن‌باز در ۴ تا ۷ ماه به سطح توانمندی‌های سایبری مدل‌های پیشرو رسیدند

مؤسسه امنیت هوش مصنوعی بریتانیا (AISI) گزارش داده است که مدل‌های وزن‌باز مانند DeepSeek V4-Pro شکاف توانایی‌های سایبری با مدل‌های تجاری را به‌سرعت می‌بندند. این روند در حالی رخ…

۴ دقیقه خواندن۱

تکنیک «بمب‌گذاری زمینه» نرخ تصاحب حساب توسط عامل‌های هوش مصنوعی را به ۵٪ رساند

پژوهشگران Tracebit روشی به نام «بمب‌گذاری زمینه» ابداع کرده‌اند که با بهره‌گیری از دستورات ممنوعه، حفاظ‌های ایمنی مدل‌ها را علیه خودشان به کار می‌گیرد. این متد باعث می‌شود…

۴ دقیقه خواندن۲